
可观测性与稳定性 / 系统课时
分片太多为什么拖慢集群
分片太多为什么拖慢集群
Elasticsearch 的分片不是越多并行度就越高。每个分片都是独立的 Lucene 索引,需要占用堆内存、文件句柄和集群管理资源;查询还要在多个分片之间分发和汇总。本节从资源成本出发识别过量小分片,并给出可验证的治理思路。
学习目标
- 解释过量小分片为什么会增加集群和查询开销
- 使用 Elasticsearch API 检查分片数量与实际大小
- 根据数据增长和保留策略识别需要重新规划分片的信号
分片不是免费的并行单元
一个索引被划分为多个主分片后,每个主分片以及它的副本都对应独立的 Lucene 索引。分片会维护段、文件和相关内存结构,节点还必须跟踪这些分片的状态。
当日志索引数量持续增长,同时每个索引又配置较多主分片时,很容易出现大量只有几百 MB 或几 GB的小分片。此时数据总量可能并不大,但集群需要管理的对象数量已经很高。
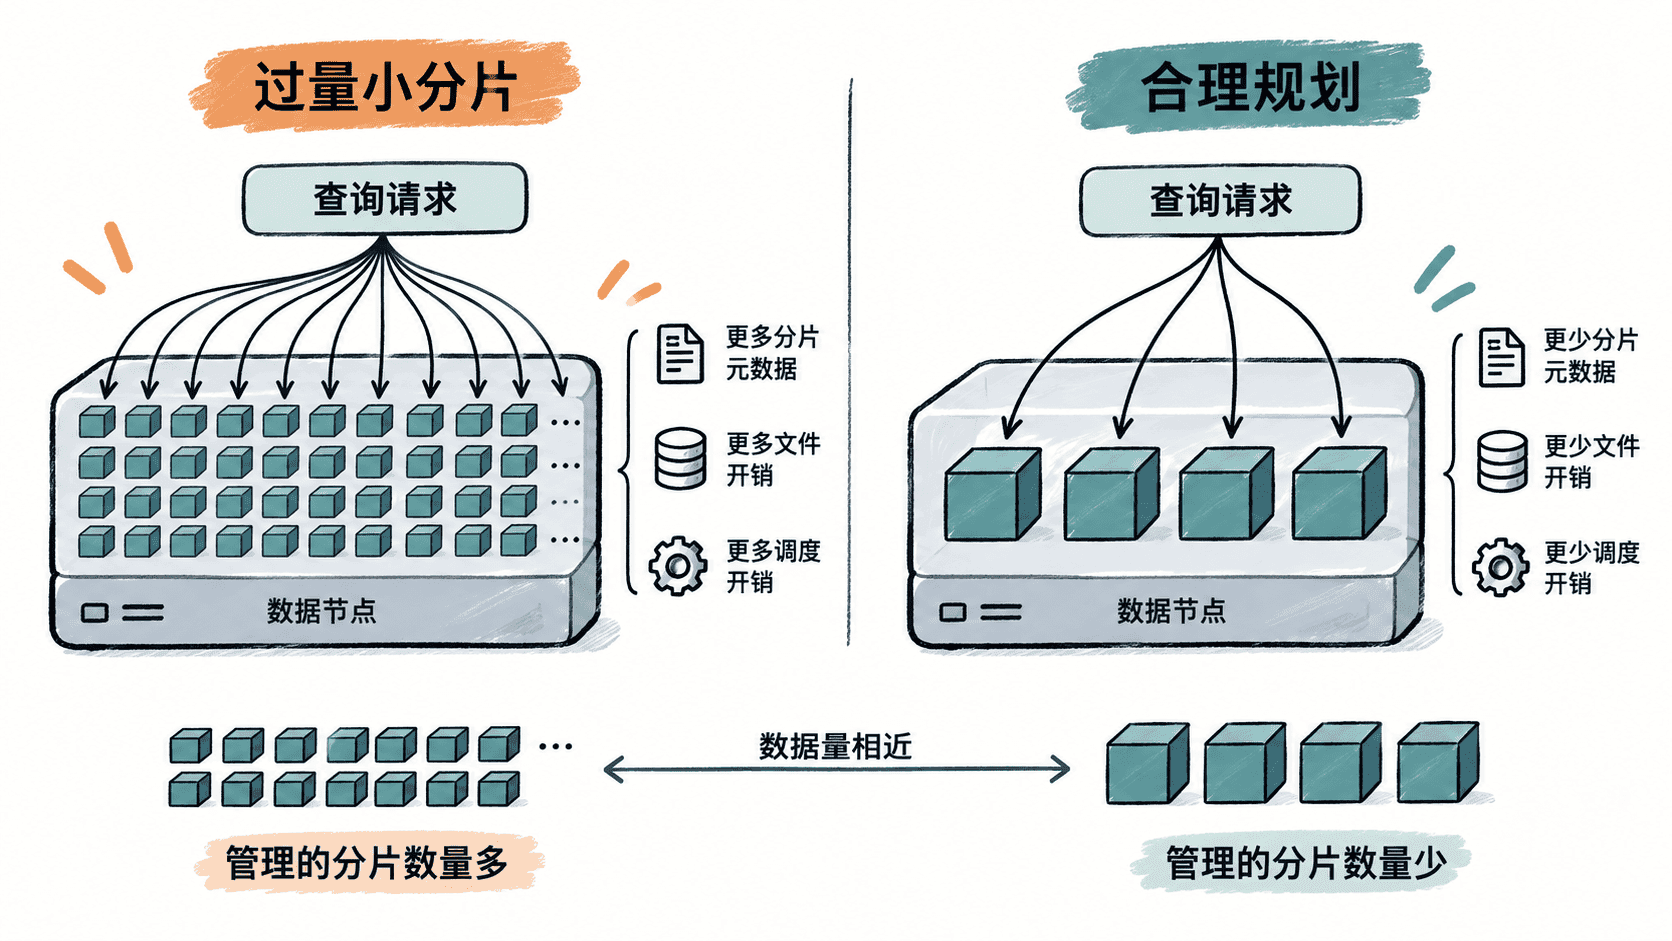
过量分片的代价会同时出现在数据节点和集群管理层面。分片越多,需要维护的元数据越多;搜索请求命中大量分片时,还会产生更多分片级任务以及最终结果归并工作。
查询为什么会被小分片拖慢
一次搜索通常会被发送到所有相关分片,各分片执行局部查询后再汇总结果。如果同样的数据被切成大量小分片,协调节点就需要处理更多分片级请求。
例如,一个查询覆盖 30 个按天索引,每个索引有 1 个主分片时主要涉及 30 个主分片;如果每个索引配置 5 个主分片,则同一范围会涉及 150 个主分片。增加的不是业务数据量,而是任务调度和结果协调数量。
先检查分片数量和大小
排查时不要先猜应该配置多少分片,而是查看当前分片分布。_cat/shards 可以直接列出每个分片的状态和存储大小:
curl -s "http://<HOST>:<PORT>/_cat/shards?v&h=index,shard,prirep,state,docs,store,node&s=store:asc"预期输出取决于实际集群,结构类似:
index              shard prirep state   docs store  node
logs-app-<ID>      0     p      STARTED <ID> <SIZE> <NODE>
logs-app-<ID>      0     r      STARTED <ID> <SIZE> <NODE>
p 表示主分片,r 表示副本。排序后如果长期看到大量尺寸很小的日志分片,就应继续检查索引创建频率、主分片数量以及保留周期,而不是只处理某一个索引。
还可以按节点观察分片数量:
curl -s "http://<HOST>:<PORT>/_cat/allocation?v&h=node,shards,disk.indices,disk.used,disk.avail,disk.percent"预期输出中的节点名和数值会随集群变化:
node    shards disk.indices disk.used disk.avail disk.percent
<NODE>  <ID>   <SIZE>       <SIZE>    <SIZE>     <ID>
这一步用于判断分片是否大量集中在某些节点,并同时观察索引数据与磁盘使用情况。不能仅凭 shards 一列就判断集群是否健康。
什么时候应该重新规划
值得治理的典型信号是:日志总数据量不大,却产生大量按小时或按天的小索引;模板中的主分片数明显高于实际写入规模;搜索覆盖多个周期索引后需要访问大量分片;或者集群管理操作在索引数量增长后越来越沉重。
治理方向通常是减少新索引不必要的主分片数,并让 rollover 根据实际数据规模形成更合理的索引边界。对于已经产生的历史小分片,还要根据是否继续写入、保留要求和查询方式选择 shrink、reindex 或生命周期调整,而不是直接修改已有索引的主分片数量。
分片规划的目标不是追求某个永久固定的“最佳分片大小”,而是避免数据规模与分片数量明显失衡。持续观察真实分片大小、查询扇出、节点资源和增长速度,再调整新索引策略,比机械套用一个分片数量公式更可靠。