
可观测性与稳定性 / 系统课时
磁盘持续暴涨怎么止损
磁盘持续暴涨怎么止损
线上 Elasticsearch 磁盘持续上涨时,先阻止继续写入的增长速度,再确认究竟是日志量、分片副本还是生命周期失控,最后清理可删除数据并恢复长期策略。核心不是立刻删文件,而是让每一步都有可验证的依据。
学习目标
- 能区分写入增量、分片与副本带来的磁盘增长
- 能在磁盘告警时按风险顺序执行止损、清理和验证
- 能检查 ILM、rollover 与保留周期,避免清理后再次暴涨
先确认磁盘到底在增长什么
Elasticsearch 的磁盘使用不能只看某个目录大小。日志持续写入、主分片数量、replica 副本、段文件和生命周期保留都会共同影响占用。生产排查时,先记录节点磁盘水位、索引大小、主副本规模和集群健康状态,再决定动作。
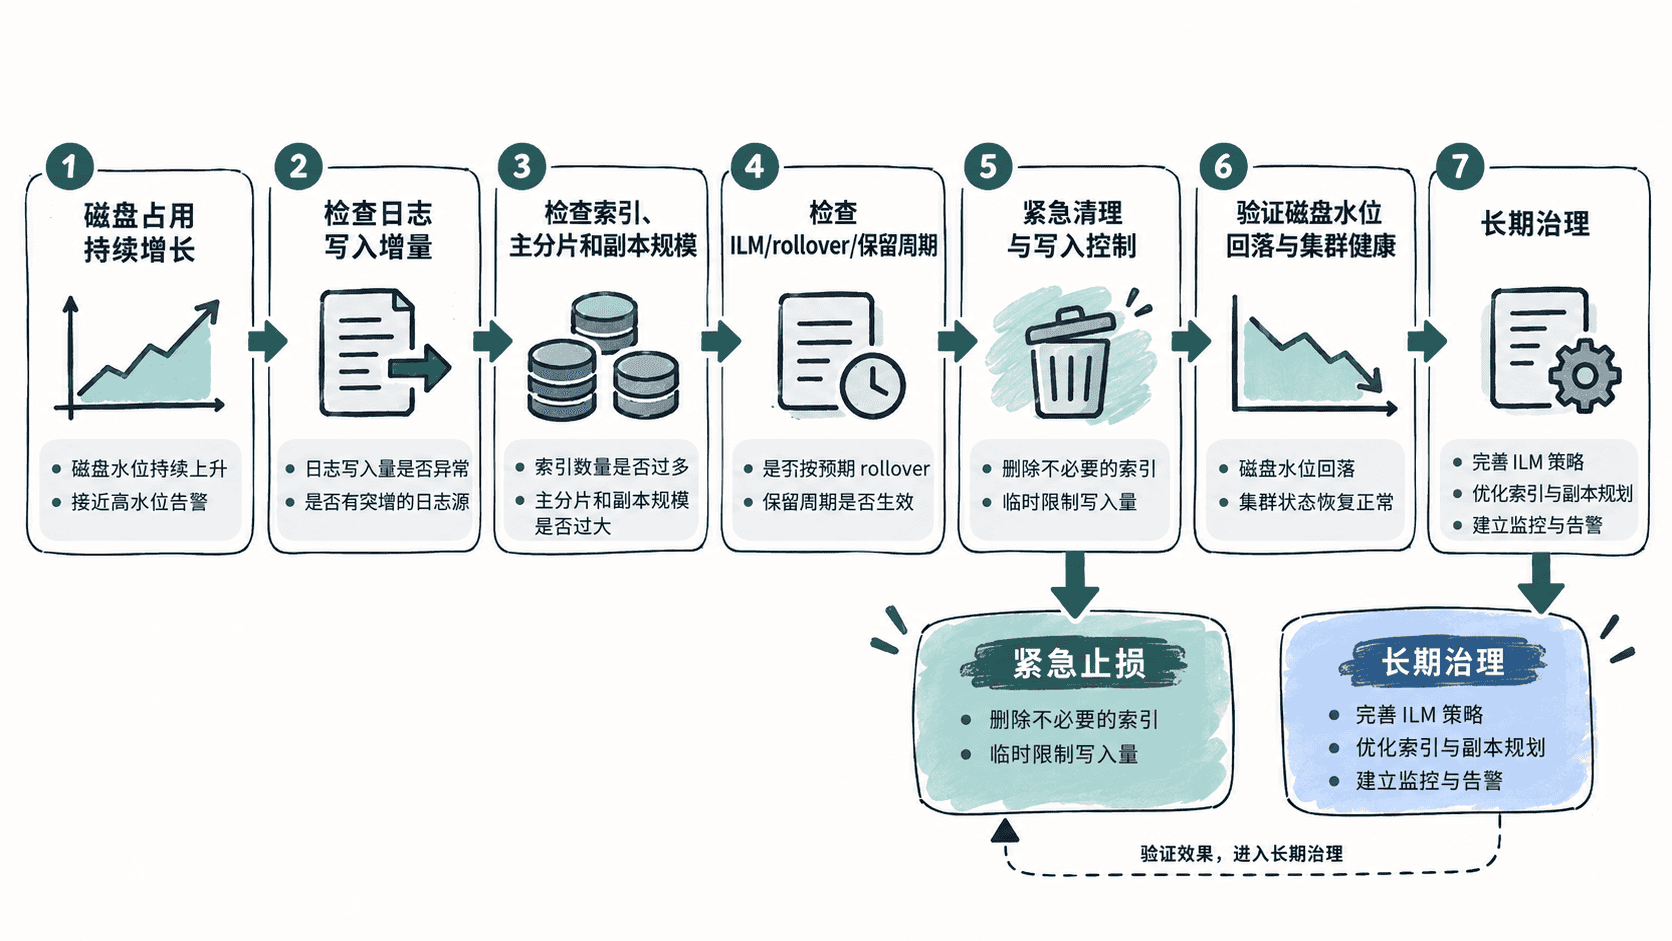
先用 _cat/health 和 _cat/shards 看集群与分片状态,再用 _cat/indices 判断哪些索引占用最大。下面示例只读数据,不会修改集群;实际地址、认证方式和返回时间会不同。
curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cat/health?v=true&format=json"

curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cat/indices?v=true&s=store.size:desc&bytes=gb"

curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cat/shards?v=true&h=index,shard,prirep,store,node"
预期输出
health API:返回 cluster health,包括 status、shards 和 unassigned 等字段。
indices API:按 store.size 从大到小列出索引,并显示主分片与文档相关信息。
shards API:列出索引分片、主副本标记 prirep、存储大小与所在节点。
如果某些索引占用增长与业务写入量同步,重点检查采集是否出现异常放量;如果写入量没有明显变化却持续增长,则进一步比较副本数、分片布局和保留周期。
紧急止损先控制增长速度
磁盘已经接近高水位时,第一目标是争取操作空间。不要先执行大范围删除,更不要直接删除 Elasticsearch 数据目录。磁盘水位会影响分片分配等行为,严重时索引可能进入写保护,因此应优先减少新的数据进入量,并避免让恢复过程进一步放大磁盘压力。
止损动作通常按业务影响从低到高推进:先暂停不必要的日志源、降低高噪声日志采集,再确认是否存在异常重试或重复写入。需要人工删除历史索引时,应先确认索引确实属于可清理范围,并保留名称清单与删除前的容量记录。
curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cat/indices?v=true&h=index,docs.count,store.size&s=store.size:desc"

curl -sS -u "$ES_USER:$ES_PASSWORD" \
  -X DELETE \
  "$ELASTICSEARCH_URL/<PATH>"
预期结果
第一条请求返回索引名称、文档数量和存储大小,可用于确认候选索引。
第二条请求在目标索引存在且权限满足时返回删除成功信息;删除会永久移除该索引的文档、分片和元数据。
这里的 <PATH> 只表示已经确认可以删除的具体索引路径,实际值必须替换为明确的目标索引名。删除前应确认它不是当前写入目标、没有业务查询依赖,也不违反保留和审计要求。
副本和生命周期为什么会放大占用
日志数据通常同时受主分片、副本和保留周期影响。一个简单估算可以写成:基础写入量 × 保留时间 × 副本倍数,再叠加索引自身的存储开销。比如副本从 0 增加到 1,数据副本数量会翻倍;保留从 7 天变成 30 天,也会显著扩大历史数据规模。
真正需要治理的是“持续写入却没有及时退出”的索引生命周期。ILM 可以在 hot 阶段按大小、年龄或文档数 rollover,并在后续阶段按策略删除过期索引;因此应检查当前写入索引是否正确绑定策略,以及删除阶段是否真的能到达。([Elastic][1])
curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_ilm/policy/<ID>"
预期结果
返回指定 ILM policy 的 JSON 配置,其中可看到 hot、warm、cold、delete 等阶段及其 actions。如果长期策略要求保留固定天数,应让 rollover、生命周期与实际业务写入目标形成连续链路,而不是只创建一个“看起来正确”的 policy。删除阶段确实执行时,旧索引才会最终释放磁盘空间。([Elastic][2])
清理后必须验证恢复
删除或减缓写入后,不能只看磁盘百分比。至少同时检查集群健康、未分配分片和磁盘占用趋势。green 表示全部分片已分配,yellow 表示主分片可用但存在未分配副本,red 表示有主分片未分配;因此磁盘回落并不等于集群已经恢复。([Elastic][3])
curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cluster/health?wait_for_status=yellow&timeout=30s"

curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cat/health?v=true"
预期结果
第一条请求在集群达到 yellow 或更高状态后返回健康信息;若超时仍未达到条件,会返回当前状态。
第二条请求可用于人工复核 status、shards、init 和 unassign 等字段。
最后记录“增长来源、采取动作、删除范围、磁盘变化、集群状态”五项证据。一次事故真正完成止损,不是磁盘数字暂时下降,而是增长源已经被控制,生命周期策略已经恢复,并且新的数据继续写入后仍保持可控趋势。