
可观测性与稳定性 / 系统课时
采集端字段和标签怎么补充
采集端字段和标签怎么补充
同一套 Elasticsearch 往往同时接收多个服务、环境和主机的日志。只采集原始消息会让后续检索、告警和路由缺少上下文。本节用 Filebeat processors 在采集端补充稳定字段,并验证事件是否真正携带这些信息。
学习目标
- 使用
add_fields为事件补充服务、环境等业务上下文 - 使用
add_host_metadata自动补充主机信息 - 判断哪些字段适合采集端统一添加,避免覆盖原始数据
在采集端补充稳定上下文
Filebeat 的 processor 可以在事件发送到 Elasticsearch 或 Logstash 之前修改事件。服务名、部署环境等在单个 Filebeat 实例中通常比较稳定,适合直接在采集端补充。
下面是片段示例,需要放入现有 filebeat.yml,并与实际 filebeat.inputs 和 output.* 配置配合使用:
processors:
  - add_fields:
      target: service
      fields:
        name: order-api
  - add_fields:
      target: labels
      fields:
        environment: production
  - add_host_metadata: ~
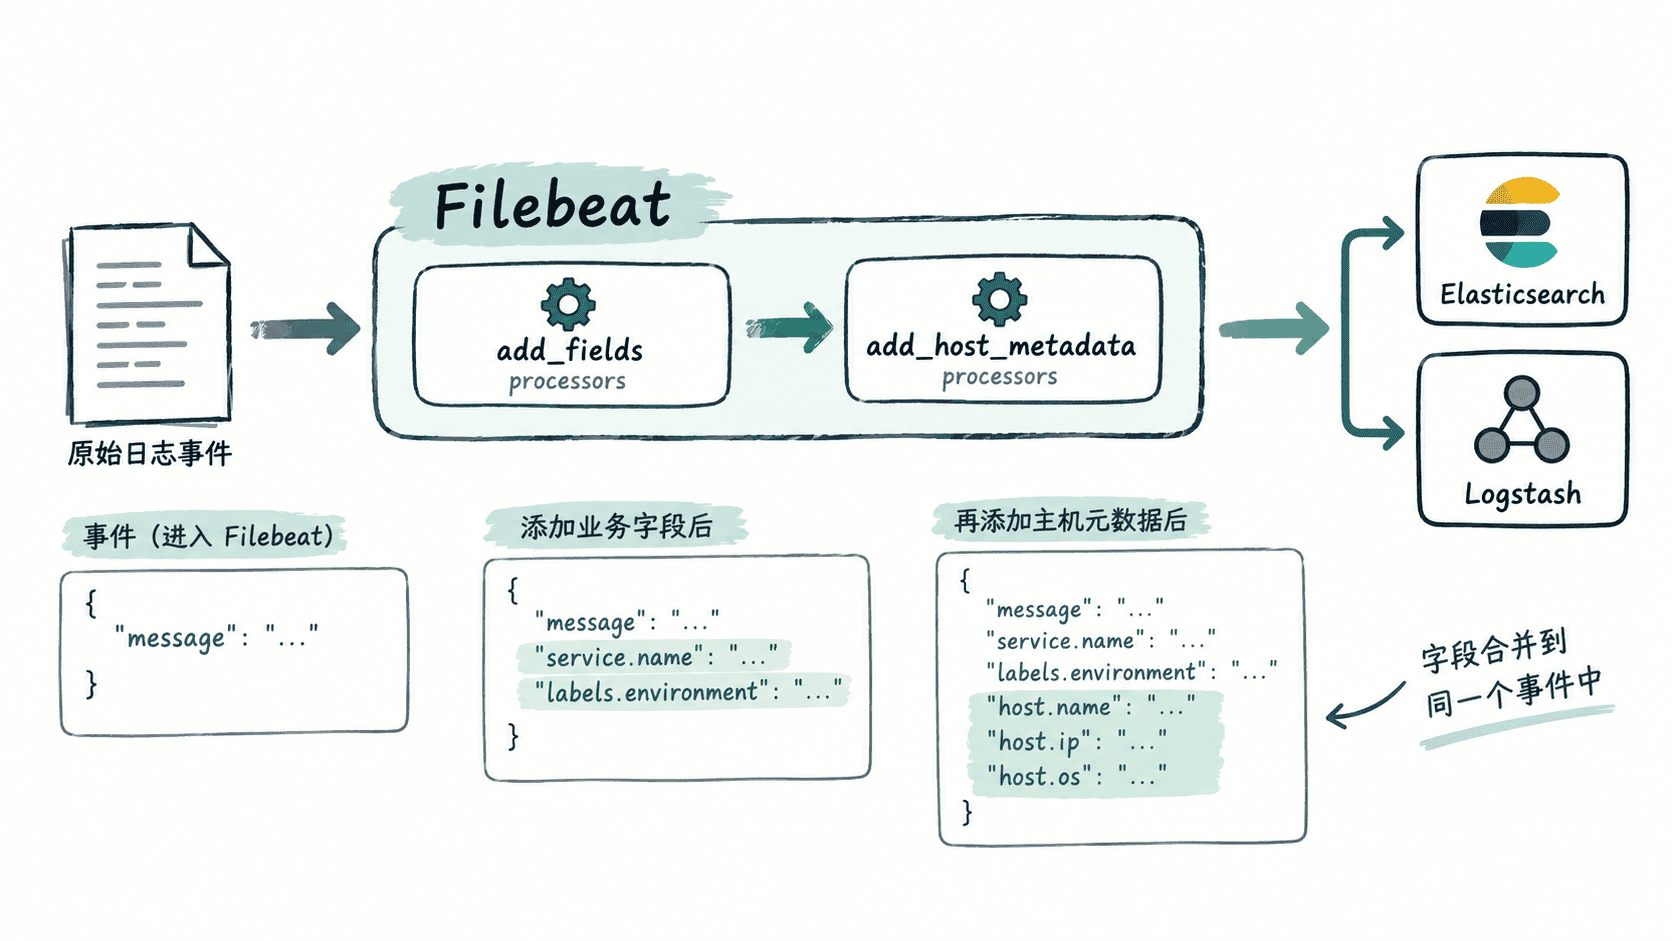
这里最终形成 service.name 和 labels.environment,而 add_host_metadata 会根据运行 Filebeat 的主机补充主机元数据。配置文件本身不会产生固定控制台输出,先执行配置检查:
filebeat test config -e预期输出
Config OK如果 Filebeat 通过容器运行,命令路径和执行方式可能不同,应在实际 Filebeat 运行环境中完成检查。
字段进入事件的过程
采集链路中同时存在原始日志字段、采集端静态上下文和自动探测的主机元数据。理解三类信息在哪里合并,有助于避免把业务字段误写进 message,也能明确后续 Logstash 和 Elasticsearch 收到的事件结构。
字段应该放在哪里
字段命名应尽量表达稳定含义。例如服务身份使用 service.name,部署环境可以使用 labels.environment。如果后续还有 Logstash、告警规则或索引路由,统一字段路径比随意增加 app、app_name、application 等多个同义字段更容易维护。
不要在采集端硬编码每条日志都会变化的值,例如请求 ID、用户 ID 或订单号。这些值通常应从日志内容解析得到。也要避免无意覆盖输入事件已有字段;修改共享配置前,应先确认当前事件结构和下游依赖。
验证字段而不是只验证配置
Config OK 只能证明配置能够被解析,不能证明最终事件符合预期。启动 Filebeat 并产生一条测试日志后,应在下游查看实际文档,确认 service.name、labels.environment 和需要的 host.* 字段已经出现。
如果字段没有出现,按“processor 是否位于有效配置层级 → 条件是否匹配 → Filebeat 是否重新加载配置 → 下游是否改写或删除字段”的顺序检查。采集端字段的价值不在于字段越多越好,而在于让每条事件具备稳定、可检索且能被下游可靠使用的上下文。