
可观测性与稳定性 / 系统课时
模拟节点故障验证恢复流程
模拟节点故障验证恢复流程
本课通过主动停止一个 Elasticsearch 节点,观察节点离线、分片异常、集群接管和节点恢复的完整链路,并用文档数量与分片状态验证数据是否保持完整。你会得到一套可重复执行的故障演练方法,而不是只看一条健康状态。
学习目标
- 能主动制造单节点离线并识别受影响的分片状态
- 能区分故障期间的接管过程与节点恢复后的回迁过程
- 能用可重复的检查项验证告警、恢复和数据完整性
先记录正常基线
故障演练前先保存集群健康、节点列表、分片状态和关键索引文档数。这样恢复后才有可比较的证据,而不是看到 green 就认为演练成功。
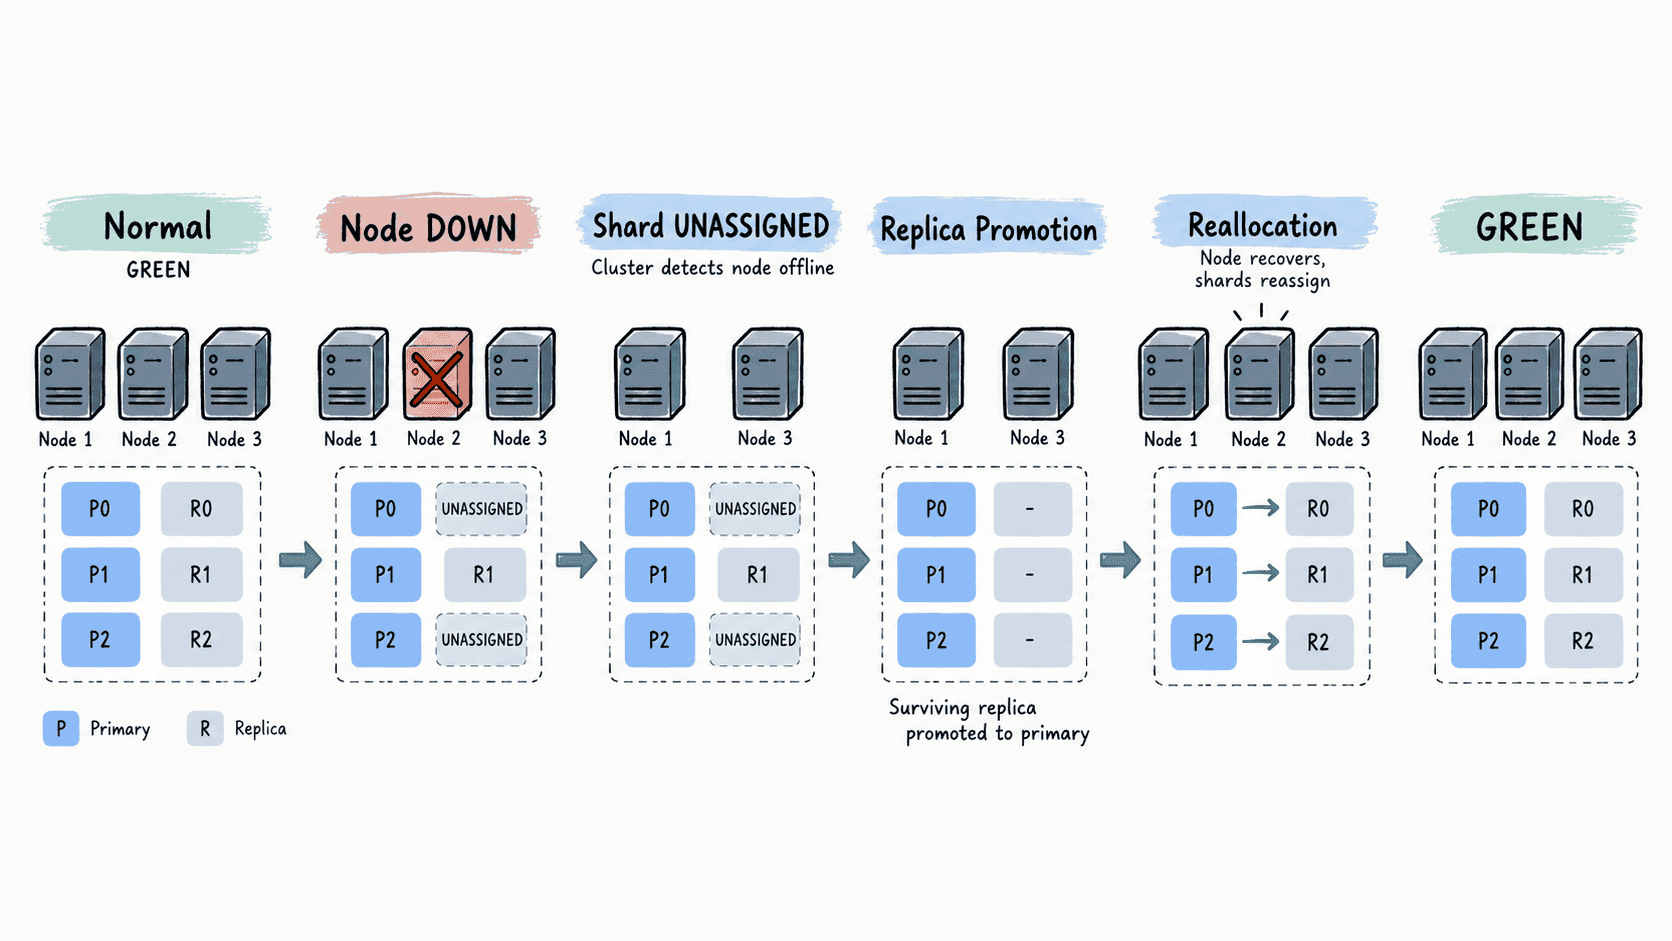
先执行下面的基线检查。假设 Elasticsearch 已通过宿主机 9200 暴露,索引名称以 app-logs-* 表示,实际名称可以替换为你的测试索引。
curl -s http://localhost:9200/_cluster/health?pretty
curl -s http://localhost:9200/_cat/nodes?v
curl -s http://localhost:9200/_cat/shards?v
curl -s 'http://localhost:9200/app-logs-*/_count?pretty'
预期结果
集群状态为 green,能看到预期的数据节点;_cat/shards 显示主分片和副本当前处于 STARTED;_count 返回演练前的文档数量。制造节点离线
在实验环境中停止一个 Elasticsearch 服务,例如 Compose 服务名为 es02。先不要同时停止其他数据节点,否则单节点故障演练会变成多节点故障。
docker compose stop es02
docker compose ps es02
curl -s http://localhost:9200/_cat/nodes?v
curl -s http://localhost:9200/_cat/shards?v
curl -s http://localhost:9200/_cluster/health?pretty
预期结果
es02 显示为 stopped;_cat/nodes 不再列出该节点;受影响分片可能出现 UNASSIGNED,集群健康状态可能短暂变化为 yellow 或 red,具体取决于离线节点承载的是副本还是主分片。这里不要把 red 或 yellow 直接当成数据丢失。首先看 _cat/shards:如果主分片仍有可用副本,集群可能完成主分片接管;如果没有可用副本,部分分片可能暂时不可用。
验证接管与告警
观察故障后的集群状态变化,重点确认三个事实:节点确实离线、分片状态发生了与故障一致的变化、监控系统能在节点或集群状态异常时产生对应告警。告警名称和通知渠道取决于你的监控系统,本课不假设具体实现。
可以持续查看分片状态,直到集群停止继续变化:
watch -n 2 'curl -s http://localhost:9200/_cat/shards?v'预期结果
终端会周期性刷新分片状态;故障期间可观察到受影响分片的状态变化。不同集群的重新分配时间不同,因此不应把某个固定秒数当成通过标准。若希望定位具体未分配原因,可以在确认存在 UNASSIGNED 后执行 allocation explain:
curl -s -X GET 'http://localhost:9200/_cluster/allocation/explain?pretty' \
  -H 'Content-Type: application/json' \
  -d '{"index":"<INDEX>","shard":<ID>,"primary":false}'
预期结果
返回该分片的 current_state、can_allocate 和各 deciders 信息,可用于判断是节点离线、磁盘水位、过滤规则还是其他条件导致暂时无法分配。<INDEX> 和 <ID> 必须替换成当前实际存在的索引与分片编号;不要复制示例占位符直接执行。
恢复节点并验证数据
恢复节点后先确认节点重新加入,再观察分片是否从恢复过程逐步回到 STARTED。恢复成功不仅要看节点数量,还要核对索引文档数量是否与故障前一致。
docker compose start es02
curl -s http://localhost:9200/_cat/nodes?v
curl -s http://localhost:9200/_cluster/health?wait_for_status=green&timeout=120s&pretty
curl -s 'http://localhost:9200/app-logs-*/_count?pretty'
预期结果
es02 重新出现在节点列表;集群在满足副本配置且没有其他故障时恢复为 green;恢复后的 _count 与演练前记录的数量一致,或差异能由演练期间明确产生的业务写入解释。不要把“恢复为 green”和“数据完整”视为同一个检查项。前者证明当前分片已经满足健康条件,后者还需要结合演练前后的文档数、关键业务 ID 或抽样查询进行验证。演练真正通过的标准,是你能够解释故障发生、接管、恢复以及数据核对之间的每一个状态变化。