
可观测性与稳定性 / 系统课时
批量写入参数怎么调
批量写入参数怎么调
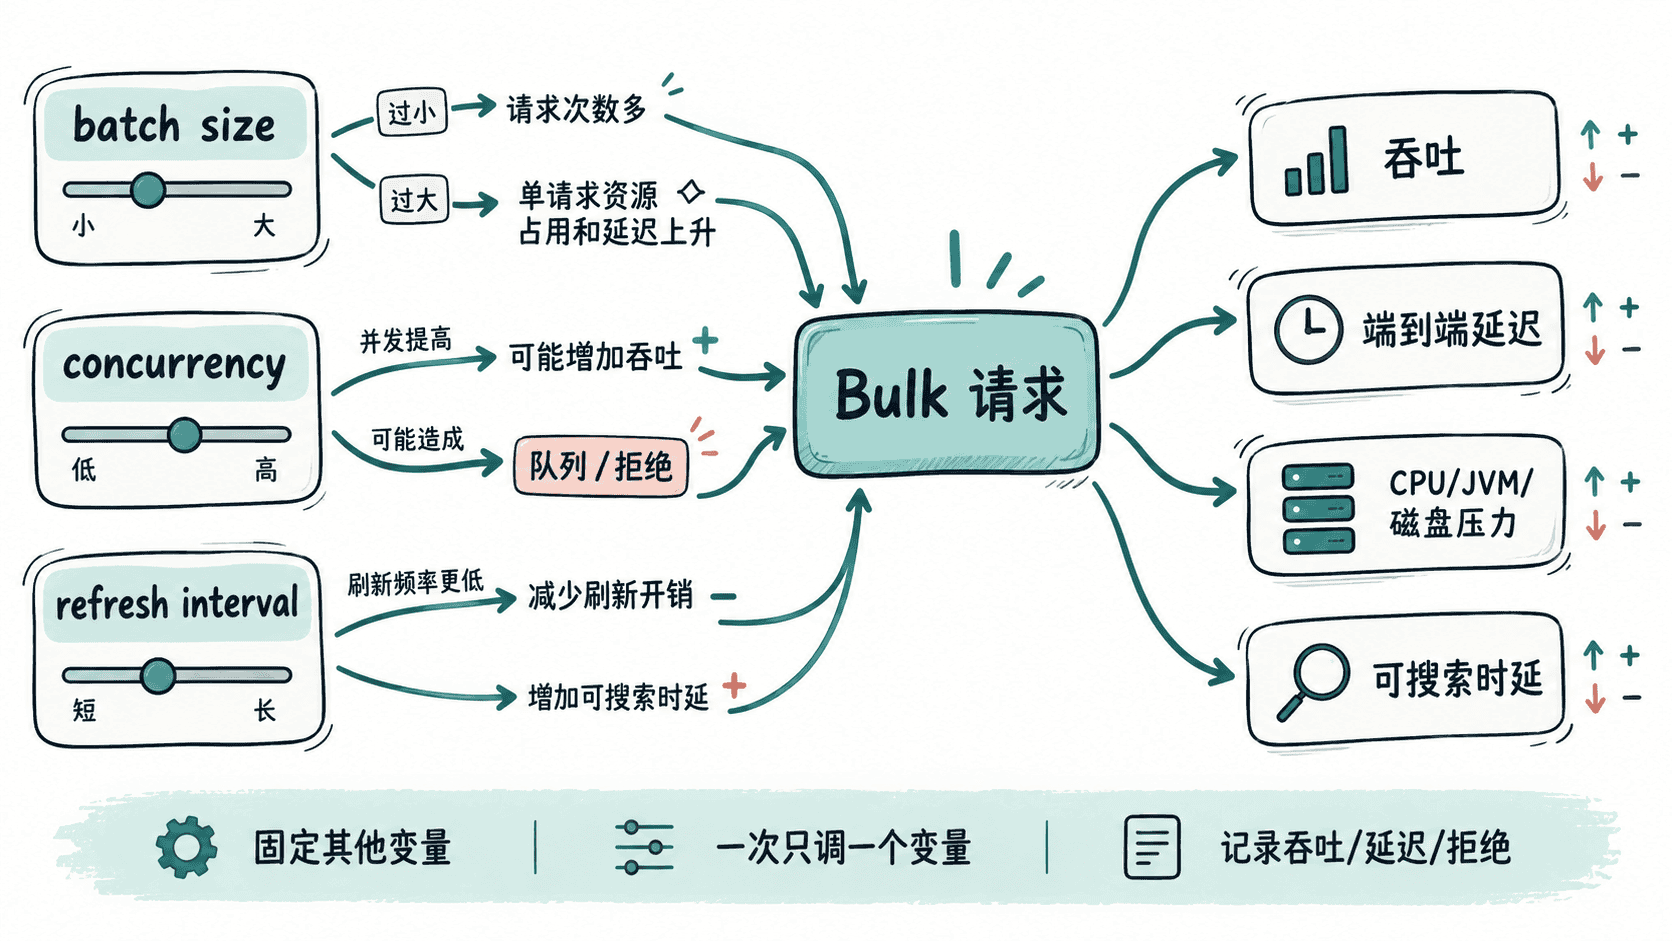
批量写入不是把 batch 调得越大越好。批量大小决定单次请求携带多少文档,并发决定同时有多少请求在飞行,刷新频率影响数据何时可被搜索;三者需要在吞吐、端到端延迟和资源占用之间取得平衡。
学习目标
- 理解批量大小、并发和刷新频率分别影响什么
- 能使用 Bulk API 建立可重复的压测基线
- 能根据吞吐与延迟变化判断下一步应该调哪个参数
先建立可比较的基线
调参前固定文档大小、字段结构、目标索引、节点数量和测试时长,否则不同轮次的结果无法直接比较。每次只改变一个主要变量,并记录吞吐、平均或分位延迟、拒绝数以及节点资源。
批量大小怎么选
批量过小会产生更多 HTTP 请求,网络、解析和调度开销占比上升;批量过大则会增加单请求内存占用,并可能拉长单次处理时间。更合理的方法是从中等批量开始,通过压测观察单位时间写入量和请求延迟,再逐步增大或减小。
下面用 Bulk API 做一个最小可重复示例。两条文档组成一个 batch,实际测试时可按固定文档大小逐轮增加。
curl -sS -X POST "http://<HOST>:<PORT>/logs-app-default/_bulk" \
  -H 'Content-Type: application/x-ndjson' \
  --data-binary $'{"index":{}}\n{"service":"order","level":"INFO","message":"created"}\n{"index":{}}\n{"service":"payment","level":"INFO","message":"accepted"}\n'
预期结果
响应为 JSON;每个 bulk item 的状态通常为 200,且没有 errors=true。实际响应中的耗时、内部文档标识等字段由集群决定,因此不要把某个固定时延或 _id 当作调参标准。调参应比较多轮测试的趋势。
并发怎么调
并发决定同时进入 Elasticsearch 的 Bulk 请求数量。并发过低时,节点可能没有充分利用;并发过高时,请求会竞争 CPU、磁盘和线程池,最终出现 queue 增长甚至 rejected。
因此并发调节通常采用逐步增加的方式:保持 batch size 不变,增加并发,直到吞吐增长开始变小,或者资源利用率、延迟、队列出现明显恶化。此时继续增加并发通常已经不是有效的优化方向。
刷新频率和写入体验
刷新会让最近写入的数据更快进入搜索可见状态,但也会增加刷新相关开销。日志平台常见目标是优先保证持续写入吞吐,同时接受有限的搜索可见延迟;对强实时检索要求更高的场景,则需要重新评估这个取舍。
调参时不要把 refresh_interval 当成单独的“性能开关”。它应与 batch size、并发、磁盘能力以及业务对搜索时延的要求一起评估。最终参数应通过目标负载压测确认,而不是照搬其他集群的数值。
一次只改一个变量
一个实用的调参顺序是先固定 refresh interval,寻找合适的 batch size;再固定 batch size,逐步增加并发;最后根据搜索可见延迟重新评估 refresh interval。每轮都记录吞吐、延迟、拒绝数和资源指标。
这样即使结果没有提升,也能知道是哪一个变量造成变化。真正有效的配置通常不是“吞吐最高”的单点,而是在目标吞吐下仍保持可接受延迟、没有持续拒绝,并且资源还有合理余量的区间。