
可观测性与稳定性 / 系统课时
JVM 堆和系统内存怎么分配
JVM 堆和系统内存怎么分配
Elasticsearch 的内存不能全部交给 JVM。节点既需要堆保存对象和执行查询,也依赖操作系统文件缓存加速 Lucene 段读取;运行在容器中时,还必须把这些需求控制在容器内存上限之内,否则可能直接被 OOM Kill。
学习目标
- 理解 JVM 堆、文件缓存与容器内存限制之间的关系
- 能为 Elasticsearch 设置合理的固定堆大小并验证实际值
- 能识别堆过大、容器上限过紧等常见配置问题
一块内存要同时服务两类需求
Elasticsearch 的 JVM 堆主要承担集群状态、查询与聚合过程中的对象、索引缓冲等工作;Lucene 的索引文件则大量通过操作系统页缓存读取。因此,把节点可用内存全部配置成 JVM 堆,反而会压缩文件缓存空间,导致磁盘读取增加。
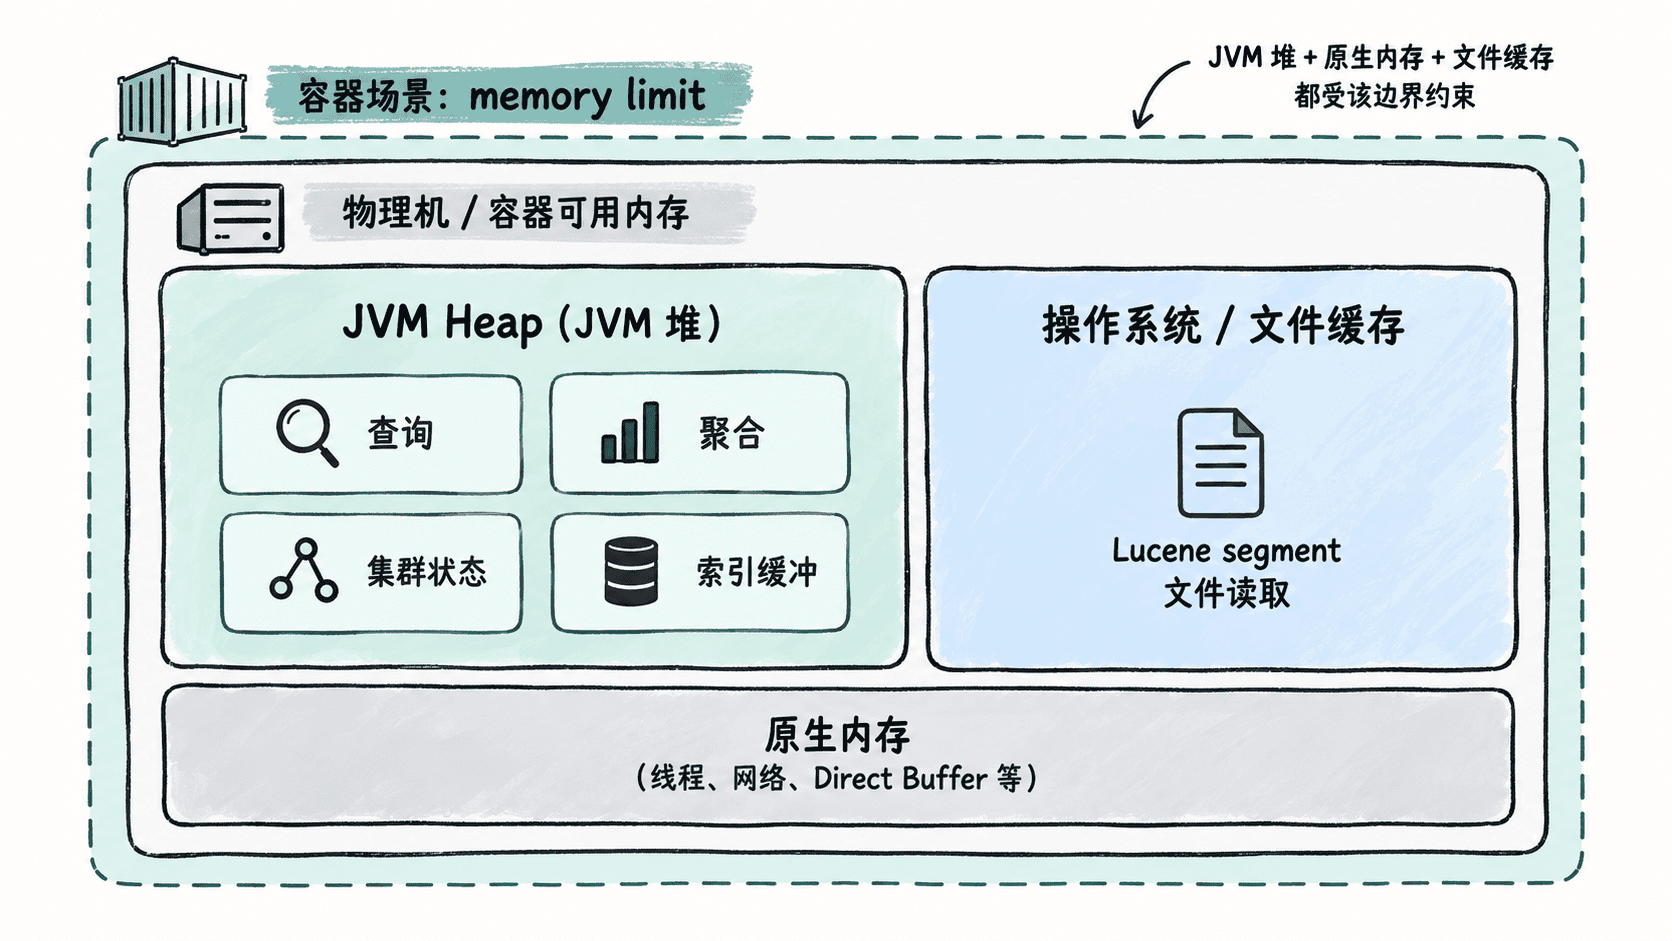
常见起点是让 Elasticsearch 堆不超过节点可用内存的大约 50%,并为操作系统和其他本地内存需求留下余量。50% 是上限思路而不是必须填满的目标;同一主机运行多个 Elasticsearch 节点时,应按所有节点堆大小的总和计算。
固定 JVM 堆大小
现代 Elasticsearch 可以自动确定堆大小。确实需要人工覆盖时,建议在 config/jvm.options.d/ 下增加自定义文件,而不是直接修改发行包自带的 jvm.options。例如为一个具有充足内存的独立节点固定 4 GB 堆:
-Xms4g
-Xmx4g
Xms 与 Xmx 应设置成相同值,使 JVM 不需要在运行期间动态调整堆边界。修改后需要重启 Elasticsearch 才会生效。
可以通过节点 API 检查 JVM 实际看到的初始堆和最大堆。以下命令假设本机测试集群允许直接访问 HTTP 接口;启用安全认证时需按集群配置提供凭据和 HTTPS 参数。
curl -s 'http://127.0.0.1:9200/_nodes/_local/jvm?filter_path=nodes.*.jvm.mem.heap_init_in_bytes,nodes.*.jvm.mem.heap_max_in_bytes'预期输出中两个值应一致;节点 ID 会随环境变化:
{"nodes":{"<ID>":{"jvm":{"mem":{"heap_init_in_bytes":4294967296,"heap_max_in_bytes":4294967296}}}}}如果配置的是 4 GB,4294967296 字节即表示设置已经被节点采用。
容器限制才是真正的边界
在 Docker 或 Kubernetes 中,判断内存时不能只看宿主机总内存。假设宿主机有 64 GB,但 Elasticsearch 容器限制为 8 GB,那么 JVM、原生内存、线程栈以及文件缓存相关压力都必须在这个限制下考虑,不能按宿主机的 64 GB 给 JVM 分配堆。
以 Docker 为例,可以检查容器实际配置的内存上限:
docker inspect <ID> --format '{{.HostConfig.Memory}}'预期输出取决于容器配置。例如限制为 8 GiB 时:
8589934592如果结果为 0,表示 Docker 没有为该容器设置此项硬限制;实际部署还要继续确认编排平台、宿主机和其他资源约束。
遇到内存问题先分清是哪一层
JVM 堆长期接近上限并频繁 GC,通常说明堆压力较高,应继续检查查询、聚合、分片规模和索引负载,而不是立即无条件加堆。进程被容器直接终止、日志来不及留下 Java OutOfMemoryError 时,则应优先检查容器内存上限和系统 OOM 记录。
另一个常见错误是只给 JVM 留空间,却忽略 Lucene 对文件缓存的依赖。日志检索平台往往需要反复读取大量索引段,文件缓存不足会把更多读取落到磁盘上。稳定的内存规划因此不是“堆越大越好”,而是在 JVM 堆、操作系统缓存和容器总限制之间留下明确边界。