
可观测性与稳定性 / 系统课时
磁盘水位触发后怎么处理
磁盘水位触发后怎么处理
Elasticsearch 节点磁盘逼近上限时,会通过磁盘水位限制分片分配,严重时还会影响索引写入。处理重点不是简单解除限制,而是先确认水位状态和分片分布,再释放或增加容量,最后验证集群能自行恢复到稳定状态。
学习目标
- 理解低、高和洪泛阶段水位分别会触发什么保护行为
- 能按磁盘、分片和索引三个层次定位空间压力来源
- 能执行清理、扩容和恢复验证,避免只解除保护却不解决容量问题
水位为什么会影响分片
Elasticsearch 的磁盘分配器会持续关注各数据节点的可用空间。达到低水位后,节点通常不再接收新的分片;达到高水位后,系统会尝试把已有分片迁往空间更充足的节点;达到洪泛阶段水位后,受影响节点上的索引可能被施加 index.blocks.read_only_allow_delete 写保护。
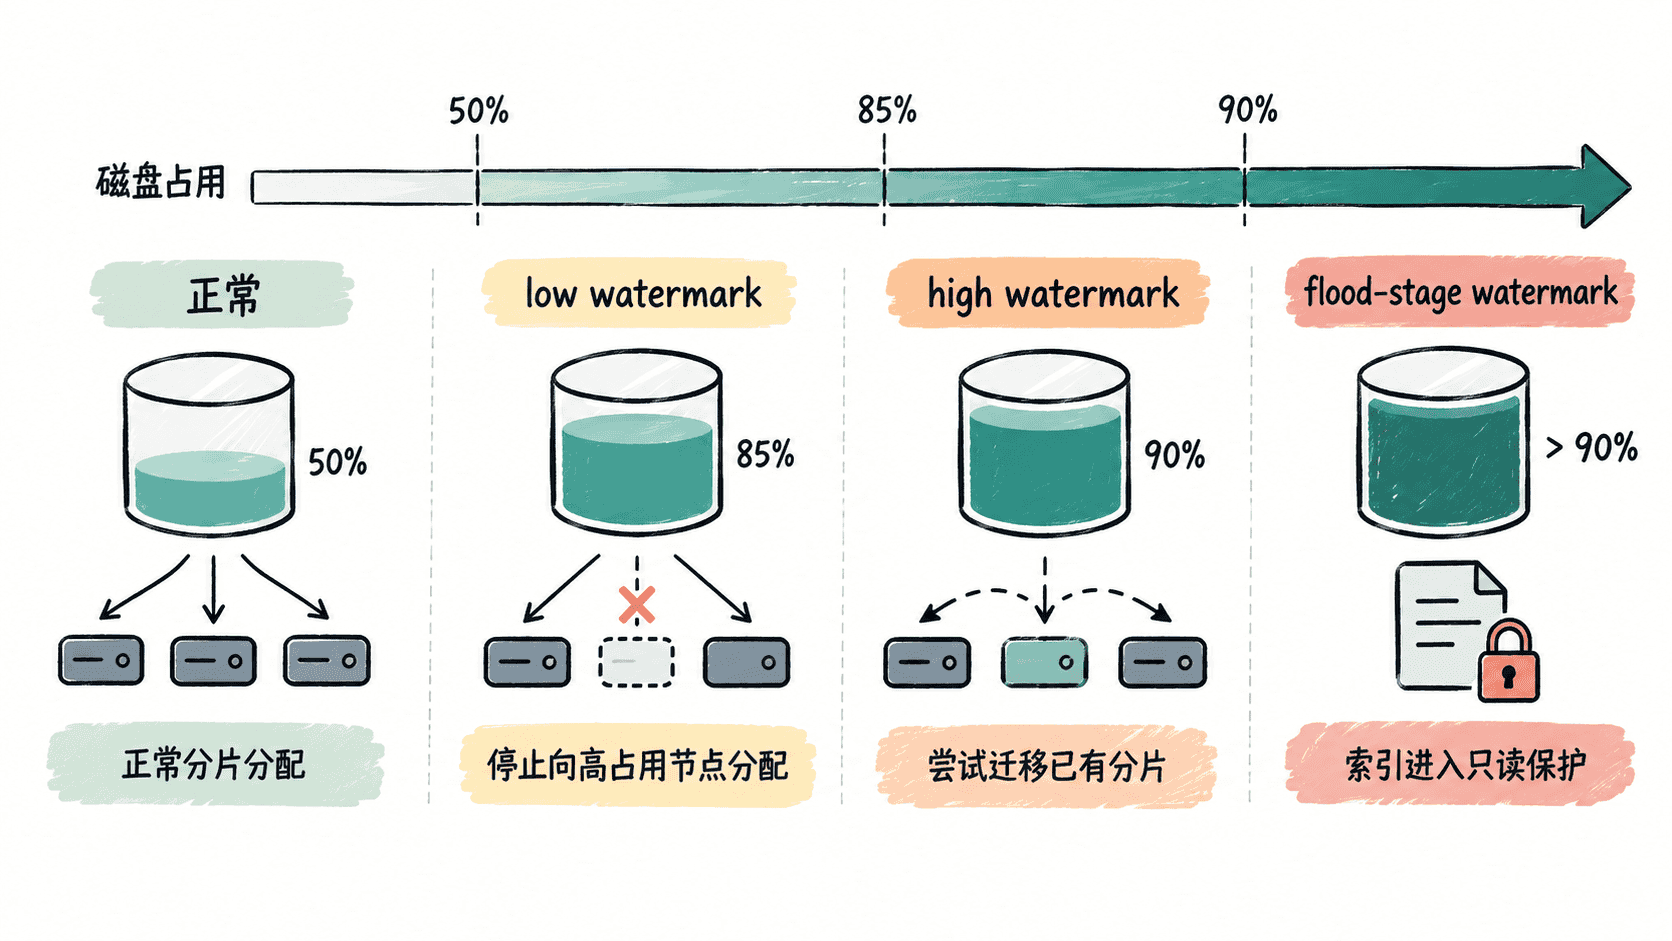
这套机制的目标是给节点留下安全余量。因此发现分片 UNASSIGNED 或写入被拒绝时,不应第一时间关闭磁盘阈值检查,否则只是移除了保护措施,磁盘仍可能继续写满。
先确认磁盘和分片状态
先查看节点文件系统、分片分布以及分配解释。下面的请求假设 Elasticsearch 可通过本机 9200 端口访问;生产环境应按实际地址和认证方式调整。
curl -s "http://localhost:9200/_cat/allocation?v"
curl -s "http://localhost:9200/_cat/shards?v"
curl -s -H 'Content-Type: application/json' \
  "http://localhost:9200/_cluster/allocation/explain?pretty" \
  -d '{"index":"logs-app","shard":0,"primary":false}'
预期结果
shards disk.indices disk.used disk.avail disk.total disk.percent host ip node
<COUNT> <SIZE>       <SIZE>    <SIZE>     <SIZE>     <PERCENT>    <HOST> <IP> <NODE>
...实际节点、容量、分片编号和分配解释会不同。重点确认高磁盘节点是否集中承载大分片,以及未分配分片的解释中是否出现磁盘阈值相关决策。allocation/explain 示例中的索引和分片必须替换为当前真实的未分配分片。
选择释放空间还是扩容
如果压力来自已经超过保留周期的日志,优先删除过期索引或让 ILM 按策略删除,而不是在文件系统中直接删除 Elasticsearch 数据目录里的文件。直接删除数据文件会破坏 Elasticsearch 对分片和索引状态的管理。
例如确认某个测试索引已经不再需要后,可以通过 API 删除:
curl -X DELETE "http://localhost:9200/logs-test-2026.08.01"预期结果
{"acknowledged":true}如果数据必须保留,则应增加磁盘容量、增加合适的数据节点,或调整数据生命周期和分片规划。删除索引只是应急手段;日志持续增长而容量模型没有变化时,磁盘压力还会再次出现。
恢复后检查写保护
容量恢复到安全范围后,现代 Elasticsearch 会在节点磁盘降到高水位以下时自动移除由洪泛阶段水位施加的只读保护。若确认磁盘压力已经解除,但目标索引仍保留该设置,可以先检查索引设置,再根据实际情况手动清除。
curl -s "http://localhost:9200/logs-app/_settings?filter_path=*.settings.index.blocks.read_only_allow_delete&pretty"预期结果
{
  "logs-app": {
    "settings": {
      "index": {
        "blocks": {
          "read_only_allow_delete": "true"
        }
      }
    }
  }
}
如果空间已经恢复且仍需人工解除,可执行:
curl -X PUT -H 'Content-Type: application/json' \
  "http://localhost:9200/logs-app/_settings" \
  -d '{"index.blocks.read_only_allow_delete":null}'
预期结果
{"acknowledged":true}这里的 logs-app 应替换为实际索引。解除保护前必须先解决磁盘压力,否则索引可能再次进入保护状态。
验证集群真正恢复
最后重新查看集群健康、磁盘和分片状态,而不是只验证一次写请求。分片迁移期间磁盘占用不会瞬间下降,因此需要观察一段时间,确认迁移能够持续推进。
curl -s "http://localhost:9200/_cluster/health?pretty"
curl -s "http://localhost:9200/_cat/allocation?v"
curl -s "http://localhost:9200/_cat/shards?v&h=index,shard,prirep,state,node,unassigned.reason"
预期结果
集群健康接口返回当前 status;allocation 显示各节点磁盘占用;shards 显示分片状态及未分配原因。实际状态、节点名和数值取决于当前集群。恢复判断应同时满足容量重新进入安全范围、没有持续由磁盘阈值导致的未分配分片,以及业务索引能够正常写入。若磁盘很快再次逼近水位,真正需要调整的是保留周期、分片规模或集群容量,而不是反复手动解除保护。