
可观测性与稳定性 / 系统课时
按请求 ID 串起一次调用
按请求 ID 串起一次调用
一次用户请求可能依次经过网关、订单、库存和支付服务,只按时间查看日志很容易把并发请求混在一起。为请求传播统一的 trace、request 或 correlation 标识,并在 Kibana 中按该字段检索,就能重建一次调用的完整日志链路。
学习目标
- 理解请求标识在跨服务日志关联中的作用
- 使用 Kibana 按统一标识检索一次调用的日志
- 判断调用链缺失发生在传播、记录还是采集环节
为什么时间相近还不够
假设 10:30:00 附近有几十个用户同时下单,网关、订单服务和支付服务都会产生大量交错日志。即使把时间窗口缩到几秒,也无法可靠判断哪些日志属于同一个请求。
更稳定的方法是在请求入口生成或接收一个标识,并让它随下游调用继续传播。不同系统可能使用 trace.id、request.id 或 correlation.id,关键不是字段叫什么,而是同一次调用中的各个组件必须记录同一个可关联值。
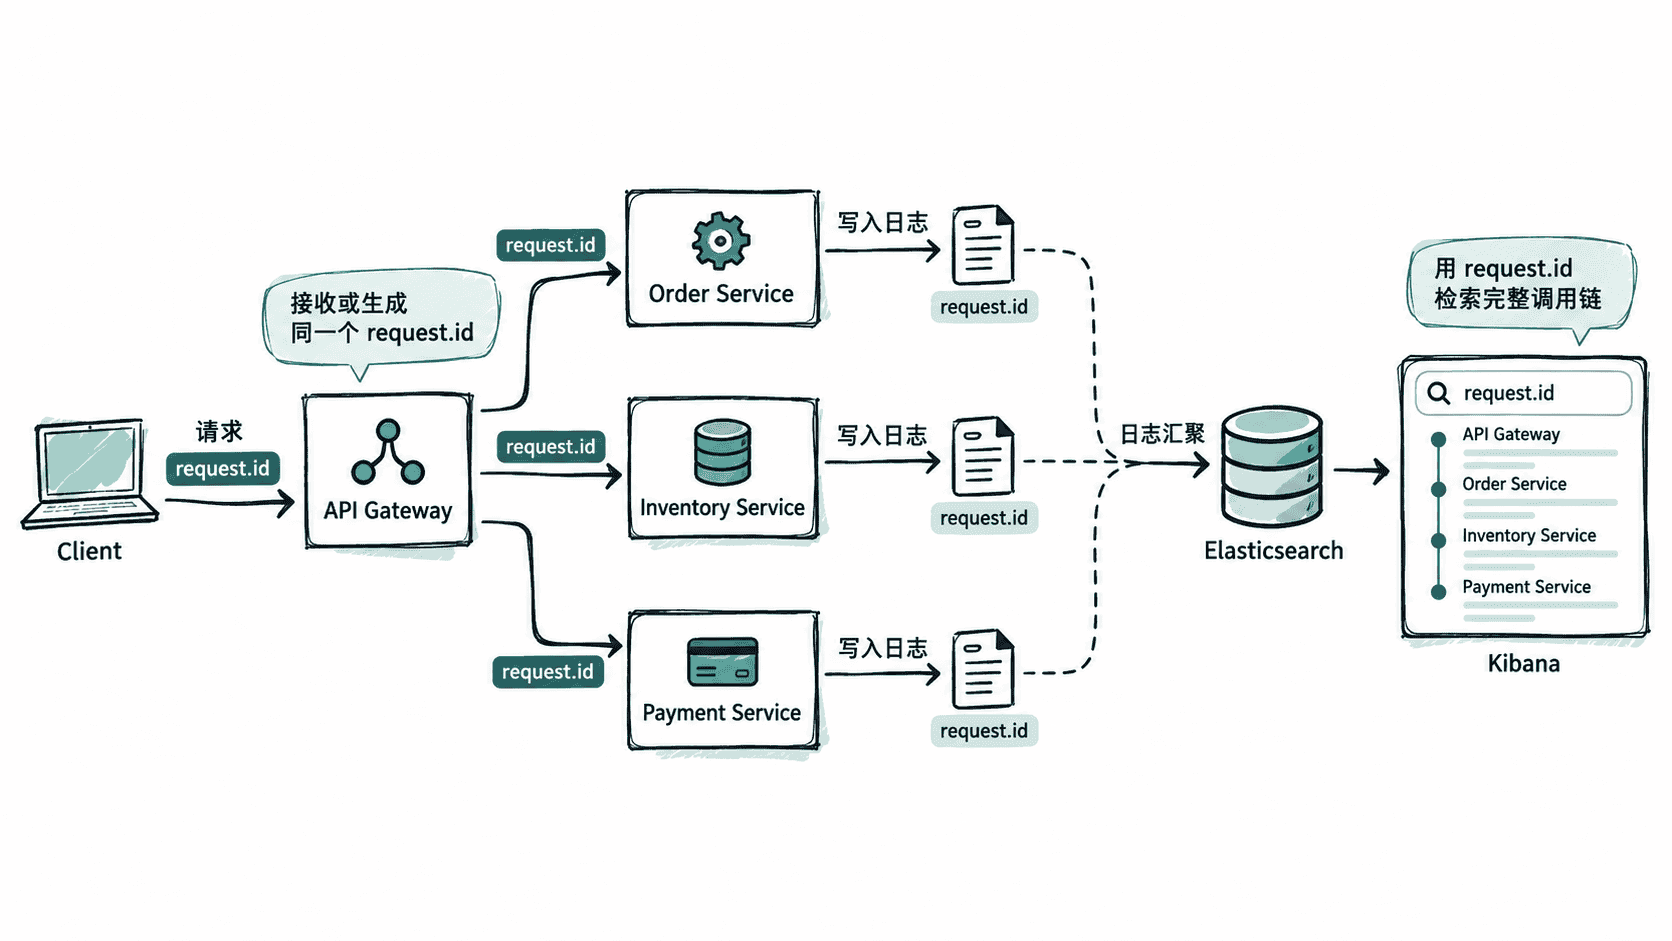
用统一字段检索整条调用
假设告警或错误响应中已经得到请求 ID <ID>,并且各服务统一把它写入 request.id,在 Kibana Discover 中可以直接查询:
request.id: "<ID>"预期结果
返回当前时间窗口内 request.id 等于 <ID> 的全部已索引日志;实际事件数量取决于该请求经过的服务和各服务的日志记录情况。<ID> 代表实际请求标识。查询时还要把 Discover 的时间窗口覆盖到请求发生时间,否则即使 ID 正确也可能得到零条结果。
如果平台采用 Elastic Common Schema 并记录分布式追踪标识,则可能查询 trace.id:
trace.id: "<ID>"预期结果
返回时间窗口内 trace.id 与 <ID> 完全匹配的已索引事件;实际字段是否存在取决于日志结构和采集配置。不要在同一个系统中随意混用 requestId、request_id、correlationId 等多个字段名。字段不统一会让原本可以一次完成的关联查询退化成大量人工拼接。
按时间顺序重建调用过程
找到同一 ID 的日志后,应结合 @timestamp、service.name、log.level 和 message 阅读。先确认入口日志,再沿时间顺序观察下游服务,重点寻找第一次出现 ERROR、超时或异常状态的位置。
例如一条调用中先出现网关接收请求,随后订单服务开始处理,库存服务成功返回,而支付服务记录超时,那么支付服务附近就是优先调查区域。这里的目标不是简单寻找最后一条错误日志,而是寻找调用从“正常”第一次转向“异常”的位置。
链路中间断了怎么查
如果同一个请求 ID 只能查到网关和订单服务,却没有支付服务日志,不能立刻断定支付服务没有收到请求。缺失可能发生在多个环节:上游没有传播 ID、下游收到请求但没有把 ID 写入日志、采集器没有采到日志,或者日志尚未进入目标数据流。
定位时先查看上游调用支付服务之前的日志,确认请求确实发出;再检查支付服务同期日志中是否存在没有 request.id 的相关事件;最后确认该服务日志是否正常进入 Elasticsearch。这样可以区分“业务调用中断”和“可观测链路中断”。
如果服务间已经采用标准分布式追踪,应优先统一使用 trace 标识,并让日志与 trace 上下文关联;如果系统暂时没有追踪基础设施,稳定传播的 request 或 correlation ID 仍然是成本很低且非常实用的排障手段。真正决定关联效果的不是字段名称,而是入口、传播、日志记录和采集四个环节都保持一致。