
可观测性与稳定性 / 系统课时
敏感日志字段怎么处理
敏感日志字段怎么处理
日志一旦进入采集链路,往往会被复制到 Elasticsearch、备份和告警系统。最稳妥的做法不是等入库后再删除,而是在采集处理阶段识别密码、令牌和个人信息字段,按用途选择删除、遮盖或不可逆替换,并验证原值没有继续流入下游。
学习目标
- 识别日志中不应原样保存的凭据与个人信息
- 在 Logstash 处理阶段删除或脱敏敏感字段
- 用测试事件验证脱敏规则不会把原值写入 Elasticsearch
先决定哪些字段允许进入日志平台
敏感数据应按“是否需要用于排障”决定处理方式。密码、私钥、会话 Cookie、访问令牌通常没有保留原值的合理需求,应直接删除或固定替换。邮箱、手机号等个人信息若业务确实需要检索,应只保留满足用途的最小信息,并结合组织的数据保护要求确定保留期限。
字段名只是第一层线索。password、authorization、access_token 很明显,但令牌也可能藏在 URL 查询参数、HTTP header 或自由文本 message 中。因此应优先让应用输出结构化日志,并在应用层避免记录秘密,再由采集层作为第二道防线。
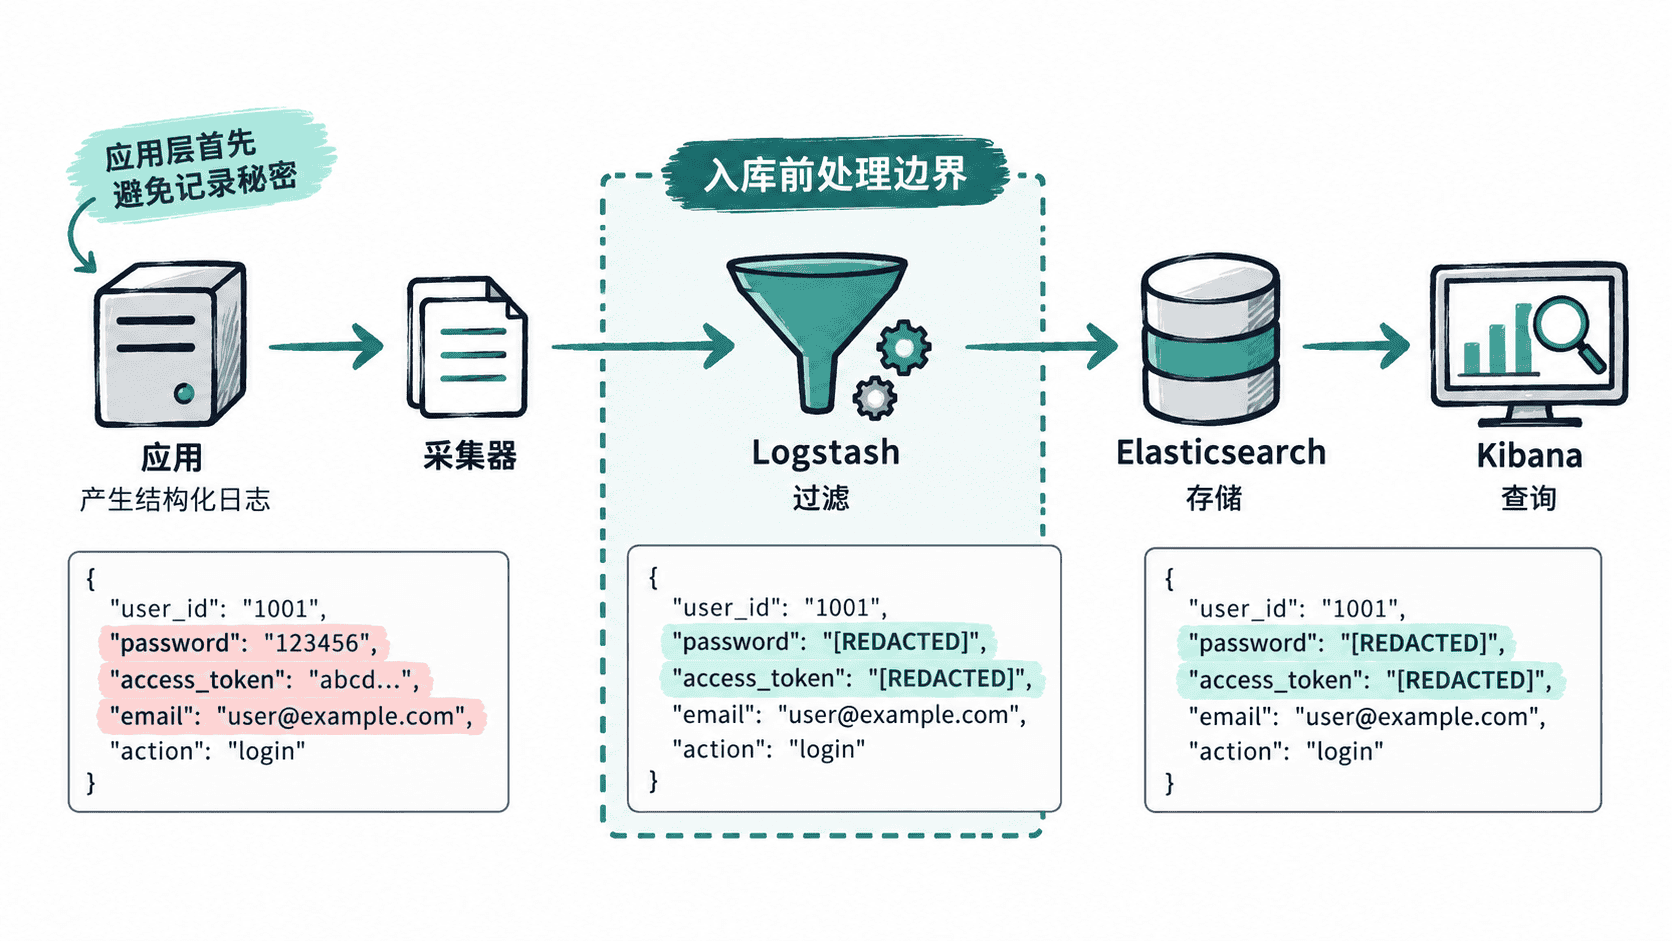
在 Logstash 中按字段脱敏
下面建立一个最小可运行管道:标准输入接收 JSON,mutate 在敏感字段存在时把原值替换成固定文本,标准输出用于检查结果。固定替换适合密码和令牌,因为这类值通常不应保留任何可恢复信息。
input {
  stdin {
    codec => json
  }
}

filter {
  if [password] {
    mutate {
      replace => { "password" => "[REDACTED]" }
    }
  }

  if [access_token] {
    mutate {
      replace => { "access_token" => "[REDACTED]" }
    }
  }
}

output {
  stdout {
    codec => json_lines
  }
}
将配置保存为 <PATH>/redact.conf,再用一条测试事件运行。@timestamp 等 Logstash 自动字段可能随版本和运行时间出现,因此验证时只关注原业务字段。
printf '%s\n' '{"user":"alice","password":"p@ssw0rd","access_token":"abc123"}' | bin/logstash -f <PATH>/redact.conf预期结果中必须满足以下业务字段值;实际输出还可能包含 Logstash 自动添加的元数据字段。
{"user":"alice","password":"[REDACTED]","access_token":"[REDACTED]"}如果某个秘密完全没有下游用途,可以改用 remove_field 直接删除字段。相比遮盖,删除更能减少误用;遮盖则能保留“上游确实发送过该字段”这一排障信号。
自由文本比结构化字段更难处理
对 message 做正则替换只能覆盖已知格式,容易漏掉编码变化、大小写差异或新的日志模板。例如 Authorization: Bearer ...、URL 中的 token= 与 JSON 内的 access_token 是不同形态。正则规则越多,误删正常文本和漏删秘密的概率也越高。
若必须处理自由文本,应先收集真实日志样本,在隔离环境中测试匹配边界,再上线规则;测试样本使用伪造凭据,不要把真实令牌复制到测试文件或工单。
验证要覆盖入库前后
规则上线前至少准备“包含敏感字段”“不包含敏感字段”和“字段为空”三类事件,确认过滤器不会误伤正常日志。上线后再从 Elasticsearch 查询目标索引,确认原始秘密不存在,同时检查失败队列、采集器本地缓存和调试输出是否保存了未脱敏副本。
脱敏也不能替代访问控制。日志平台仍应限制索引读取权限、缩短不必要的数据保留时间,并保护快照与导出文件;否则即使密码已删除,剩余的个人信息和业务上下文仍可能具有敏感性。