
可观测性与稳定性 / 系统课时
模拟采集堵塞验证止损方案
模拟采集堵塞验证止损方案
本课通过暂时停止 Elasticsearch,使 Logstash 的下游输出不可用,再持续写入日志观察队列积压、背压和重试,最后恢复下游并核对补采结果。重点不是制造一次报错,而是确认故障扩大前是否有缓冲、恢复后是否能继续发送未确认事件。
学习目标
- 能识别下游不可用时采集链路中的积压位置
- 能判断背压是在队列、Pipeline 还是输出端形成
- 能通过恢复后的数量核对验证事件是否完成补采
先记录采集基线
先确认 Filebeat、Logstash 和 Elasticsearch 均正常,再记录测试索引当前文档数。演练期间只使用专用测试日志和测试索引,避免把生产流量混入故障实验。
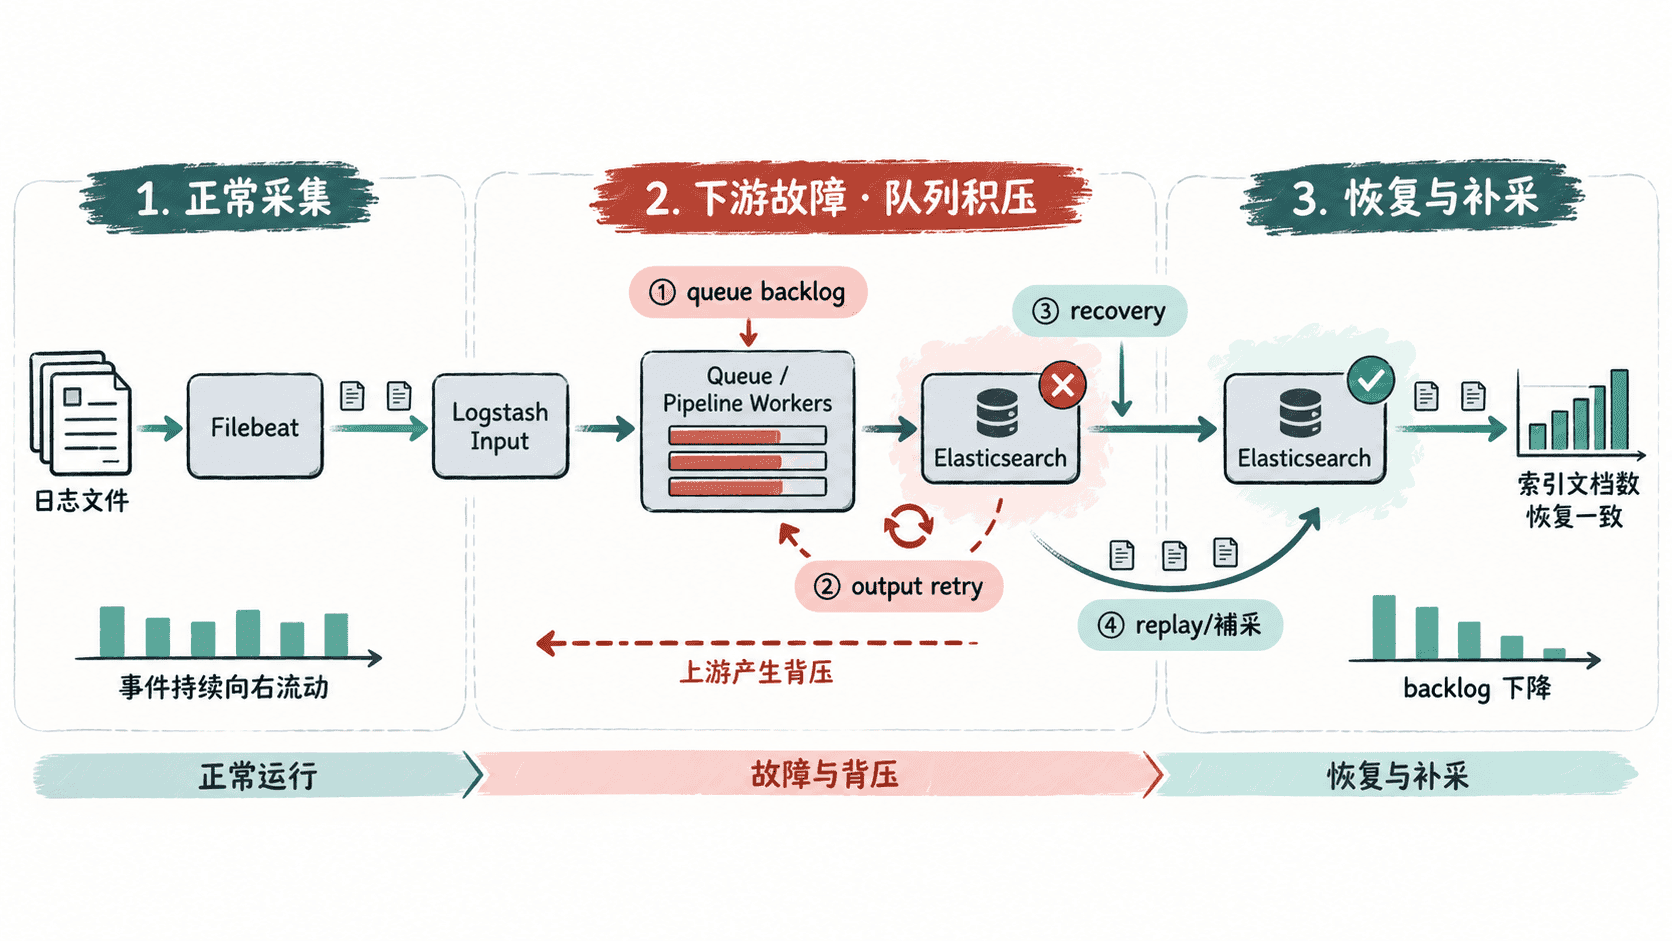
假设 Compose 服务名为 filebeat、logstash 和 elasticsearch,并且测试日志会被采集到 app-logs-*。先查看运行状态与当前数量。
docker compose ps filebeat logstash elasticsearch
curl -s 'http://localhost:9200/app-logs-*/_count?pretty'
docker compose logs --tail=50 logstash
预期结果
三个服务处于运行状态;_count 返回演练前文档数量;Logstash 日志没有持续的下游连接错误。让下游不可用并制造积压
停止 Elasticsearch,但保持 Filebeat 与 Logstash 运行。然后持续向测试日志文件追加带有唯一事件 ID 的记录。唯一 ID 很重要,因为恢复后可以准确判断哪些事件已经进入 Elasticsearch。
docker compose stop elasticsearch
for i in 1 2 3 4 5; do
  printf 'TEST-BLOCK-<TIME>-%s\n' "$i" >> ./app.log
done
docker compose logs --tail=100 logstash
预期结果
Elasticsearch 服务停止;Logstash 日志开始出现输出端连接失败、重试或等待下游恢复等信息。随着事件继续产生,积压是否增长取决于 Logstash 的队列与持久化配置,但正常现象应表现为事件无法被下游确认后持续等待或重试,而不是静默宣告发送成功。这一步要观察的是故障边界。如果 Logstash 很快停止读取上游,说明背压已经向前传播;如果本地或持久化队列持续增长,则缓冲层承担了暂时的流量吸收。两者都属于止损机制的一部分,但需要结合实际配置确认容量上限。
恢复下游并观察排空
恢复 Elasticsearch 后,不要立即删除队列或重启所有组件。先让原有连接自行恢复,这样最容易观察出重试和排空行为。
docker compose start elasticsearch
curl -s 'http://localhost:9200/_cluster/health?wait_for_status=yellow&timeout=120s&pretty'
docker compose logs --tail=100 logstash
curl -s 'http://localhost:9200/app-logs-*/_search?q=message:TEST-BLOCK-*\&size=10&sort=@timestamp:asc&pretty'
预期结果
Elasticsearch 恢复后,Logstash 日志中的连接失败应停止并逐步恢复正常发送;查询能够找到此前写入的 TEST-BLOCK-* 测试事件。若配置了持久化队列,观察期间应看到积压逐步下降而不是继续无限增长。查询结果的具体排序和字段会随索引映射而变化,因此验收时重点检查测试事件是否完整出现,而不是依赖固定的响应顺序。
验证补采是否完整
用故障前数量加上演练期间明确写入的事件数进行核对。更可靠的办法是直接按唯一事件 ID 查询五条测试记录,并比较是否全部存在。若少了记录,优先检查 Filebeat registry、Logstash 队列状态、输出重试和 Elasticsearch 写入错误,而不是立刻认为日志已经永久丢失。
curl -s 'http://localhost:9200/app-logs-*/_search?q=message:TEST-BLOCK-*\&size=100&pretty'预期结果
返回本次写入的 TEST-BLOCK-* 事件;五条测试日志均能找到时,说明本次故障期间产生的测试事件最终完成了补采。若数量不足,则应继续检查采集端确认点、Logstash 队列和输出错误。判断止损方案是否真的生效
一次演练至少要回答四个问题:下游故障多久被发现,积压出现在哪里,恢复后哪些事件重新发送,以及最终是否能核对完整。特别注意,进程存活不等于数据链路健康;Filebeat、Logstash 都可能仍显示运行中,但事件已经因为下游不可用而等待确认。
演练完成后应保留故障前数量、故障期间产生数量、恢复后查询数量以及关键错误日志。只有这些证据能够互相闭合,才能证明当前采集链路具备可观察的背压、有限的故障缓冲和可验证的恢复补采能力。