
可观测性与稳定性 / 系统课时
让第一条日志进入 Elasticsearch
让第一条日志进入 Elasticsearch
这一节只做一件事:把本地日志文件中的一条记录送进 Elasticsearch,并通过查询确认它已经成为可检索文档。跑通这条最小链路后,后续再增加解析、字段规范和 Kibana 展示时,就有一个可靠的基线可用于排错。
学习目标
- 跑通“日志文件 → Filebeat → Elasticsearch”的最小采集链路
- 能通过 Elasticsearch 查询确认日志是否真正落库
- 能根据 Filebeat 与 Elasticsearch 两端的结果定位首次采集失败
最小采集链路
实验链路由三个对象组成:应用日志文件负责产生原始文本,Filebeat 持续读取新增内容并发送事件,Elasticsearch 接收事件后写入索引。首次实验先不引入 Logstash,减少中间环节,让采集端和存储端的问题更容易区分。
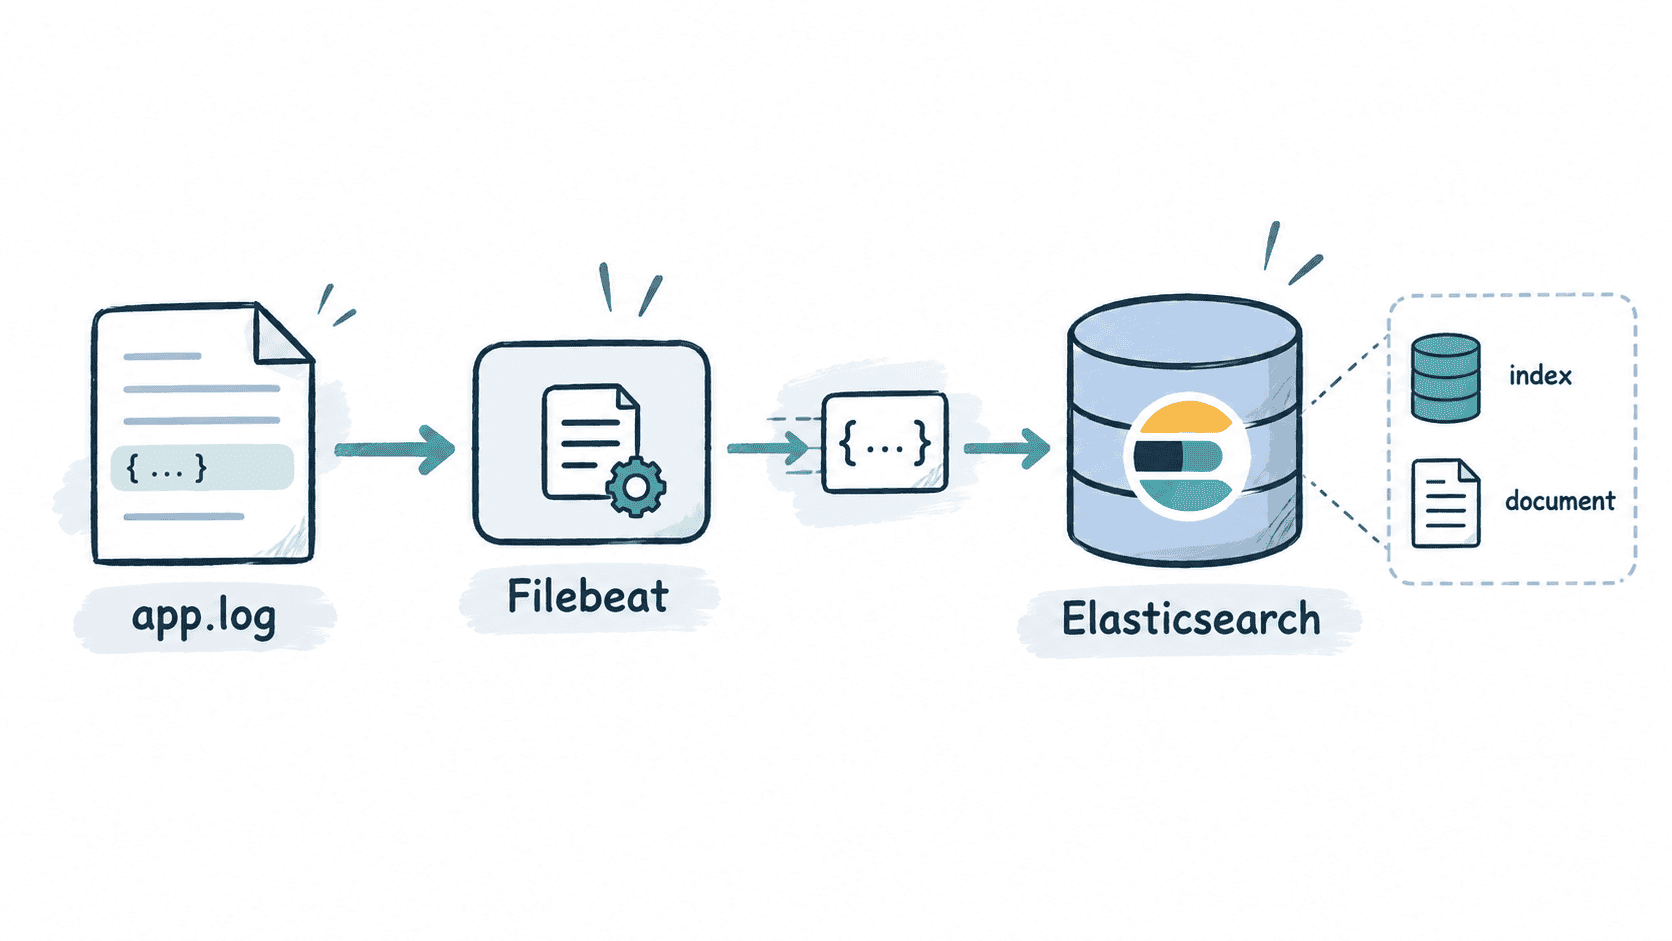
先确认 Elasticsearch 已经可访问。以下示例假设本机实验节点监听 localhost:9200;如果你的地址不同,应替换为实际主机和端口。
curl -s http://localhost:9200/预期输出中应包含节点和 Elasticsearch 版本信息,具体版本、节点名等动态值可能不同。
{
  "name": "<HOST>",
  "cluster_name": "elasticsearch",
  "version": {
    "number": "<VERSION>"
  }
}
如果这里已经连接失败,应先修复 Elasticsearch,而不是继续检查 Filebeat。
配置 Filebeat 读取实验日志
创建实验目录和日志文件,然后写入第一条日志。<PATH> 代表你实际使用的绝对目录。
mkdir -p <PATH>/logs
printf 'level=INFO message=first-log\n' > <PATH>/logs/app.log
预期结果是文件中只有一条测试日志。
level=INFO message=first-log接着配置 Filebeat。下面是可直接表达本实验核心关系的 filebeat.yml,其中路径必须替换成真实绝对路径。
filebeat.inputs:
  - type: filestream
    id: first-log-demo
    enabled: true
    paths:
      - <PATH>/logs/app.log

output.elasticsearch:
  hosts: ["http://localhost:9200"]
这份配置启用 filestream 输入并直接使用 Elasticsearch output,不做额外解析。因此 level=INFO message=first-log 会首先作为原始消息进入事件,而不会自动拆成 level 和 message 两个业务字段。
启动前可以先验证配置语法和输出连通性。假设配置文件位于当前目录:
filebeat test config -c ./filebeat.yml
filebeat test output -c ./filebeat.yml
预期输出应分别表明配置有效以及 Elasticsearch 可以连接;实际地址、版本和附加诊断行可能不同。
Config OK
...
Connection to backoff(elasticsearch(http://localhost:9200)): established
启动采集并验证落库
在前台启动 Filebeat,便于首次实验直接观察错误。-e 会把日志输出到标准错误流。
filebeat -e -c ./filebeat.yml预期结果是 Filebeat 持续运行,并建立到 Elasticsearch 的输出连接。不同 Filebeat 版本的日志格式和字段可能不同,因此不要依赖某一条固定启动日志作为唯一成功标准。
<Filebeat startup logs>
<Elasticsearch output connection established>
真正的验收应由 Elasticsearch 查询完成。另开终端查询 Filebeat 创建的数据流或索引:
curl -s 'http://localhost:9200/filebeat-*/_search?size=5&pretty'预期结果是在 hits.hits 中找到刚才的日志事件;索引名、文档 ID、时间戳和其他元数据会因版本与运行时间不同而变化。
{
  "hits": {
    "hits": [
      {
        "_index": "<INDEX>",
        "_id": "<ID>",
        "_source": {
          "message": "level=INFO message=first-log"
        }
      }
    ]
  }
}查不到日志时按链路反查
如果查询结果为空,按数据流方向逐段检查,而不是反复重启所有组件。先用 cat <PATH>/logs/app.log 确认源文件确实存在目标内容,再检查 paths 是否指向正确文件,随后查看 Filebeat 前台日志中是否存在权限、连接或发布失败信息,最后确认查询模式能够匹配实际生成的数据流或索引。
还要注意 Filebeat 会记录文件读取状态。已经成功采集过的同一行日志,简单重启 Filebeat 通常不会被当作新内容再次发送。需要验证持续采集时,应追加一条新记录:
printf 'level=INFO message=second-log\n' >> <PATH>/logs/app.log预期结果是 Filebeat 读取新增行,并在 Elasticsearch 中出现包含 second-log 的新文档。
level=INFO message=second-log当源文件有记录、Filebeat 能读取并发布、Elasticsearch 又能查询到对应文档时,最小日志链路才算真正跑通。后续加入 Logstash、解析器或可视化组件时,都可以沿用这条链路逐段验证。