
可观测性与稳定性 / 系统课时
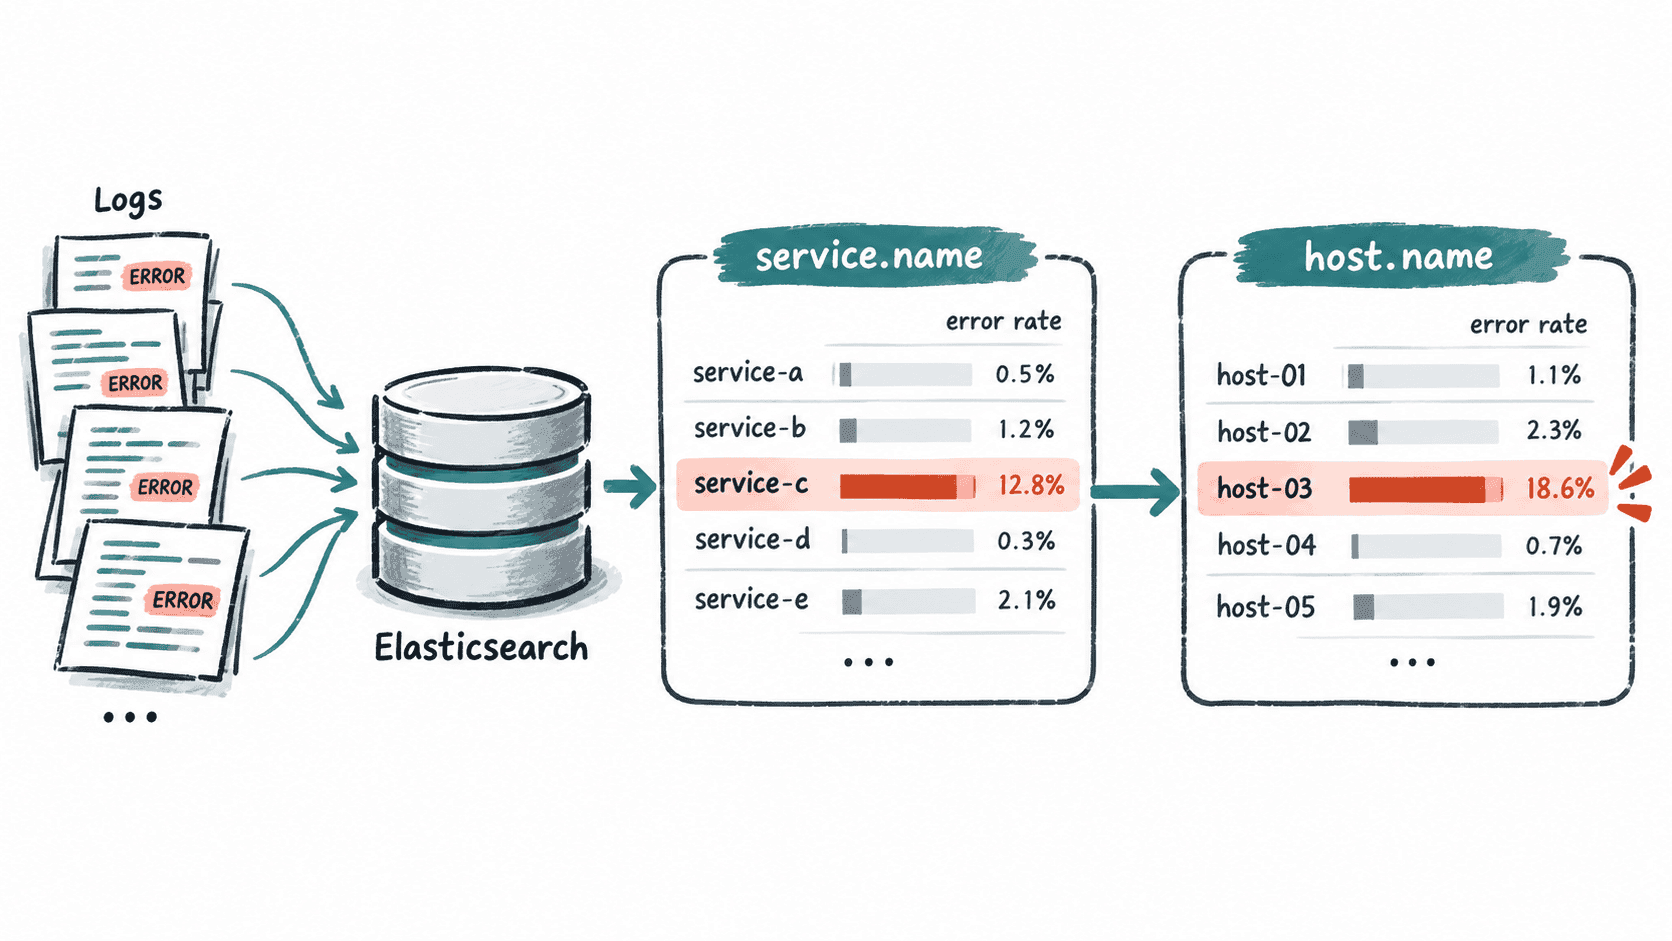
用聚合找出异常服务和主机
用聚合找出异常服务和主机
单条错误日志只能说明一次失败,线上排障更需要回答“错误集中在哪个服务、哪台主机、哪个字段值”。本节用 Elasticsearch 聚合把大量日志压缩成可比较的统计结果,并通过错误率与分组分布快速缩小故障范围。
学习目标
- 使用聚合统计服务、主机等维度的错误分布
- 计算各服务错误率,避免只看错误数量造成误判
- 根据聚合结果定位异常集中的服务、主机或字段
从总量转向分组统计
假设日志包含 service.name、host.name、log.level 等结构化字段。搜索单条 ERROR 日志可以看到错误内容,却很难判断故障是否集中。聚合的价值是先按维度分桶,再统计每个桶中的事件数量或错误比例。
例如两个服务分别产生 10000 条和 100 条日志,即使前者有更多错误,其错误率也可能更低。因此排障时通常同时观察错误数量、总日志量和错误率,再结合主机等第二维度继续下钻。
按服务计算错误率
下面的查询先按 service.name 分桶,再用 filter 聚合统计每个服务的 ERROR 数量。bucket_script 使用错误数除以该服务的日志总数,得到错误率。
POST logs-*/_search
{
  "size": 0,
  "aggs": {
    "by_service": {
      "terms": {
        "field": "service.name",
        "size": 10
      },
      "aggs": {
        "errors": {
          "filter": {
            "term": {
              "log.level": "ERROR"
            }
          }
        },
        "error_rate": {
          "bucket_script": {
            "buckets_path": {
              "errors": "errors._count",
              "total": "_count"
            },
            "script": "params.total == 0 ? 0 : params.errors / params.total"
          }
        }
      }
    }
  }
}
预期结果
{
  "aggregations": {
    "by_service": {
      "buckets": [
        {
          "key": "order-service",
          "doc_count": 1000,
          "errors": {
            "doc_count": 120
          },
          "error_rate": {
            "value": 0.12
          }
        }
      ]
    }
  }
}
实际桶和值取决于当前索引中的日志。示例中的 0.12 表示该服务约 12% 的日志满足错误条件,而不是 12 条错误。
沿异常服务继续找主机
发现某个服务错误率明显升高后,不要立即认定应用代码有问题。可以给查询增加时间范围和服务过滤条件,再按 host.name 聚合。如果错误几乎集中在一台主机,排查方向就会转向该实例的配置、资源、网络或部署差异。
POST logs-*/_search
{
  "size": 0,
  "query": {
    "bool": {
      "filter": [
        { "term": { "service.name": "order-service" } },
        { "term": { "log.level": "ERROR" } },
        { "range": { "@timestamp": { "gte": "now-15m", "lte": "now" } } }
      ]
    }
  },
  "aggs": {
    "by_host": {
      "terms": {
        "field": "host.name",
        "size": 20
      }
    }
  }
}
预期结果
{
  "aggregations": {
    "by_host": {
      "buckets": [
        { "key": "app-03", "doc_count": 96 },
        { "key": "app-01", "doc_count": 13 },
        { "key": "app-02", "doc_count": 11 }
      ]
    }
  }
}
实际主机名和数量会不同。如果同一服务的大部分错误集中在 app-03,就应优先比较这台主机与正常实例的版本、环境变量、依赖连接和资源状态。
聚合结果如何用于定位
聚合不是根因证明,而是缩小搜索空间的方法。服务错误率异常说明问题与某个服务高度相关;同一服务中只有单台主机异常,则实例差异更值得检查;多个服务同时出现相同异常字段,则应考虑共享依赖或上游故障。
还要注意时间窗口。短窗口适合捕获突发故障,长窗口适合观察基线,但长窗口可能把几分钟的尖峰稀释掉。排障时可先观察最近 15 分钟,再与正常时段比较,并最终回到异常桶中的原始日志确认具体错误。