
可观测性与稳定性 / 系统课时
日志轮转后为什么重复采集
日志轮转后为什么重复采集
应用把 app.log 轮转为历史文件后,如果 Filebeat 对文件身份判断发生变化,旧内容可能被当成新文件再次读取;处理不当也可能造成遗漏。本节从文件身份、registry 状态和轮转方式入手,建立一套可验证的排查顺序。
学习目标
- 理解 Filebeat 如何结合文件身份和状态记录继续读取
- 区分重命名轮转与复制截断带来的不同风险
- 通过配置检查和 registry 相关诊断定位重复采集
重复并不只是文件名变化
Filebeat 采集文件时需要记住“这个文件读到哪里了”。这类读取状态会持久化到 registry,以便进程重启后继续读取。轮转发生时,当前日志可能改名为历史文件,同时应用创建新的 app.log;采集器需要判断哪些是已读文件、哪些是真正的新文件。
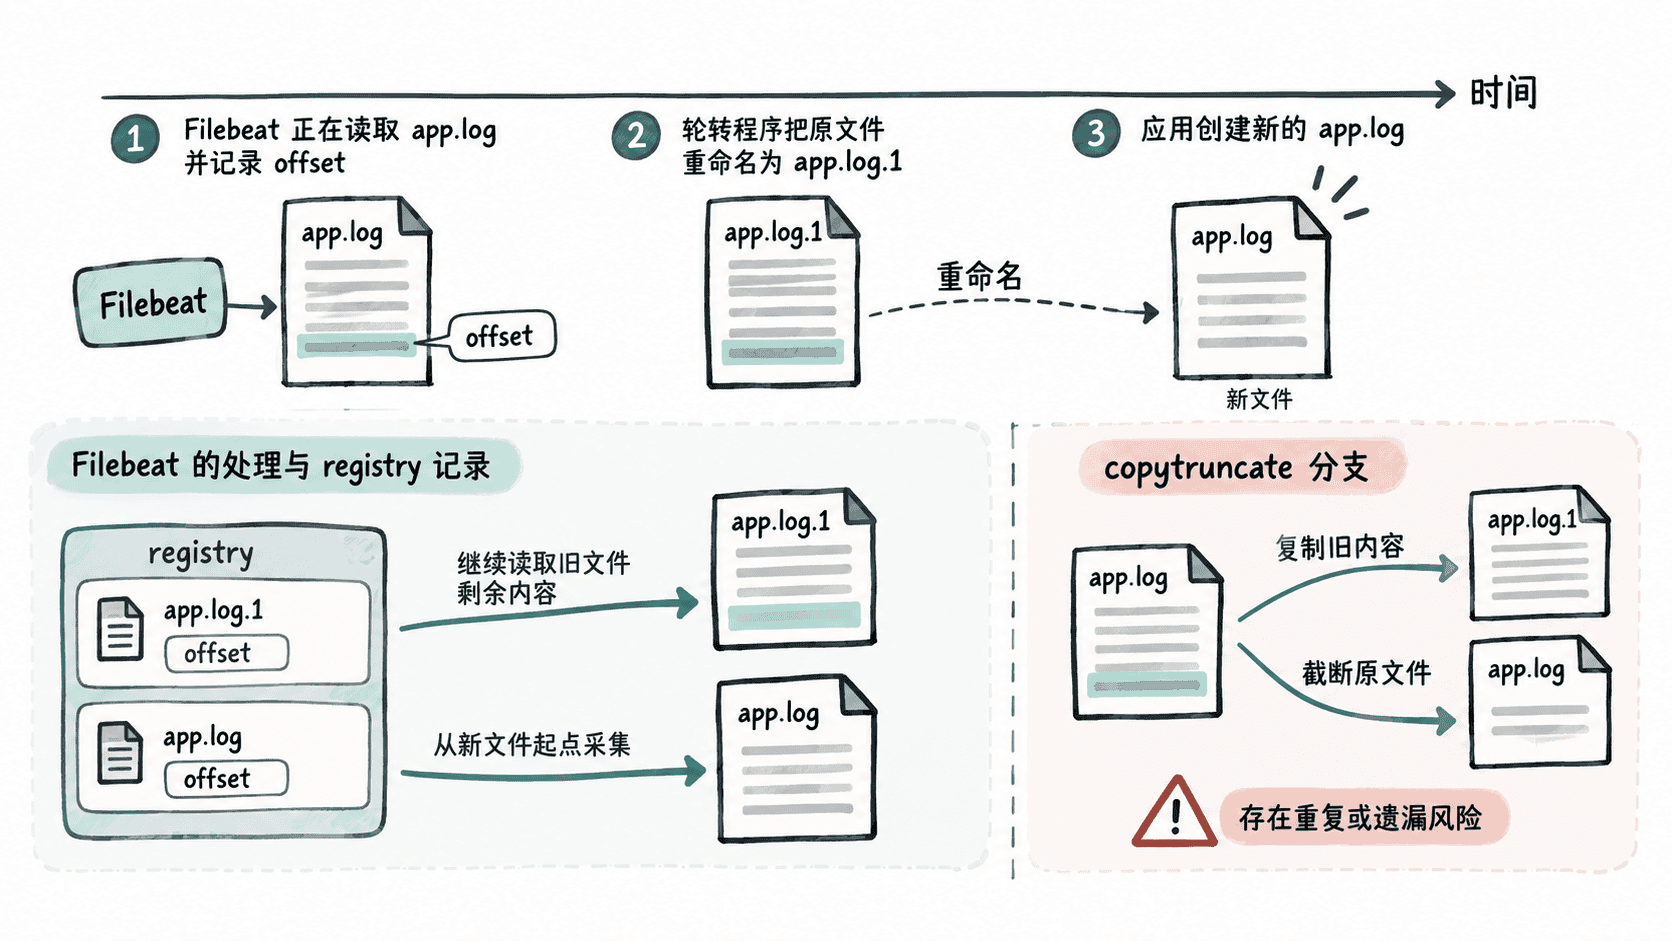
如果轮转工具采用重命名方式,旧文件本身只是换了名字,采集器可以依据文件身份延续状态。风险更高的是 copytruncate:轮转程序先复制当前文件,再把原文件截断。复制和截断之间应用仍可能写日志,而且轮转副本与原文件内容存在重叠,采集边界更难保持一致。
先检查采集范围
一个常见错误是同时匹配当前文件和轮转副本,却没有确认 Filebeat 能否正确延续它们的状态。例如:
filebeat.inputs:
  - type: filestream
    id: app-log
    enabled: true
    paths:
      - /var/log/myapp/app.log*

output.console:
  pretty: true
这段配置会让 app.log、app.log.1 等匹配文件进入发现范围。它本身不等于一定重复,但如果轮转策略、文件身份配置或 registry 状态异常,历史内容就可能再次进入采集链路。
配置修改后先验证:
filebeat test config -c <PATH>/filebeat.yml预期输出:
Config OK<PATH> 是实际配置目录。配置验证只能证明语法和配置可加载,不能证明轮转期间没有重复事件。
按状态而不是猜测排查
先确认应用和轮转工具到底采用 rename/create 还是 copytruncate。Linux 上可以检查 logrotate 配置中是否出现 copytruncate:
grep -R "copytruncate" /etc/logrotate.conf /etc/logrotate.d 2>/dev/null如果配置启用了 copytruncate,预期会输出包含该指令的配置行,例如:
/etc/logrotate.d/myapp: copytruncate如果没有输出,只能说明这些被搜索的配置文件中没有匹配项,仍需确认应用是否使用自身的日志轮转机制。
接着检查 Filebeat 日志,重点寻找文件发现、reader 启停和状态恢复相关信息,而不是看到 Elasticsearch 中两条相同消息就立即认定 Filebeat 重读。应用本身重复写入、下游重试或重复消费也会产生相似现象。
不要随意删除 registry
registry 是 Filebeat 判断历史读取进度的重要依据。为了“让配置重新生效”而直接删除 registry,可能使仍在匹配范围内的日志从头读取,制造大规模重复数据。
更可靠的修复思路是优先采用 Filebeat 支持良好的轮转方式,保持 filestream 输入的 id 稳定,不在无评估情况下改变文件身份策略,并确保轮转文件不会在采集器尚未完成读取时过早删除。
用一次受控轮转验证修复
修复后写入一组带唯一编号的测试日志,再执行一次与生产一致的轮转,最后在下游按这些编号统计。每个编号应只出现一次,并且轮转前后连续编号都存在。这样可以同时发现“重复”和“遗漏”,比只观察文件名或 Filebeat 是否 Running 更可靠。
当问题只在轮转时出现时,排查顺序应保持为:确认轮转机制,核对匹配路径,再检查文件身份与 registry 状态,最后验证下游是否存在重复投递。这样才能区分采集器重读、应用重复写入和后续链路重复处理。