
可观测性与稳定性 / 系统课时
写入吞吐下降先看哪些指标
写入吞吐下降先看哪些指标
当 Elasticsearch 写入速度突然下降,先不要盲目增加节点或修改线程池。应沿着 CPU、JVM、磁盘、线程池、队列和拒绝请求这条链路逐层确认,先判断是计算、I/O、排队还是下游压力导致吞吐下降,再决定处理方式。
学习目标
- 能按固定顺序检查写入瓶颈,而不是只看单一指标
- 能结合线程池、队列和拒绝请求判断是否存在过载
- 能用一组命令快速验证初步判断
先判断瓶颈在哪一层
写入吞吐下降通常不是一个指标单独造成的。CPU 持续高位更像计算压力,JVM 堆使用率和 GC 抖动提示内存压力,磁盘延迟升高则更接近存储 I/O 瓶颈;线程池排队和 rejected 增长说明请求已经进入拥塞状态。
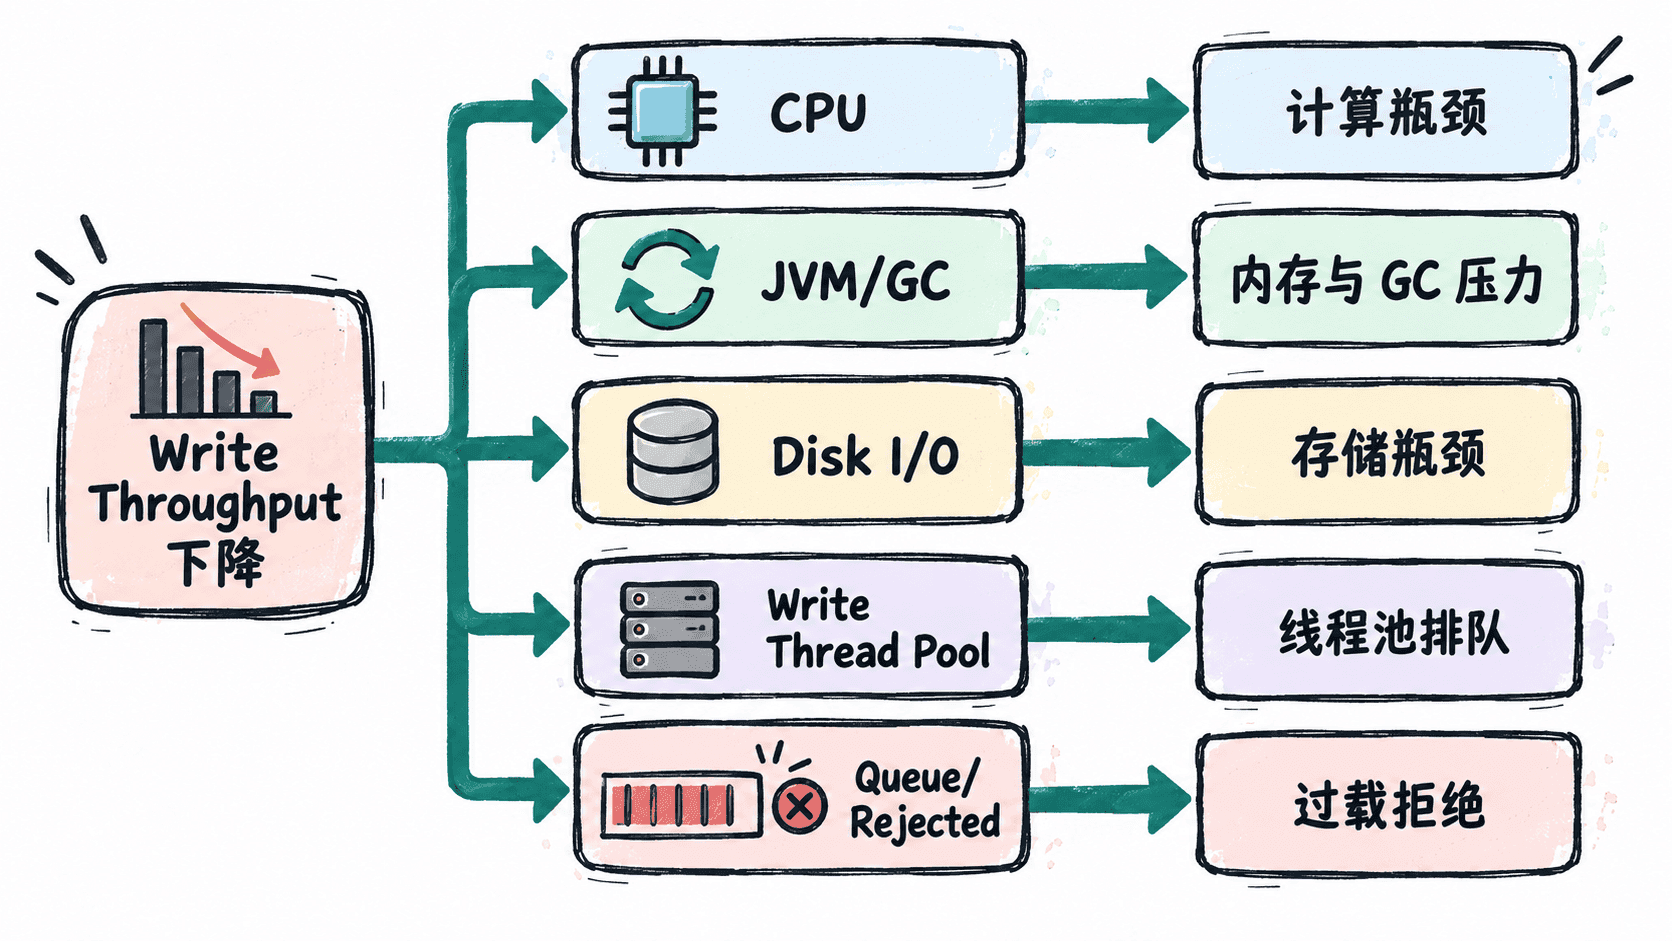
检查 CPU、JVM 和磁盘
先看节点资源是否已经接近上限。CPU 高并不必然代表问题,因为写入、压缩和 segment 合并都会消耗计算资源;更有价值的是观察吞吐下降是否与 CPU、GC 或磁盘指标同时发生变化。
下面的命令用于快速确认节点状态和 JVM 概况。实际地址中的 <HOST>、<PORT> 应替换为你的 Elasticsearch 地址。
curl -s "http://<HOST>:<PORT>/_cat/nodes?v&h=name,cpu,heap.percent,ram.percent,load_1m,node.role"
printf '\n-- thread pool write --\n'
curl -s "http://<HOST>:<PORT>/_cat/thread_pool/write?v&h=node_name,active,queue,rejected,completed"
预期结果
name       cpu heap.percent ram.percent load_1m node.role
node-a      78           71          83    4.20  data

-- thread pool write --
node_name active queue rejected completed
node-a 8 0 0 12480这里重点不是某个固定阈值,而是趋势和相关性。例如吞吐下降同时伴随 queue 持续增加、rejected 开始增长,说明请求处理速度已经跟不上进入速度;若 CPU 不高但磁盘延迟明显升高,则应优先检查存储。
线程池和拒绝请求为什么重要
线程池中的 active 表示正在执行的任务,queue 表示等待处理的任务,rejected 表示线程池无法接受更多任务而拒绝的请求。三者结合起来,比单看 CPU 更能说明是否正在发生写入过载。
一个常见误区是看到 rejected 就立即调大线程池。线程池只是执行入口,后端磁盘、segment 合并和刷新速度如果才是真正瓶颈,扩大并发可能只是让更多请求排队,最终把压力传递到 JVM 和磁盘。
用时间相关性缩小范围
排查时最好把应用侧写入吞吐、Elasticsearch 节点资源和线程池指标放在同一时间窗口观察。一个简单的判断路径是:吞吐先下降,再看 CPU 是否升高;CPU 正常则看磁盘与 GC;资源异常不明显时继续看线程池排队与拒绝。
真正需要修复的是瓶颈本身,而不是某个看起来异常的数字。只有当多个指标在同一时间段形成一致证据时,才适合进入容量调整或配置优化阶段。