
可观测性与稳定性 / 系统课时
ELK 日志链路各组件怎么分工
ELK 日志链路各组件怎么分工
搭建日志平台前,先要明确谁负责采集、处理、存储和查询。组件职责一旦混淆,后续很容易出现重复采集、Logstash 过载或 Elasticsearch 承担不该承担的处理逻辑。本节用一条完整数据链路建立组件边界。
学习目标
- 说清 Elasticsearch、Logstash、Kibana 与 Beats 的核心职责
- 理解一条日志从业务主机进入检索界面的数据流向
- 根据日志规模判断哪些组件可以省略或替换
一条日志经过哪些组件
典型链路可以概括为:业务程序写日志,Beats 在主机侧读取并发送,Logstash 解析和转换,Elasticsearch 建立索引并保存,Kibana 再通过 Elasticsearch 查询数据并展示。
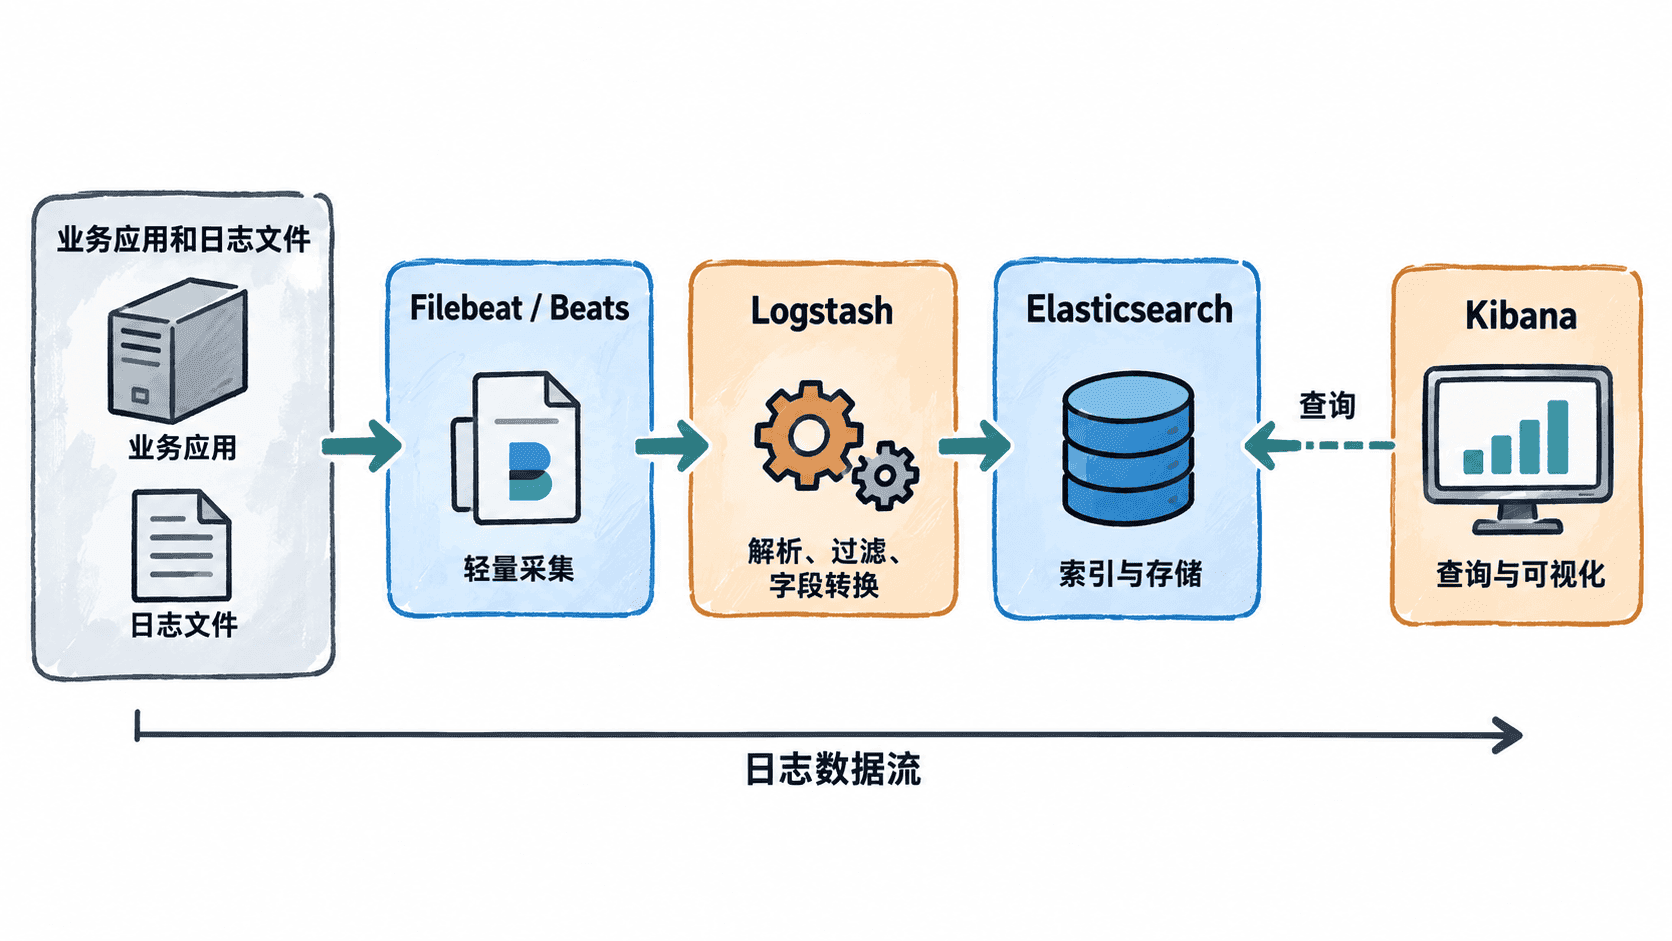
这里最重要的边界是:Kibana 不是日志存储,Logstash 也不是数据库。最终可检索的数据位于 Elasticsearch 中,而 Kibana 是面向这些数据的查询、分析和可视化入口。
四类组件分别负责什么
Beats 是部署在数据源附近的轻量采集器。日志场景最常见的是 Filebeat,它负责跟踪日志文件、读取新增内容并发送到下游。它适合放在大量业务主机上,而不是承担复杂的数据加工。
Logstash 负责数据处理流水线。它通过 input、filter、output 接收事件、解析文本、增删字段并发送到目标系统。比如把一行 Nginx access log 拆成状态码、URI、响应时间等字段,便于后续聚合查询。
Elasticsearch 负责索引、存储和检索日志事件。写入的数据经过映射和索引后,可以按时间、关键字和结构化字段快速查询,也可以执行聚合统计。
Kibana 面向 Elasticsearch 提供搜索、Discover、仪表盘和可视化等能力。用户在 Kibana 中查询日志时,本质上仍是向 Elasticsearch 发起查询。
用最小请求验证存储与查询
如果实验环境已经启动 Elasticsearch,可以直接写入一条测试文档,再查询它,从而验证 Elasticsearch 在链路中的存储和检索职责。以下假设服务监听 <PORT>,实际端口按环境替换。
curl -X POST "http://localhost:<PORT>/app-logs/_doc?refresh=true" -H "Content-Type: application/json" -d '{"level":"INFO","service":"order-api","message":"order created"}'
curl "http://localhost:<PORT>/app-logs/_search?q=service:order-api&filter_path=hits.total"
预期输出:第二条命令会返回匹配数量;不同 Elasticsearch 版本的 hits.total 表示形式可能不同。
{"hits":{"total":{"value":1,"relation":"eq"}}}这个实验没有经过 Beats 和 Logstash,说明 Elasticsearch 可以直接接收结构化文档。生产日志链路加入采集与处理组件,是为了把分散日志可靠地送达并在写入前完成必要加工,而不是因为 Elasticsearch 必须依赖它们才能工作。
什么时候可以缩短链路
ELK 并不意味着四类组件必须同时存在。如果应用已经输出结构化 JSON,Filebeat 能够完成所需采集和简单处理,就可以采用 Filebeat -> Elasticsearch -> Kibana,减少一个中间层。
当日志需要复杂正则解析、字段转换、条件路由或汇聚多个输入源时,再引入 Logstash 更合理。规模进一步扩大后,还可能在采集端和处理端之间增加消息队列,用于削峰和缓冲;这属于链路扩展,而不是四个核心组件职责的改变。
判断组件是否需要保留时,可以沿着“采集、处理、存储检索、查询展示”四个职责逐项检查。只要每项职责都有明确承担者,并且数据流向清晰,就不必为了名称上的“ELK”强行部署全部组件。