
可观测性与稳定性 / 系统课时
用 KQL 快速缩小故障范围
用 KQL 快速缩小故障范围
线上日志量很大时,逐页翻日志几乎无法定位问题。KQL(Kibana Query Language)的价值在于把时间窗口、字段值和布尔条件组合起来,先从海量事件中筛出与故障直接相关的一小部分,再继续分析异常模式。
学习目标
- 使用字段匹配和布尔条件编写常见 KQL 查询
- 结合时间窗口逐步缩小故障范围
- 避免字段类型、通配符和缺失字段导致的误判
从故障现象转换成查询条件
排障时不要一开始写很复杂的表达式。先把已知现象拆成可过滤的条件,例如:生产环境、支付服务、错误级别,并且只查看最近 15 分钟。
在 Kibana Discover 中先通过时间选择器限定最近 15 分钟,再输入下面的 KQL:
service.name: "payment-service" and log.level: "ERROR" and deployment.environment: "production"预期结果
Discover 仅保留最近 15 分钟内,同时满足 payment-service、ERROR 和 production 条件的日志事件;实际命中数量取决于当前索引中的日志。时间范围通常由 Discover 的时间选择器控制,而不是硬塞进每条 KQL。这样修改查询条件时仍能保持统一的观察窗口,也更方便快速切换最近 15 分钟、1 小时等范围。
用布尔条件继续收窄
KQL 支持 and、or 和 not。排障中最重要的是明确条件之间的逻辑关系。比如只关注支付服务中超时或网关错误,同时排除健康检查日志,可以写成:
service.name: "payment-service" and (message: *timeout* or http.response.status_code: 502) and not url.path: "/health"预期结果
命中 payment-service 中包含 timeout 或状态码为 502 的事件,同时排除 url.path 为 /health 的事件;实际日志内容和数量可能不同。括号决定 or 的作用范围。如果省略括号,复杂表达式很容易与人的排障意图不一致。条件超过两三组时,应主动用括号表达逻辑,而不是依赖阅读者猜测优先关系。
字段存在性比关键词搜索更可靠
结构化日志的优势是可以直接查询字段。例如要寻找存在错误堆栈的事件,可查询:
error.stack: *预期结果
仅显示存在 error.stack 字段且具有可查询值的事件;具体命中数量取决于日志数据。相比 message: *Exception*,查询 error.stack 更接近真正的结构化错误事件。但前提是采集和解析阶段确实生成了这个字段。如果某些服务只把异常写入 message,两种查询得到的集合就可能不同。
按固定顺序缩小范围
面对“刚才支付失败了”这类模糊反馈,可以按时间、服务、严重级别、错误特征逐层过滤。每增加一个条件,都观察命中数量和日志内容是否符合预期。如果某一步突然从大量结果变成零条,应先检查刚加入的条件,而不是继续增加过滤器。
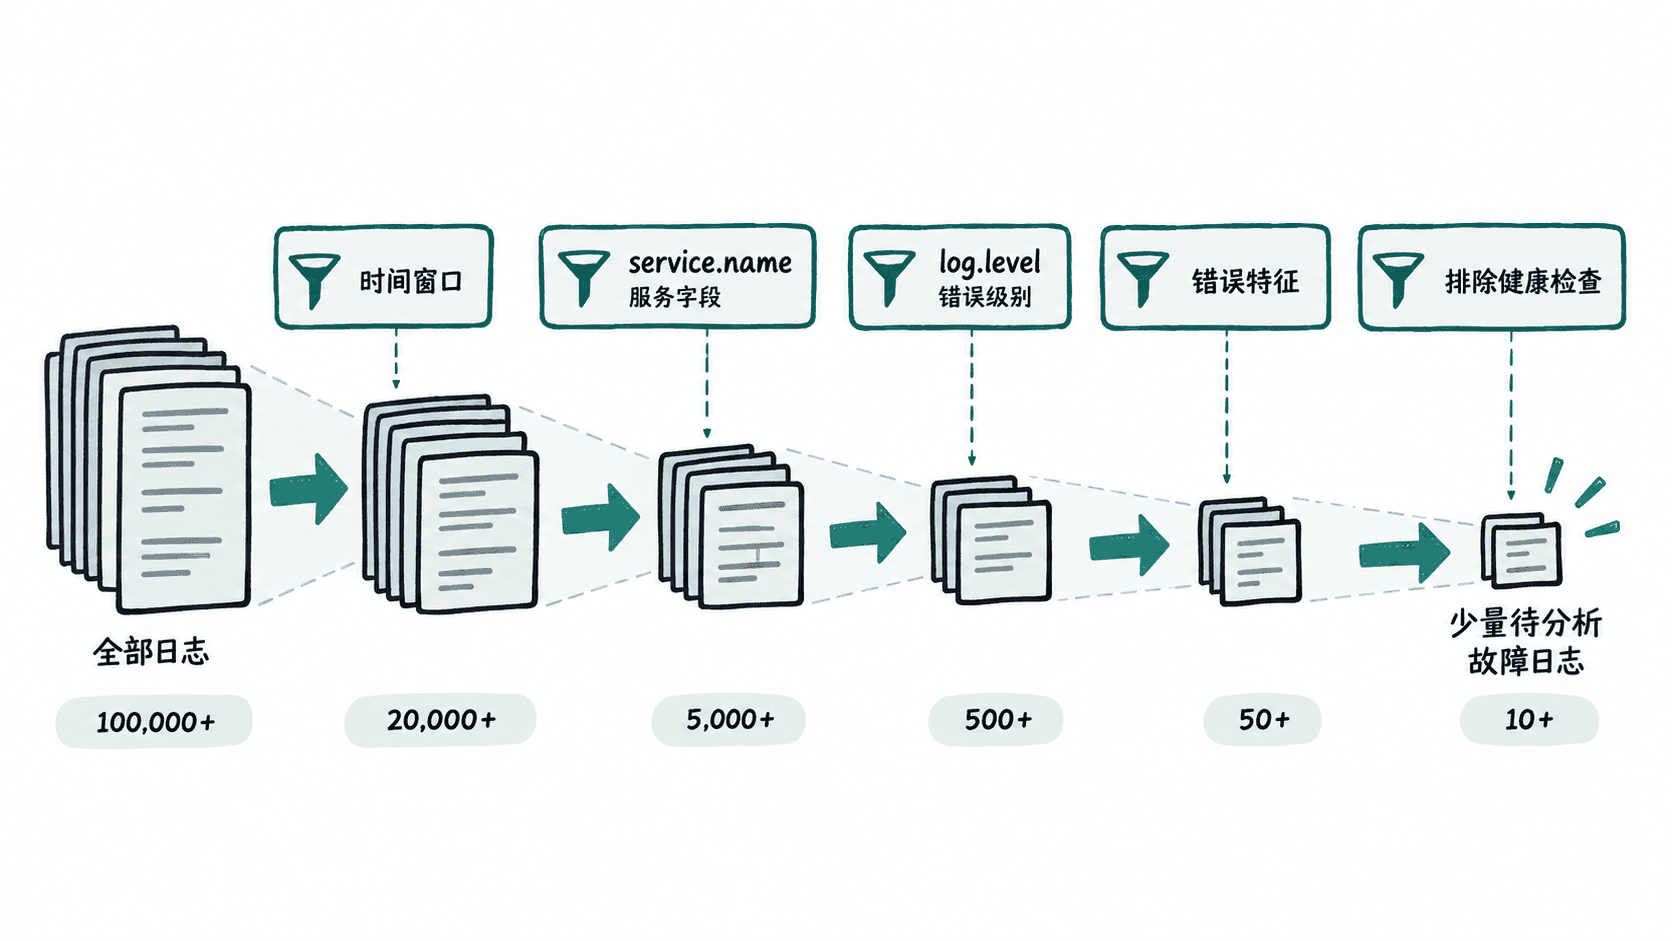
这种方式还有一个重要好处:如果最终查询没有结果,可以逐步删除最末端条件,快速找到究竟是哪一个假设不成立。
查询结果不符合预期时
先检查时间窗口,因为 Kibana 中“没有日志”最常见的原因之一就是时间范围不覆盖故障发生时刻。然后确认字段名和实际文档一致,并检查字段值的大小写、类型以及日志是否完成结构化解析。
对于数值字段,应按数值查询。例如 http.response.status_code: 500 比把状态码当成任意文本关键词更明确。对于文本搜索,则应先确认目标字段是否适合这种查询方式。
KQL 最适合承担的是过滤:先用确定的信息把搜索空间缩小,再阅读少量日志寻找根因。真正高效的排障查询通常不是一次写出复杂表达式,而是从可靠条件开始,一层一层验证假设。