
可观测性与稳定性 / 系统课时
索引变只读后怎么恢复
索引变只读后怎么恢复
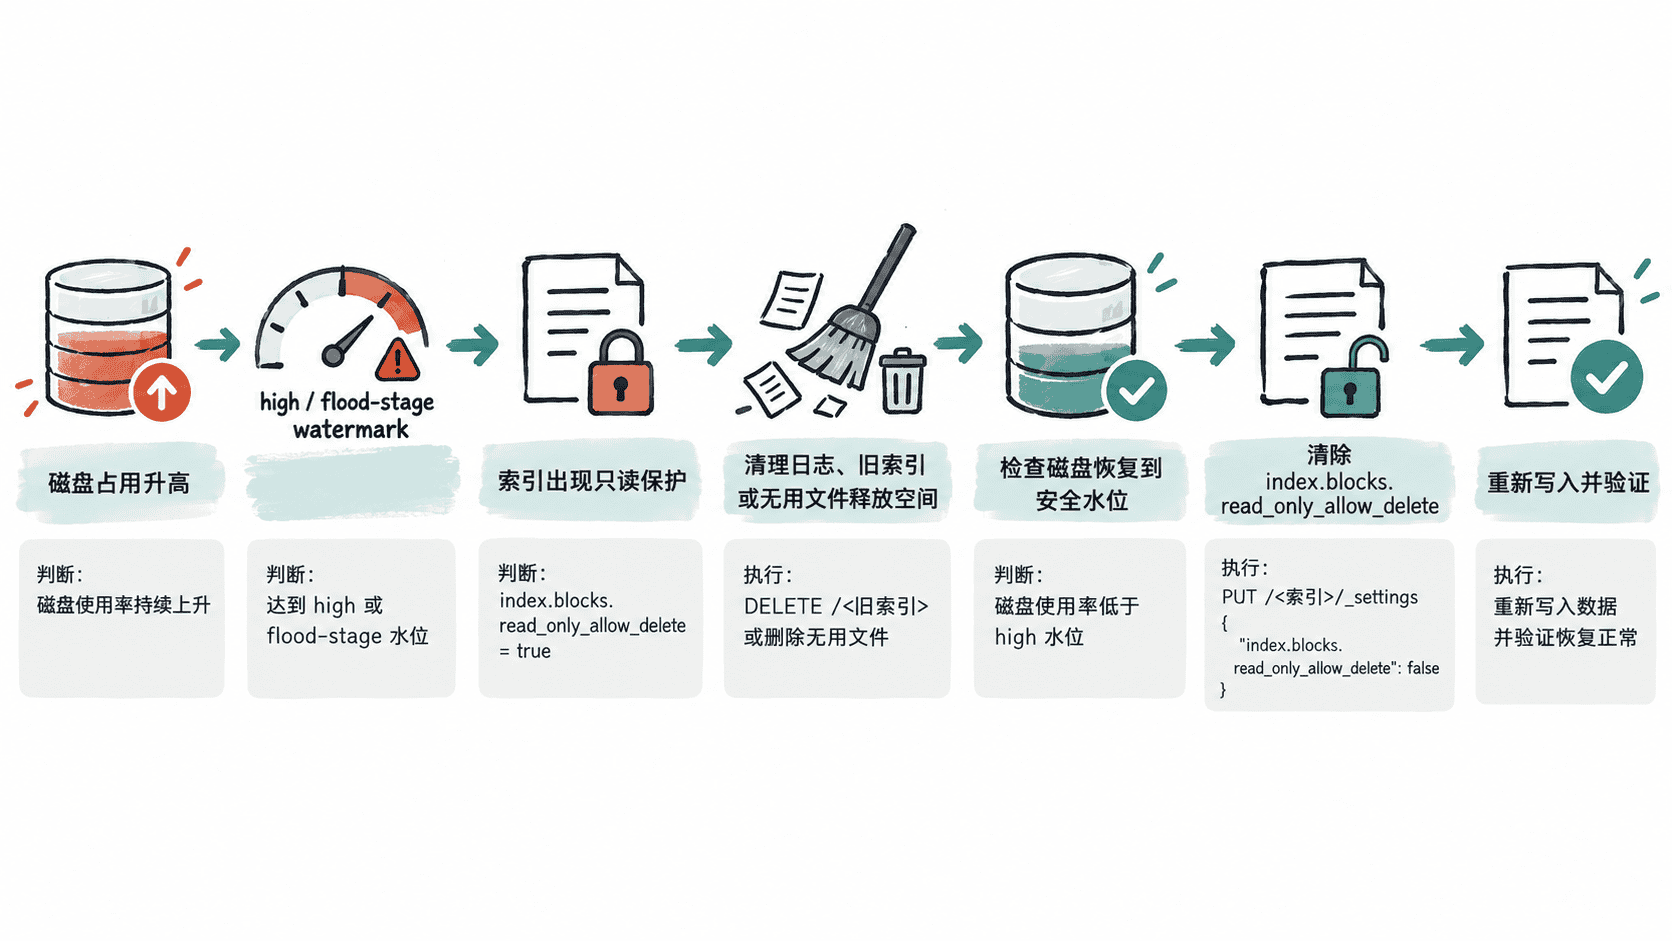
索引突然无法写入,常见现象是 Elasticsearch 返回 cluster_block_exception 或提示索引处于只读保护。恢复的关键不是直接强行解锁,而是先确认磁盘水位,再释放空间、解除写保护,最后用一次真实写入验证恢复链路。
学习目标
- 能从磁盘使用率和集群设置判断是否由磁盘水位触发保护
- 能安全释放空间并解除索引只读状态
- 能通过写入验证确认业务恢复,而不是只看到状态变化
先判断是不是磁盘水位
先检查各节点文件系统空间。Elasticsearch 的磁盘水位保护是为了避免磁盘继续被写满,因此看到只读索引时,第一件事应是确认节点磁盘,而不是立即修改索引设置。
df -h
curl -s "http://<HOST>:<PORT>/_cat/allocation?v"
预期结果
Filesystem      Size  Used Avail Use% Mounted on
/dev/sda1       200G  188G   12G  95% /

shards disk.indices disk.used disk.avail disk.total disk.percent host    node
...    ...          ...       12gb       200gb      95          ...     ...
实际节点、挂载点和数值会不同。重点观察承载数据目录的文件系统是否接近或超过配置的高水位、flood-stage 水位。
先释放空间,再解除限制
空间处理应优先解决根因。可以删除已经确认不再需要的历史索引、清理无关文件或扩容数据盘;不要为了让写入立刻恢复而长期保留接近满盘的状态。尤其不要直接删除 Elasticsearch 数据目录中的文件,这会绕过正常的索引与分片管理。
处理后再次验证:
df -h
curl -s "http://<HOST>:<PORT>/_cluster/health?level=indices"
预期结果
Filesystem      Size  Used Avail Use% Mounted on
/dev/sda1       200G  160G   40G  80% /

{"cluster_name":"<CLUSTER>","status":"green",...}
集群健康为 green 并不是解除只读的唯一条件;单节点或有未分配分片的环境可能出现其他状态,因此还要单独检查受影响索引。
解除索引写保护
确认空间问题已经处理后,再检查具体索引设置:
curl -s "http://<HOST>:<PORT>/<INDEX>/_settings?filter_path=*.settings.index.blocks.read_only_allow_delete"若确认是磁盘保护留下的只读设置,可以清除该设置:
curl -s -X PUT "http://<HOST>:<PORT>/<INDEX>/_settings" \
  -H 'Content-Type: application/json' \
  -d '{"index.blocks.read_only_allow_delete":null}'
预期结果
{"acknowledged":true}这里的重点是 null:它用于清除该设置,而不是把它设置成 false。如果索引同时存在其他 block,或者集群仍处于磁盘保护状态,单次解除操作不代表问题已经结束。
用真实写入确认恢复
最后不要只依赖 _settings 的返回结果。发送一条测试文档,验证从客户端到索引写入的实际路径已经恢复。
curl -s -X POST "http://<HOST>:<PORT>/<INDEX>/_doc" \
  -H 'Content-Type: application/json' \
  -d '{"recovery_check":true,"checked_at":"<TIME>"}'
预期结果
{"_index":"<INDEX>","_id":"<ID>","result":"created",...}测试文档产生后,应该按你们的生命周期策略处理它,不要让排障数据长期混入业务索引。若写入仍失败,继续查看返回错误中的具体 block 名称和索引名称,再判断是否还有其他保护条件。
哪些操作不要混在一起
磁盘告警、索引只读和分片未分配是三个不同层次的问题。清理空间解决的是资源边界;解除 read_only_allow_delete 解决的是索引写保护;分片异常则需要单独通过 allocation 原因定位。把三者混为一谈,容易出现“命令成功但业务仍写不了”的假恢复。
恢复完成后,至少保留一次磁盘使用率、受影响索引和成功写入的验证证据。这样下一次再次出现只读时,可以快速区分是空间再次触顶,还是出现了新的索引阻塞原因。