
可观测性与稳定性 / 系统课时
从故障现象建立排查证据链
从故障现象建立排查证据链
线上故障排查最怕“看了一堆日志,却不能证明根因”。更有效的方法是把健康接口、组件日志、运行指标和查询结果按时间与因果关系串起来:先确认故障存在,再定位发生层,最后用独立证据交叉验证结论。
学习目标
- 能把健康状态、日志、指标和查询结果组织成一条证据链
- 能区分直接现象、相关信号和能够支持根因的证据
- 能形成可复用的故障记录,方便复盘与再次排查
先固定故障边界
先记录故障开始时间 <TIME>、受影响服务、症状和当前状态。不要一开始就围绕某条 ERROR 日志展开推测,因为一条异常日志只能说明“发生过异常”,不能单独证明它造成了用户侧故障。
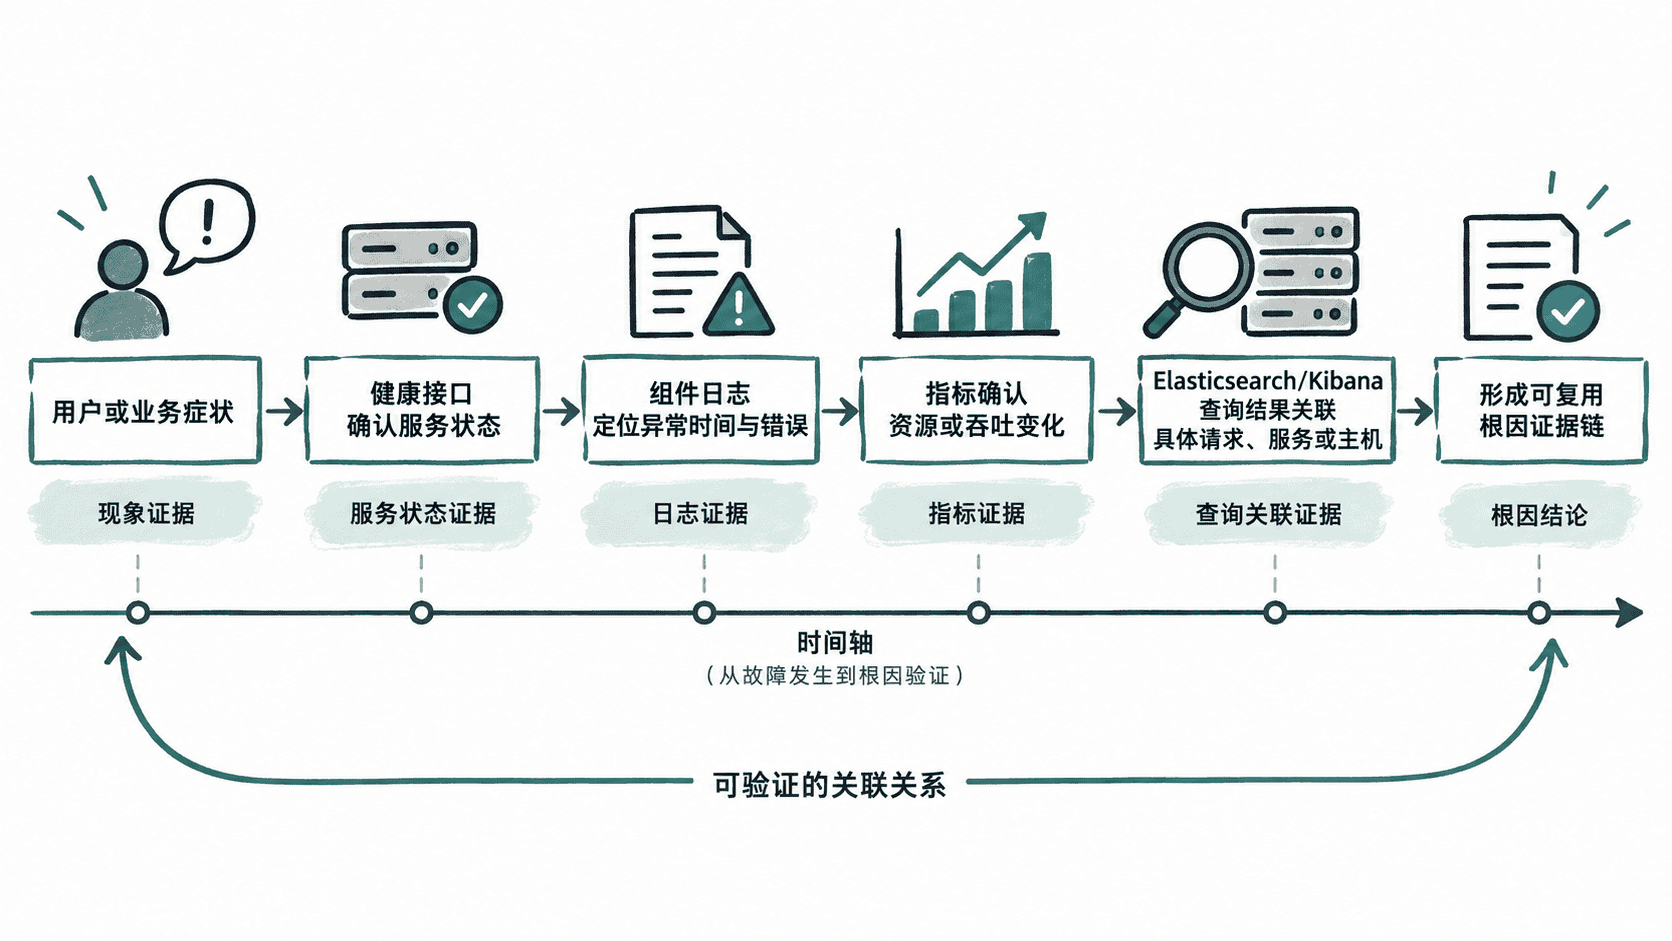
建议先做一份最小事实记录,再开始深入分析:用户看到什么、什么时候开始、影响哪些服务、健康接口是什么状态、日志是否同步出现异常,以及指标有没有同一时间窗口的变化。
健康接口证明“故障在哪里”
健康接口适合确认服务是否还能响应,但不能单独证明业务逻辑正确。Elasticsearch 可以通过 cluster health API 查看整体状态,也可以进一步限定具体索引或数据流。([Elastic][3])
curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cluster/health?format=json"

curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cluster/health/<PATH>?format=json"
预期结果
第一条请求返回集群的 status 以及节点、分片相关健康信息。
第二条请求返回指定索引或数据流对应的健康状态;实际 status 可能为 green、yellow 或 red。
如果健康接口正常,但用户查询仍失败,排查范围就不应停留在“集群有没有挂”,而应继续检查查询、字段、权限、下游组件或具体索引。
日志证明“发生了什么”
组件日志负责提供事件上下文,例如连接失败、认证失败、磁盘水位、分片恢复或查询异常。读取日志时重点建立时间关联:异常日志出现前后发生了什么,是否与用户症状在同一时间窗口内出现,是否有重复模式。
journalctl -u elasticsearch \
  --since "<TIME>" \
  --until "<TIME>" \
  --no-pager | tail -n 80
预期输出
输出指定时间窗口内 Elasticsearch systemd 服务日志的最后若干行;实际日志内容取决于节点运行状态和日志级别。日志中的 ERROR、WARN 不是根因标签。应继续寻找能与其他证据对上的具体事实,例如某索引持续增长、某节点磁盘接近水位、某类查询在同一时段大量超时。
指标和查询负责交叉验证
指标用来回答“系统行为有没有同步变化”,查询则用来回答“问题具体落在哪些数据或对象”。例如日志平台出现查询变慢时,可以比较请求耗时、节点资源、分片数量和实际命中索引;不要只凭一项指标下结论。
curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cat/indices?v=true&s=store.size:desc"

curl -sS -u "$ES_USER:$ES_PASSWORD" \
  "$ELASTICSEARCH_URL/_cat/shards?v=true&h=index,shard,prirep,store,node"
预期输出
indices API:返回索引级文档与存储信息,可用于比较哪些索引异常变大。
shards API:返回分片所在节点及存储大小,可用于发现特定节点或索引的分片集中情况。
当“用户查询变慢”“某时段请求耗时上升”“某节点资源异常”“某索引分片明显偏大”能够在同一时间窗口互相对应时,证据链才开始具备因果分析价值。
用四类证据写出可复用结论
一份好的故障记录不需要堆满截图,而要把每个结论对应到具体证据。可以按“现象 → 时间 → 健康状态 → 日志事件 → 指标变化 → 查询验证 → 修复结果”记录。这样下次遇到相似故障时,可以直接复用同一条验证路径。
例如最终结论应写成“<TIME> 至 <TIME> 查询延迟升高,同时某节点磁盘使用率快速上升,异常索引存储增长集中在该时间窗口,清理过期索引后磁盘回落且查询延迟恢复”,而不是简单写成“可能是 Elasticsearch 有问题”。前者能够被另一位工程师重新验证,后者只能算猜测。
收尾时保留原始查询、关键时间窗口和修复后的验证结果。证据链的价值不只是定位这一次故障,更在于让下一次排查从可重复的事实开始,而不是从个人经验和印象开始。