
可观测性与稳定性 / 系统课时
日志量怎样换算存储容量
日志量怎样换算存储容量
日志平台不能只按“每天写入多少 GB”购买磁盘。保留周期、副本、索引结构、高水位和增长余量都会放大最终需求。本节建立一个可复算的容量模型,并用实际数字完成一次 Elasticsearch 磁盘估算。
学习目标
- 根据每日写入量和保留周期计算基础数据量
- 理解副本、索引开销和安全余量如何影响磁盘需求
- 用可重复执行的计算方法评估容量并识别模型边界
从每日写入量建立容量模型
最基础的输入是每天最终进入 Elasticsearch 的数据量,而不是应用原始日志文件大小。经过 Logstash 或其他采集链路后,字段解析、JSON 结构、字段名重复以及 _source、倒排索引、doc values 等都会影响实际索引占用。
可以先使用下面的规划模型:
其中 是每日索引写入量, 是保留天数, 是副本数, 是索引存储相对每日输入量的经验系数, 是为磁盘水位、增长和运维操作预留的安全系数。
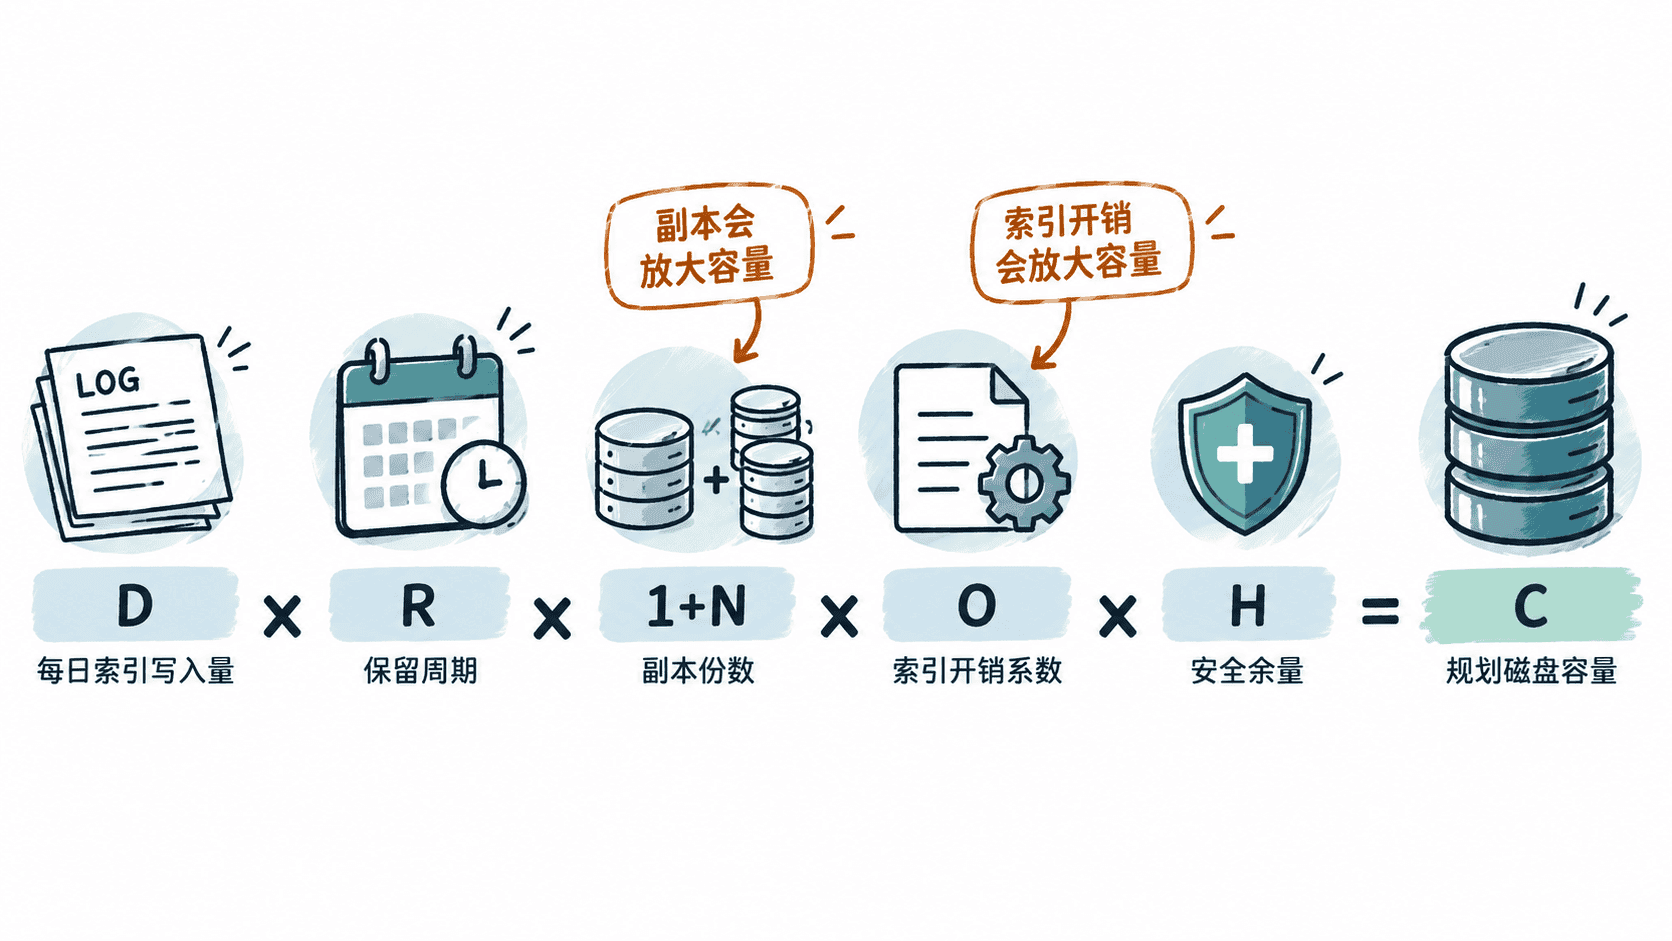
这个公式用于规划而不是精确预测。生产环境应优先使用现有索引的真实磁盘占用校准 ,而不是长期依赖固定经验值。
完成一次容量估算
假设每天实际写入索引 120 GB,需要保留 30 天,配置 1 个副本。根据现有同类索引测量,索引实际磁盘占用约为输入量的 1.15 倍;再按 1.25 倍预留水位和增长空间。
下面用 Python 保留计算过程,便于调整参数后重新估算:
daily_gb = 120
retention_days = 30
replicas = 1
index_overhead = 1.15
headroom = 1.25

primary_gb = daily_gb * retention_days
with_replicas_gb = primary_gb * (1 + replicas)
required_gb = with_replicas_gb * index_overhead * headroom

print(f"primary={primary_gb:.0f} GB")
print(f"with_replicas={with_replicas_gb:.0f} GB")
print(f"planned={required_gb:.0f} GB")
预期输出:
primary=3600 GB
with_replicas=7200 GB
planned=10350 GB
因此这组假设下应按约 10.35 TB 的可用磁盘空间规划,而不是只看到 120 GB × 30 天得到 3.6 TB。这里的 TB 按十进制容量换算,即 1000 GB = 1 TB。
不要把安全余量当成可写空间
Elasticsearch 节点磁盘接近水位阈值时会触发分片迁移等磁盘保护行为,因此容量设计不能以“磁盘写满”为目标。扩容、分片迁移、段合并和短期流量增长也需要临时空间。
如果有 5 个数据节点,上例的 10.35 TB 也不能简单理解成每台恰好使用 2.07 TB 就足够。还要检查分片是否能够均衡分布,以及单节点故障后剩余节点是否有能力承接重新分配的数据。
用真实索引修正估算
上线后最有价值的数据来自实际集群。可以查看索引级存储统计,比较一段稳定周期内的业务写入量与 Elasticsearch 实际占用,再更新容量模型。
curl -s "http://<HOST>:<PORT>/_cat/indices?v&h=index,pri,rep,docs.count,store.size,pri.store.size"预期输出的具体索引名、文档数和容量取决于实际集群,结构类似:
index                 pri rep docs.count store.size pri.store.size
logs-app-<ID>           3   1    <ID>       <SIZE>        <SIZE>
其中 pri.store.size 更适合观察主分片自身的数据规模,store.size 则包含副本后的总存储规模。实际值会随文档内容、mapping、删除和段合并状态变化。
容量估算最终应形成持续校准过程:先用每日写入量、保留周期和副本得到基线,再用真实索引占用修正开销系数,并为水位、故障恢复和增长留下空间。这样得到的数字才适合用于节点数量和磁盘规格规划。