
可观测性与稳定性 / 系统课时
数据流适合哪些日志场景
数据流适合哪些日志场景
日志天然具有持续追加、按时间查询和定期淘汰的特点。Elasticsearch data stream 把多个后备索引组织成一个稳定的逻辑入口,并配合 rollover 持续产生新索引,适合长期写入的时序日志。
学习目标
- 理解 data stream、写索引与后备索引之间的关系
- 能判断日志是否适合使用 data stream
- 能创建最小 data stream 并验证写入行为
数据流不是单个索引
应用写入 data stream 时,不需要知道当前实际写入哪个后备索引。data stream 维护一组隐藏的 backing indices,其中只有当前 write index 接收新文档;发生 rollover 后,新后备索引成为 write index,旧索引继续承担历史查询。
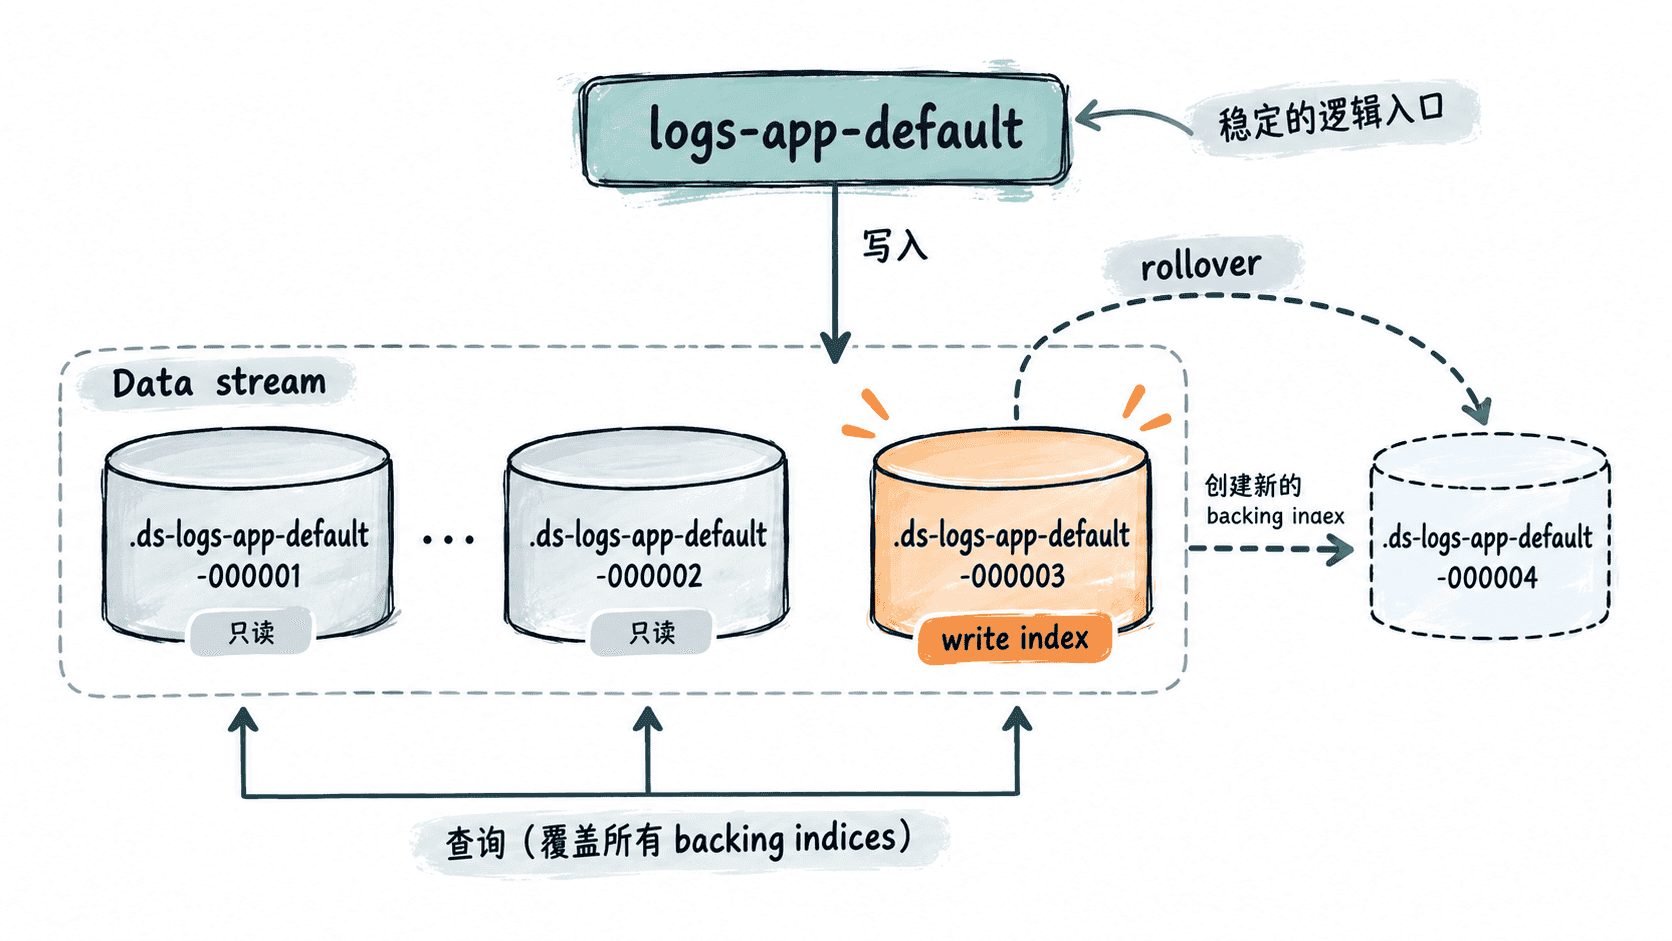
这种模型把“应用写到哪里”和“物理索引如何滚动”分离。采集端持续面向同一个 data stream 写入,索引滚动和生命周期策略则在存储侧管理。
哪些日志适合 data stream
data stream 面向时序数据,日志通常是最典型的场景。适合的数据一般同时具备几个特征:文档不断追加;每条文档具有时间戳;查询主要围绕时间范围展开;旧数据最终可以按照保留策略删除。
例如 Web 访问日志、应用运行日志、安全审计日志和基础设施事件都常符合这个模型。data stream 中的文档需要包含 @timestamp 字段,它用于表达时序数据的时间信息。
如果业务主要频繁按照文档 ID 原地更新、删除单条记录,或者数据本质是当前状态而不是历史事件,普通索引通常更直接。data stream 的核心优势来自追加型时序数据,而不是因为它比普通索引“更新”。
创建并写入一个数据流
创建 data stream 前,需要先建立匹配它的索引模板,并在模板中声明 data_stream。下面使用 logs-app-* 作为匹配模式。
curl -X PUT "http://localhost:9200/_index_template/logs-app-template" \
  -H "Content-Type: application/json" \
  -d '{
    "index_patterns": ["logs-app-*"],
    "data_stream": {},
    "template": {
      "mappings": {
        "properties": {
          "@timestamp": { "type": "date" },
          "level": { "type": "keyword" },
          "message": { "type": "text" }
        }
      }
    }
  }'
curl -X PUT "http://localhost:9200/_data_stream/logs-app-default"
预期输出:两个请求成功时都会返回确认结果。
{"acknowledged":true}随后通过 data stream 名称写入日志。追加事件时使用 create 操作,并为文档提供 @timestamp。
curl -X POST "http://localhost:9200/logs-app-default/_doc?op_type=create" \
  -H "Content-Type: application/json" \
  -d '{
    "@timestamp": "2026-09-20T00:00:00Z",
    "level": "ERROR",
    "message": "database connection timeout"
  }'
预期结果:HTTP 请求成功后,响应中的 result 为 created,并包含 Elasticsearch 分配的动态 _id 和实际后备索引名称;这些动态值每次可能不同。
HTTP 201
result: created
_id: <ID>
_index: <BACKING_INDEX>
查看逻辑入口与后备索引
应用通常只需要使用 data stream 名称,但运维排查时要能确认当前有哪些后备索引以及 generation 是否发生变化。
curl "http://localhost:9200/_data_stream/logs-app-default"预期结果:响应中的 data stream 名称为 logs-app-default,并列出当前 backing indices。具体索引名称和 generation 会随 rollover 次数变化。
name: logs-app-default
backing indices: <BACKING_INDEX> ...
generation: <ID>什么时候选择它
判断时可以抓住一个核心问题:这批数据是不是不断追加的时间序列事件? 如果采集端需要长期使用稳定名称写入,存储端又需要持续滚动索引并管理历史数据,data stream 很契合。
如果数据需要大量随机更新,或者索引名称本身承担明确业务语义并需要由应用直接控制,则普通索引可能更合适。选择 data stream 的目的,是让时序日志的写入入口、后备索引滚动和后续生命周期管理形成稳定模型,而不是简单换一种索引命名方式。