
可观测性与稳定性 / 系统课时
故障看板该放哪些指标
故障看板该放哪些指标
排障看板不是把能统计的数据全部摆上屏幕,而是要让值班人员迅速判断“什么时候开始异常、影响哪个服务、集中在哪里、发生了什么”。本节从故障定位路径出发设计日志看板,并给出可直接验证的 Elasticsearch 查询。
学习目标
- 选择真正服务于故障定位的日志指标
- 按趋势、范围和事件三个层次组织看板
- 避免平均值、总量和高基数字段造成误导
看板要回答四个问题
面向排障的日志看板首先要支持判断异常时间,其次确认影响范围,再找到异常集中的服务或主机,最后回到具体事件。一个实用的首屏通常围绕四类信息组织:错误趋势、错误率或错误数量、服务与主机分布、关键错误事件。
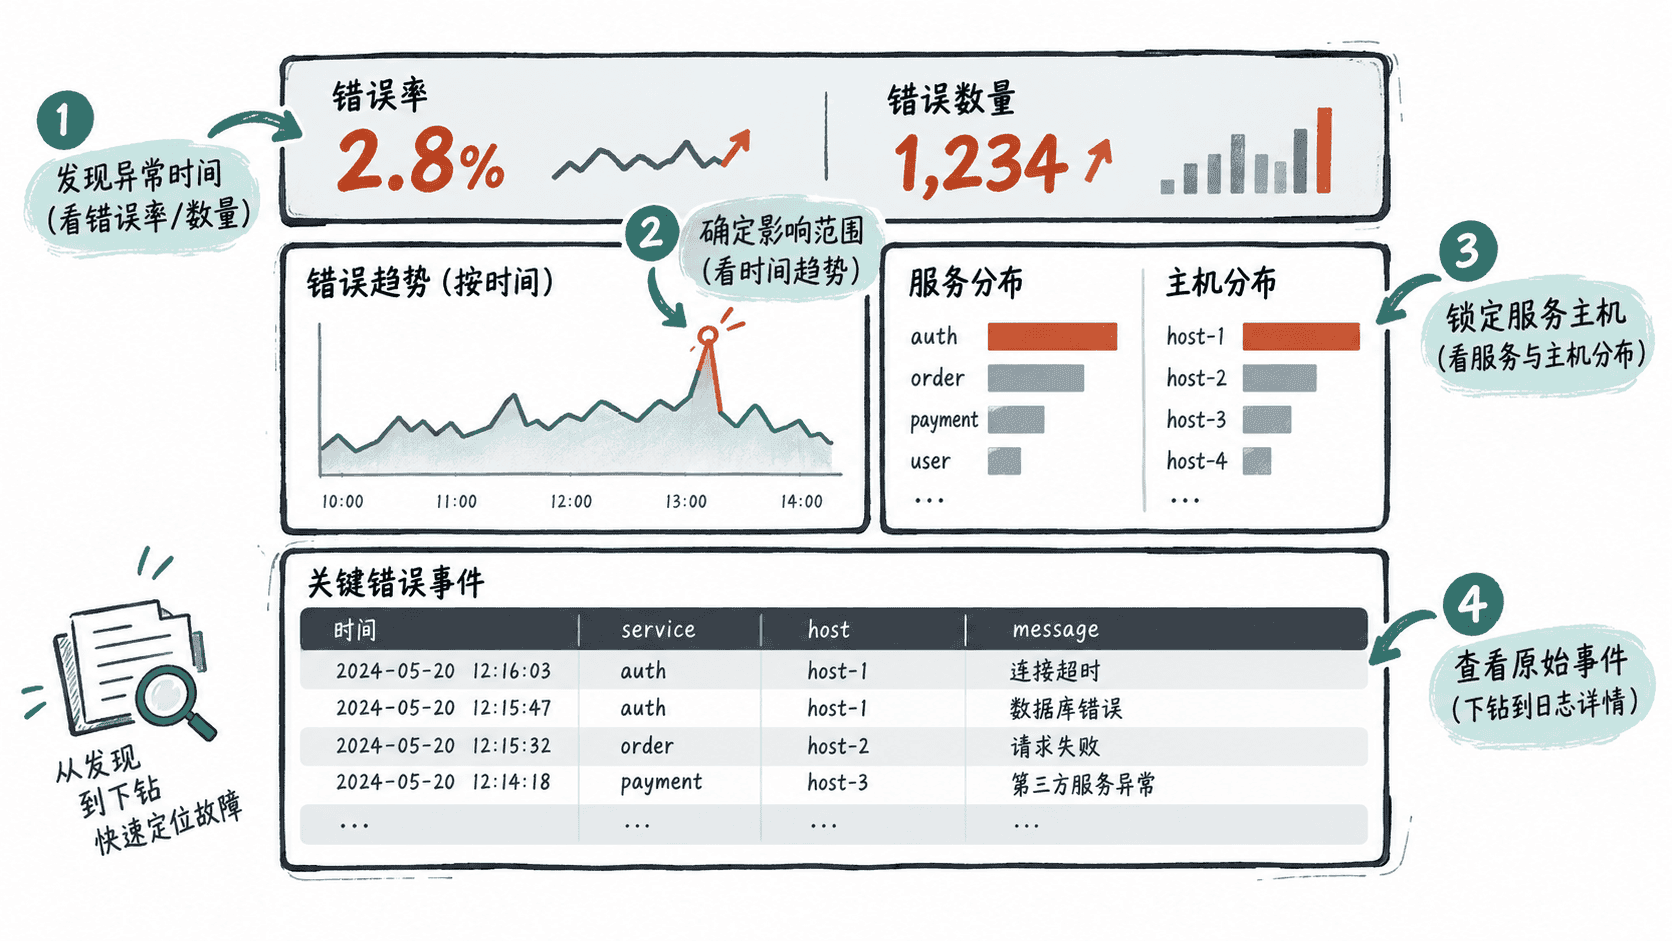
首屏指标如何取舍
错误趋势应该放在最容易看到的位置。总错误数只能说明规模,而按分钟或固定时间间隔绘制的趋势能显示故障从何时开始、是否持续扩大以及修复后是否回落。若各服务日志量差异很大,还应同时展示错误率。
服务分布用于回答“谁受影响”,主机或实例分布用于回答“是否集中在少数节点”。关键事件区域则保留时间、服务、主机、错误类型和简短消息,使值班人员能从统计结果直接回到原始证据。
| 区域 | 推荐指标 | 排障问题 |
|---|---|---|
| 状态摘要 | 错误数、错误率 | 当前是否异常 |
| 时间趋势 | 每个时间桶的错误数或错误率 | 异常何时开始 |
| 影响范围 | 按服务、主机分组的错误数 | 问题集中在哪里 |
| 关键事件 | 最新错误及关键字段 | 具体发生了什么 |
用查询验证趋势数据
在制作可视化之前,可以先用 Elasticsearch 查询确认数据是否足以支撑图表。下面只统计最近一小时的 ERROR 日志,并按固定 5 分钟间隔分桶。
POST logs-*/_search
{
  "size": 0,
  "query": {
    "bool": {
      "filter": [
        { "term": { "log.level": "ERROR" } },
        { "range": { "@timestamp": { "gte": "now-1h", "lte": "now" } } }
      ]
    }
  },
  "aggs": {
    "error_trend": {
      "date_histogram": {
        "field": "@timestamp",
        "fixed_interval": "5m",
        "min_doc_count": 0
      }
    }
  }
}
预期结果
{
  "aggregations": {
    "error_trend": {
      "buckets": [
        {
          "key_as_string": "<TIME>",
          "doc_count": 3
        },
        {
          "key_as_string": "<TIME>",
          "doc_count": 27
        }
      ]
    }
  }
}
<TIME> 代表实际时间桶起点,数量也由真实日志决定。若连续几个桶从正常基线突然升高,这种趋势通常比一个“最近一小时共多少错误”的单值更有定位价值。
让看板能够继续下钻
看板上的图表应该共享可用于过滤的结构化字段,例如 service.name、host.name、log.level 和 @timestamp。发现某个服务异常后,应能把该服务作为过滤条件继续观察主机分布和原始事件,而不是重新输入一套完全不同的查询。
关键事件列表不宜展示完整日志文档。优先保留时间、服务、主机、错误类型、追踪标识以及消息摘要;需要上下文时再打开单条日志。这样既减少视觉噪声,也能保留从聚合统计进入具体请求链路的入口。
避免让指标掩盖故障
只展示全局平均值容易隐藏局部故障。例如十个实例中只有一个实例持续报错,全局错误率可能仍然很低,因此主机或实例维度必须能够下钻。另一方面,请求 ID、堆栈全文等高基数字段不适合作为首页分组指标,否则桶数量巨大且难以形成判断。
看板完成后应做一次故障场景验收:选择一段已知异常时间,确认能从趋势发现异常,再从服务分布缩小范围,并最终找到对应原始事件。能完成这条定位路径,比单纯增加更多图表更能说明看板真正适合线上排障。