
可观测性与稳定性 / 系统课时
索引分片和副本该怎么规划
索引分片和副本该怎么规划
Elasticsearch 的分片数量一旦规划失衡,既可能让单个分片过大、恢复缓慢,也可能产生大量小分片消耗集群资源。本节从数据规模、节点数量和容错目标出发,确定主分片与副本数量,并用 API 验证实际分布。
学习目标
- 区分主分片与副本分片各自解决的问题
- 根据数据量、节点数量和可用性要求规划分片
- 创建索引并验证分片是否按预期分配
主分片和副本承担不同职责
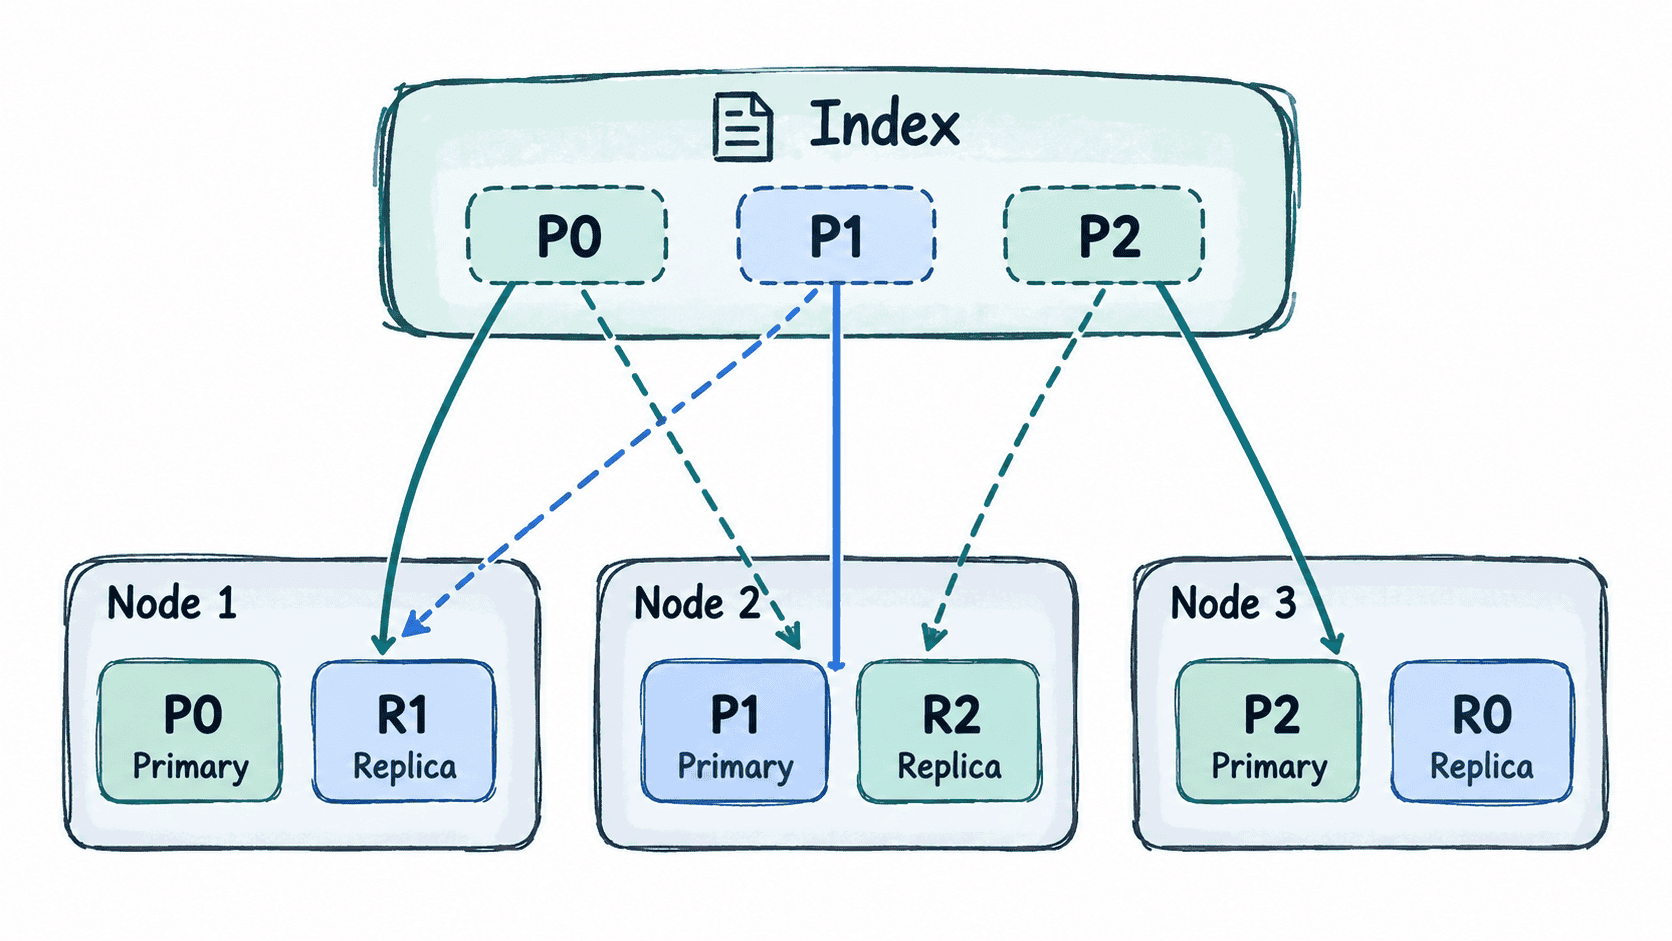
一个 Elasticsearch 索引会被拆成若干主分片。写入文档时,文档最终进入某个主分片,因此主分片数量决定了索引数据被拆成多少份。副本则复制主分片的数据,用于节点故障后的可用性,并可参与搜索请求。
例如索引设置为 3 个主分片、1 个副本,每个主分片都有一份副本,总计存在 6 个分片副本实例。Elasticsearch 不会把某个主分片和它自己的副本放到同一个节点,否则该节点故障时两份数据会同时丢失。
从数据规模确定主分片
规划时不要先问“最多能建多少分片”,而应估算索引在保留周期内的数据量,再决定拆分粒度。假设某个日志索引预计达到 120 GB,希望单个主分片控制在约 30 GB,则可以先以 4 个主分片作为容量估算起点。
分片大小没有适用于所有集群的固定最佳值。日志字段数量、查询模式、硬件性能、合并压力和恢复时间都会影响结果,因此应通过生产负载测试和监控继续调整。尤其不要为了未来可能增长而预先创建大量空分片,因为每个分片都需要占用一定的堆内存、文件句柄和集群管理资源。
从可用性确定副本
副本数量首先受可用性目标和数据节点数量约束。设置 1 个副本表示每个主分片需要额外保存一份副本;要让主分片和副本都能正常分配,至少需要两个能够承载这些分片的节点。
只有一个数据节点却配置 1 个副本时,主分片可以正常工作,但副本无法与主分片同节点分配,集群通常会保持 yellow。增加副本还会增加存储占用和写入复制成本,因此不是越多越好。
对于普通日志场景,可以先根据“允许同时失去多少份分片副本”和节点故障域设计副本,再结合容量与查询压力验证。跨可用区部署时,还应配合分片分配感知等机制,避免多份数据集中到同一故障域。
创建并验证索引
下面创建一个具有 3 个主分片、1 个副本的示例索引。将 <HOST> 和 <PORT> 替换为实际 Elasticsearch 地址和端口。
curl -X PUT "http://<HOST>:<PORT>/app-logs" \
  -H "Content-Type: application/json" \
  -d '{
    "settings": {
      "number_of_shards": 3,
      "number_of_replicas": 1
    }
  }'
预期输出
{"acknowledged":true,"shards_acknowledged":true,"index":"app-logs"}随后查看索引设置,确认配置实际生效。
curl -s "http://<HOST>:<PORT>/app-logs/_settings?filter_path=*.settings.index.number_of_shards,*.settings.index.number_of_replicas"预期输出
{"app-logs":{"settings":{"index":{"number_of_shards":"3","number_of_replicas":"1"}}}}还可以查看每个分片当前落在哪个节点。
curl -s "http://<HOST>:<PORT>/_cat/shards/app-logs?v"预期结果中应能看到分片编号、p 或 r 角色以及所在节点。节点名、状态顺序和具体行顺序取决于实际集群,因此实际值可能不同;关键是每个分片编号存在一个主分片,并在资源和分配规则允许时存在对应副本。
调整时分清哪些设置可直接修改
副本数量可以在线调整。例如将副本从 1 改为 2,可修改索引设置并观察重新分配过程。
curl -X PUT "http://<HOST>:<PORT>/app-logs/_settings" \
  -H "Content-Type: application/json" \
  -d '{"index":{"number_of_replicas":2}}'
预期输出
{"acknowledged":true}已有索引的主分片数量不能像副本数量一样通过修改 number_of_shards 直接改变。日志平台因此更适合在索引模板或数据流模板阶段规划新索引的分片设置;当容量预测明显变化时,让后续新索引采用新的规划,而不是持续累积一个越来越难管理的超大索引。