
可观测性与稳定性 / 系统课时
告警风暴怎么降噪
告警风暴怎么降噪
同一故障可能在几分钟内触发几十甚至上百条告警,短暂抖动也可能造成反复通知。本节用时间窗口、分组、阈值和恢复条件建立降噪规则,让真正需要处理的异常被看见,同时保留故障持续和恢复的信息。
学习目标
- 理解重复告警和抖动告警产生的原因
- 能用时间窗口、分组和阈值控制通知频率
- 能设计触发与恢复条件,避免告警状态来回切换
先区分事件和通知
日志平台持续产生事件,但事件出现不等于每次都要通知。例如某服务一分钟出现 30 条超时日志,如果规则对每条日志单独发送通知,就会形成告警风暴。更合理的做法是在一个时间窗口内聚合事件,再根据数量、服务和错误类型决定是否通知。
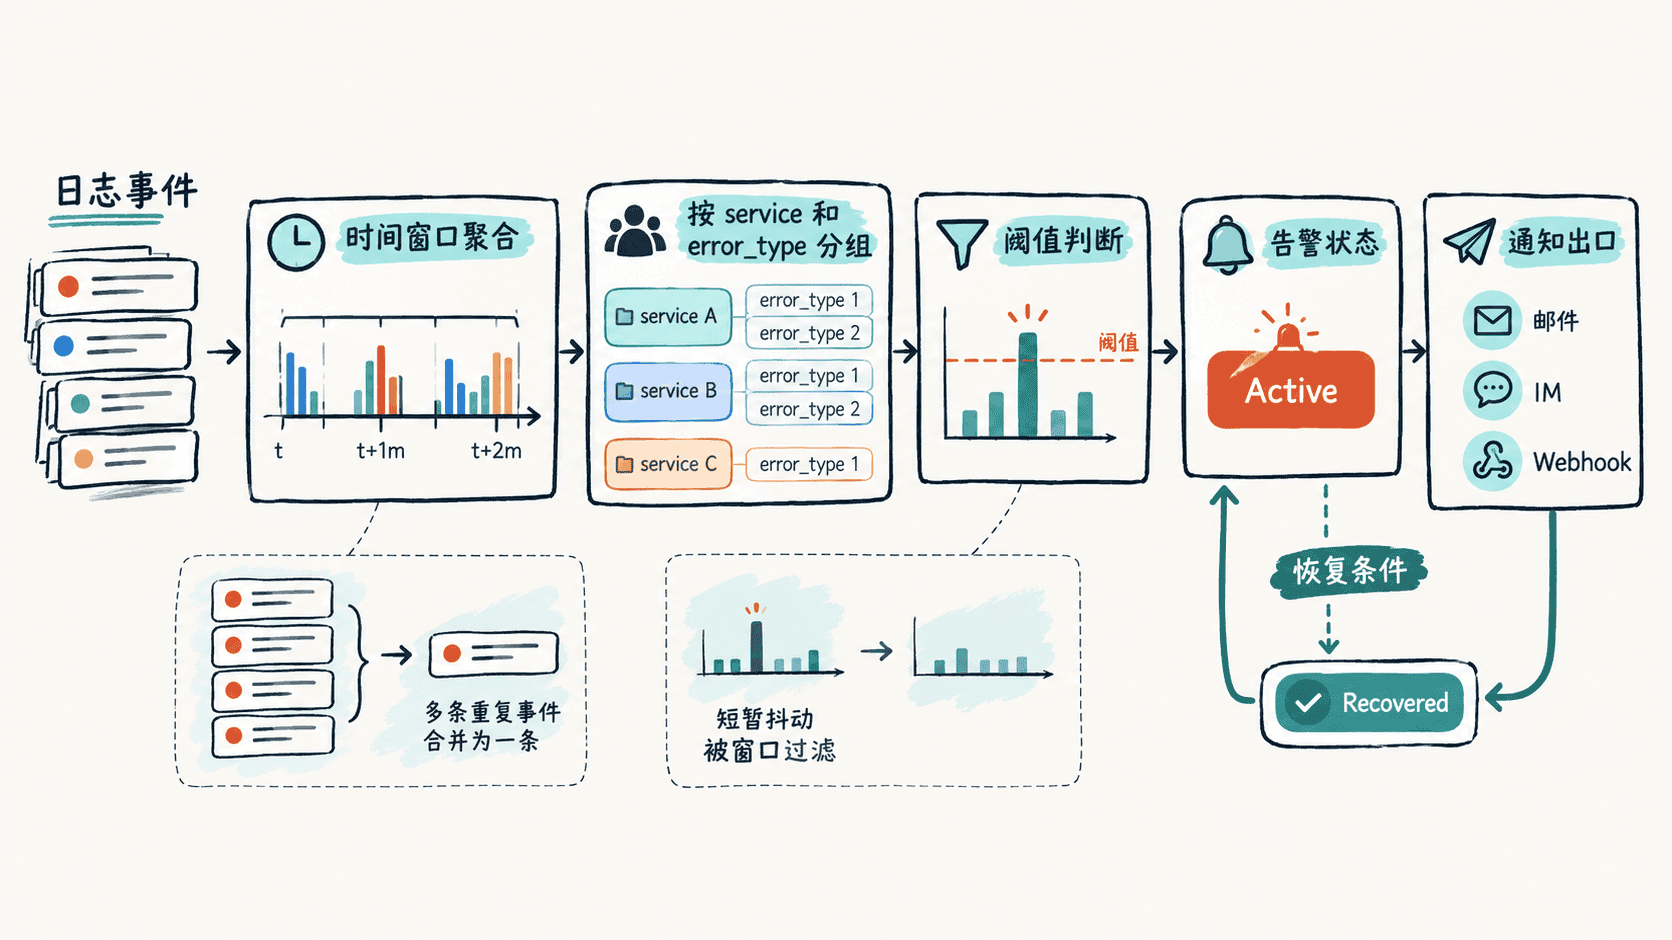
用窗口和分组合并重复异常
假设 Elasticsearch 中的日志包含 service.name、error.type 和 @timestamp。可以先用聚合查询观察最近 5 分钟每个服务、错误类型的数量,再据此设置告警阈值。
POST logs-*/_search
{
  "size": 0,
  "query": {
    "range": {
      "@timestamp": {
        "gte": "now-5m"
      }
    }
  },
  "aggs": {
    "by_service": {
      "terms": { "field": "service.name.keyword" },
      "aggs": {
        "by_error": {
          "terms": { "field": "error.type.keyword" }
        }
      }
    }
  }
}
预期结果:响应中的聚合桶会按服务和错误类型给出 doc_count;实际服务名、错误类型和数量取决于当前日志,因此不应把固定计数作为验证标准。
aggregations.by_service.buckets -> 每个服务的 doc_count 与对应错误类型桶窗口解决的是“多久统计一次”,分组解决的是“哪些事件算同一个问题”。生产环境通常选择能对应处置对象的稳定字段,例如服务名、错误类型或环境,不宜使用请求 ID 这类几乎每条日志都不同的字段,否则无法真正合并告警。
阈值要过滤偶发噪声
阈值的目标不是越高越好,而是区分偶发错误和需要介入的持续异常。例如可以规定“5 分钟内同一服务出现至少 20 次同类错误才进入告警状态”。阈值应结合正常基线确定,并观察低流量时段是否会漏掉严重但数量较少的问题。
用恢复条件抑制状态抖动
如果触发和恢复都使用同一临界值,指标在临界点附近波动时会不断产生“告警—恢复—告警”。可以采用不同的进入和退出条件,例如 5 分钟错误数达到 20 时触发,连续两个检查窗口低于 5 时才恢复。
这种设计形成滞回区间:进入告警需要明确恶化,退出告警需要确认稳定。通知系统还可以对处于 Active 状态的同一分组设置重复通知间隔,例如故障持续时每 30 分钟提醒一次,而不是每次检查都发送。
最终应分别验证三种场景:短暂尖峰不会通知,持续异常只产生受控频率的通知,异常消失并满足恢复条件后只发送一次恢复消息。这样减少的是重复信息,而不是对真实故障的可见性。