
可观测性与稳定性 / 系统课时
按容量和时间自动滚动数据
按容量和时间自动滚动数据
日志持续写入同一个索引,会让索引越来越大,也会增加维护和恢复成本。Rollover 可以在索引达到指定年龄、大小或文档数量后切换新的写入索引,让日志分段保持在可管理范围内。
学习目标
- 理解 rollover 的触发条件与写入切换机制
- 能通过别名创建可滚动索引并执行 rollover
- 能验证新索引是否已经成为写入索引
Rollover 实际切换了什么
Rollover 并不是清空旧索引,而是创建下一代索引,并把写入入口切换过去。旧索引仍可搜索,新日志进入新索引,因此应用不需要跟踪当前索引编号。
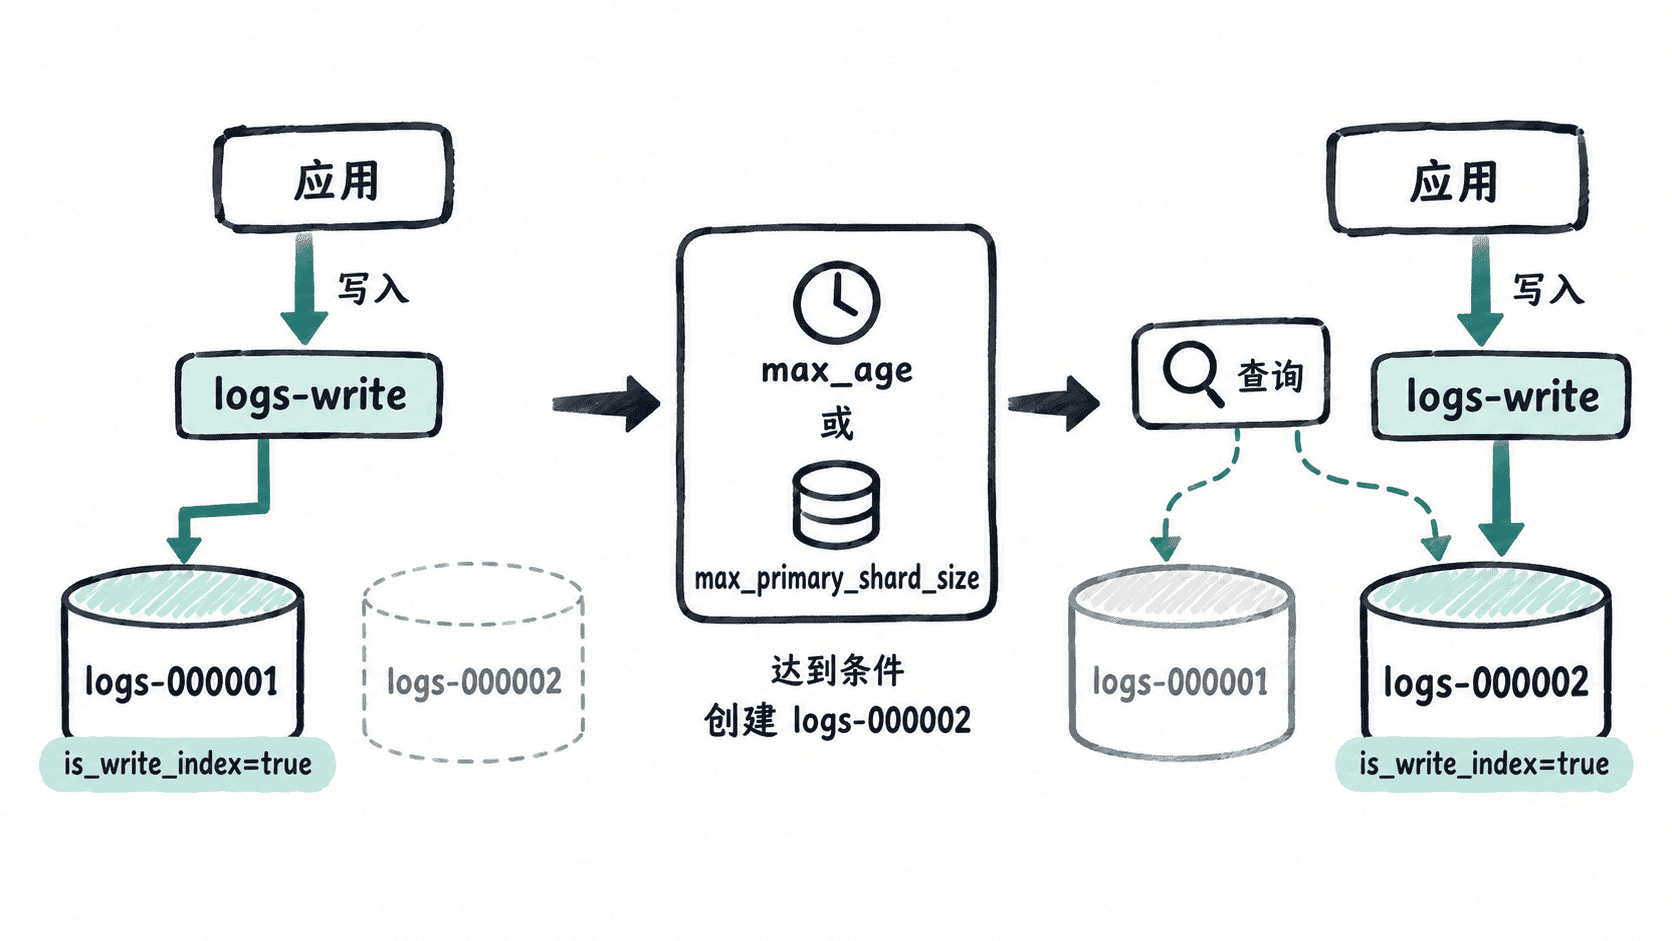
为了让 Elasticsearch 知道哪个索引负责接收写入,可以先创建带数字后缀的初始索引,并设置写入别名:
bash
curl -X PUT "http://localhost:9200/logs-000001" -H "Content-Type: application/json" -d '{
  "aliases": {
    "logs-write": {
      "is_write_index": true
    }
  }
}'
预期结果:
json
{"acknowledged":true,"shards_acknowledged":true,"index":"logs-000001"}设置滚动条件
调用 rollover API 时可以同时设置多个 max_* 条件。下面要求主分片达到 50 GB,或者索引创建满 1 天时滚动:
bash
curl -X POST "http://localhost:9200/logs-write/_rollover" -H "Content-Type: application/json" -d '{
  "conditions": {
    "max_primary_shard_size": "50gb",
    "max_age": "1d"
  }
}'
预期结果会包含条件判断和是否发生滚动;实际布尔值取决于索引当前状态:
json
{
  "old_index": "logs-000001",
  "new_index": "logs-000002",
  "rolled_over": false
}
max_* 条件之间采用满足任意一个即可滚动的语义,因此容量增长快的日志可以先按大小切换,低流量日志则能由时间条件保证不会长期停留在同一索引。
先演练再真正切换
生产环境修改条件前,可以使用 dry_run 查看当前是否满足条件,而不创建新索引:
bash
curl -X POST "http://localhost:9200/logs-write/_rollover?dry_run=true" -H "Content-Type: application/json" -d '{
  "conditions": {
    "max_age": "1d"
  }
}'
预期结果中的 dry_run 为 true,并通过 conditions 显示条件是否满足;具体索引名和条件布尔值随环境变化:
json
{
  "old_index": "logs-000001",
  "new_index": "logs-000002",
  "rolled_over": false,
  "dry_run": true,
  "conditions": {
    "[max_age: 1d]": false
  }
}
验证写入入口
发生 rollover 后,不要只确认新索引存在,还要确认别名的写入角色已经转移。可以查询别名:
bash
curl -s "http://localhost:9200/_alias/logs-write?pretty"预期结果在真正滚动后应显示旧索引仍关联别名,而新索引承担写入;索引名称以实际环境为准:
json
{
  "logs-000001": {
    "aliases": {
      "logs-write": {
        "is_write_index": false
      }
    }
  },
  "logs-000002": {
    "aliases": {
      "logs-write": {
        "is_write_index": true
      }
    }
  }
}
Rollover 解决的是何时停止继续扩大当前写入索引。它不会自动删除旧日志;如果还需要按保留周期迁移或清理历史数据,应把滚动规则交给 ILM 生命周期策略统一管理。
按自己的节奏,确认真正理解。