
可观测性与稳定性 / 系统课时
Filebeat 积压时先查哪里
Filebeat 积压时先查哪里
日志产生速度超过 Filebeat 的处理或下游接收能力时,会出现发送延迟、队列增长甚至采集停滞。排查重点不是先调大参数,而是判断瓶颈位于输入、内部队列、输出还是 Elasticsearch、Logstash 等下游。
学习目标
- 按输入、队列、输出和下游的顺序定位积压位置
- 使用 Filebeat 运行日志和下游状态区分采集慢与发送阻塞
- 在确认根因后选择限流、扩容或修复下游,而不是盲目扩大队列
先确认是不是正在积压
先观察 Filebeat 服务日志,而不是只看业务日志文件越来越大。以 systemd 部署为例,可以查看最近的 Filebeat 日志:
journalctl -u filebeat --since "10 min ago" --no-pager预期结果
<TIME> <HOST> filebeat[<ID>]: ...具体日志内容取决于 Filebeat 版本、配置和当前状态,因此不能用某一条固定文本判断积压。重点关注持续出现的输出连接失败、超时、重试以及 publisher 相关异常;<TIME>、<HOST>、<ID> 的实际值会不同。
沿采集链路定位瓶颈
Filebeat 的数据不是从文件直接跳到 Elasticsearch。事件先由 input 读取,再经过处理和内部队列,由 output 批量发送给下游。只看链路末端,很容易把 Elasticsearch 变慢误判成 Filebeat 读取能力不足。
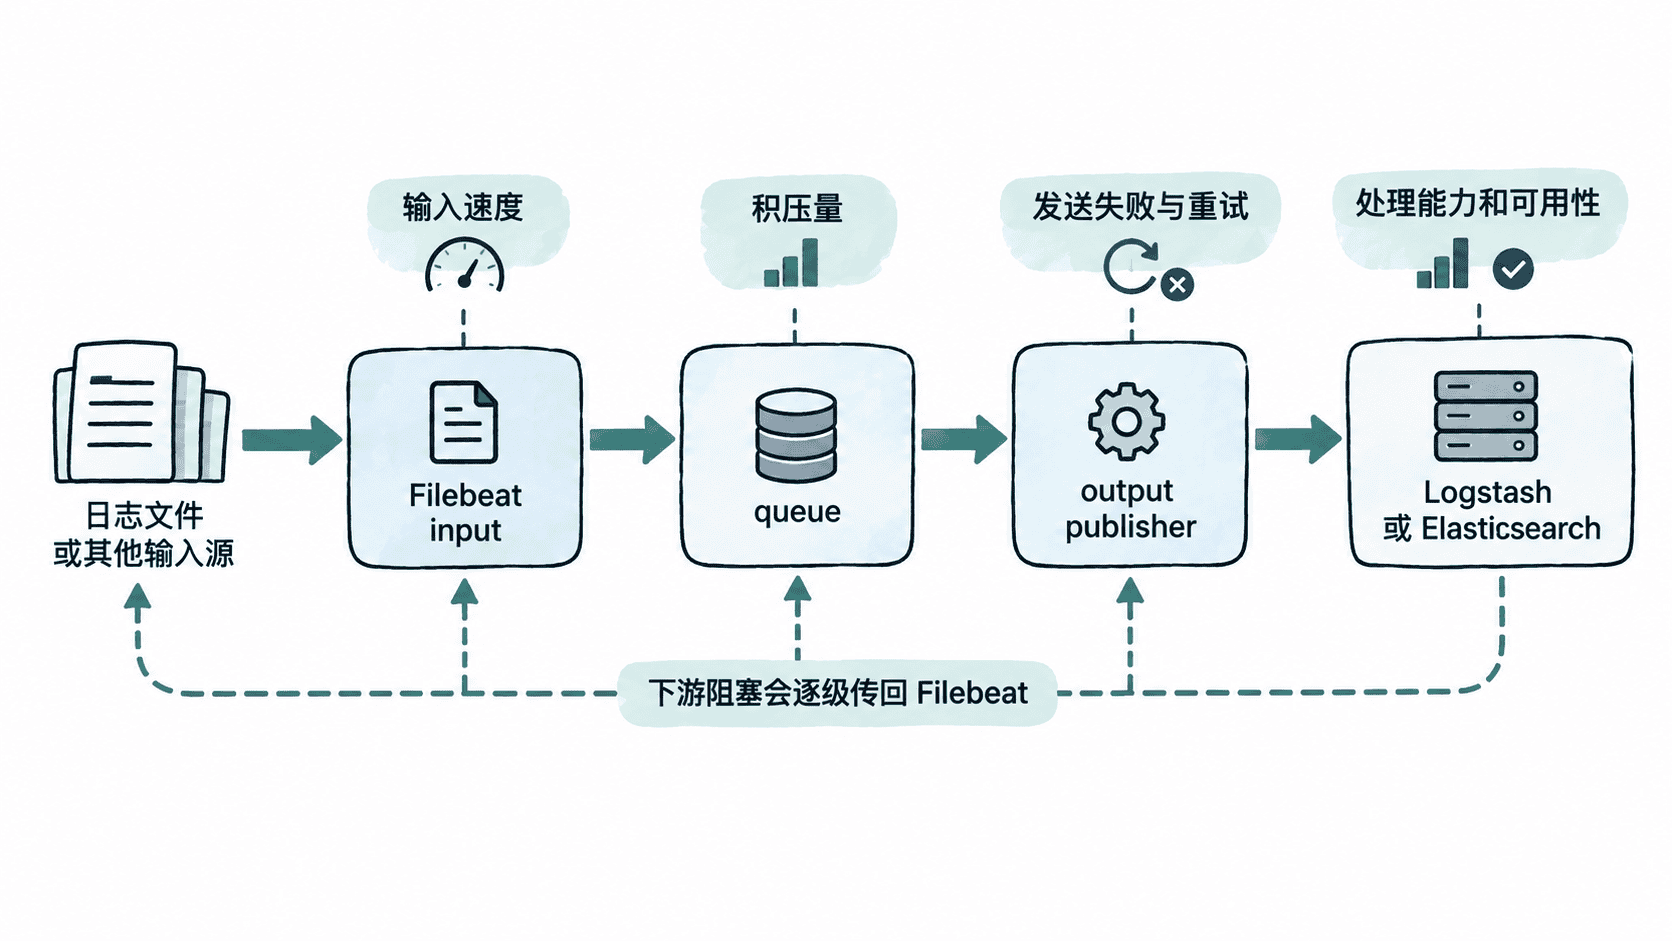
如果输入端本身没有持续产生新事件,就不是典型积压问题;如果输入持续增长而 output 大量重试,应优先检查输出和下游。如果下游健康但 Filebeat 资源长期饱和,再检查本机 CPU、内存、磁盘以及处理器开销。
检查输出链路是否可用
Filebeat 提供输出连通性测试。该命令适合先排除地址、认证和基本连接问题:
filebeat test output -e预期结果
<OUTPUT_TEST_RESULT>实际文本会随输出类型、版本和连接状态变化。成功表示基本连接测试通过,但不代表下游在高吞吐时没有性能瓶颈;失败时则应根据命令返回的 DNS、连接、TLS 或认证错误继续处理。
用现象判断积压位置
可以把排查收敛成几个判断:输入文件增长但 Filebeat 几乎没有读取进展,检查 input 配置、文件发现和本机资源;事件已经进入 Filebeat,但发送持续失败或重试,检查 output 网络、认证和下游;输出能够连接却长期处理不过来,则检查 Elasticsearch 写入压力、Logstash pipeline 或其他接收端容量。
修复后验证是否真正恢复
修复网络、认证或下游容量问题后,应同时观察 Filebeat 错误是否停止、旧日志是否继续向前消费,以及下游最新事件时间是否逐渐追上当前时间。只看到进程仍在运行并不足以证明积压已经解除。
排查积压时最有效的顺序是先确认输入是否持续产生数据,再看 Filebeat 内部是否受压,然后验证 output,最后检查下游处理能力。这样可以把“Filebeat 很慢”拆成具体链路问题,避免一开始就修改批量大小或队列容量而掩盖真正的故障。