
大模型原理与训练 / 系统课时
用因果遮罩阻止偷看未来
用因果遮罩阻止偷看未来
这一节把自注意力改造成真正的自回归注意力:每个位置只能读取自己和左侧 token。你会实现下三角遮罩,并验证即使整段序列一次并行送入模型,未来位置的注意力权重仍严格为 0。
学习目标
- 理解 Causal Mask 为什么必须阻断注意力矩阵的上三角区域
- 实现可直接用于注意力 logits 的下三角布尔遮罩
- 解释训练阶段并行计算与自回归约束为何并不冲突
遮罩应该作用在 Softmax 之前
长度为 的序列会得到一个 注意力分数矩阵。第 行表示位置 发起查询,第 列表示它准备读取位置 的信息。因果语言模型要求当前位置不能依赖尚未出现的未来 token,因此所有 的位置都必须被屏蔽。
缩放后的注意力分数通常写成:
因果遮罩 在允许访问的位置取 0,在未来位置取 ,随后计算 。由于 ,被屏蔽位置会得到严格为 0 的概率,同时每一行剩余概率仍归一化为 1。
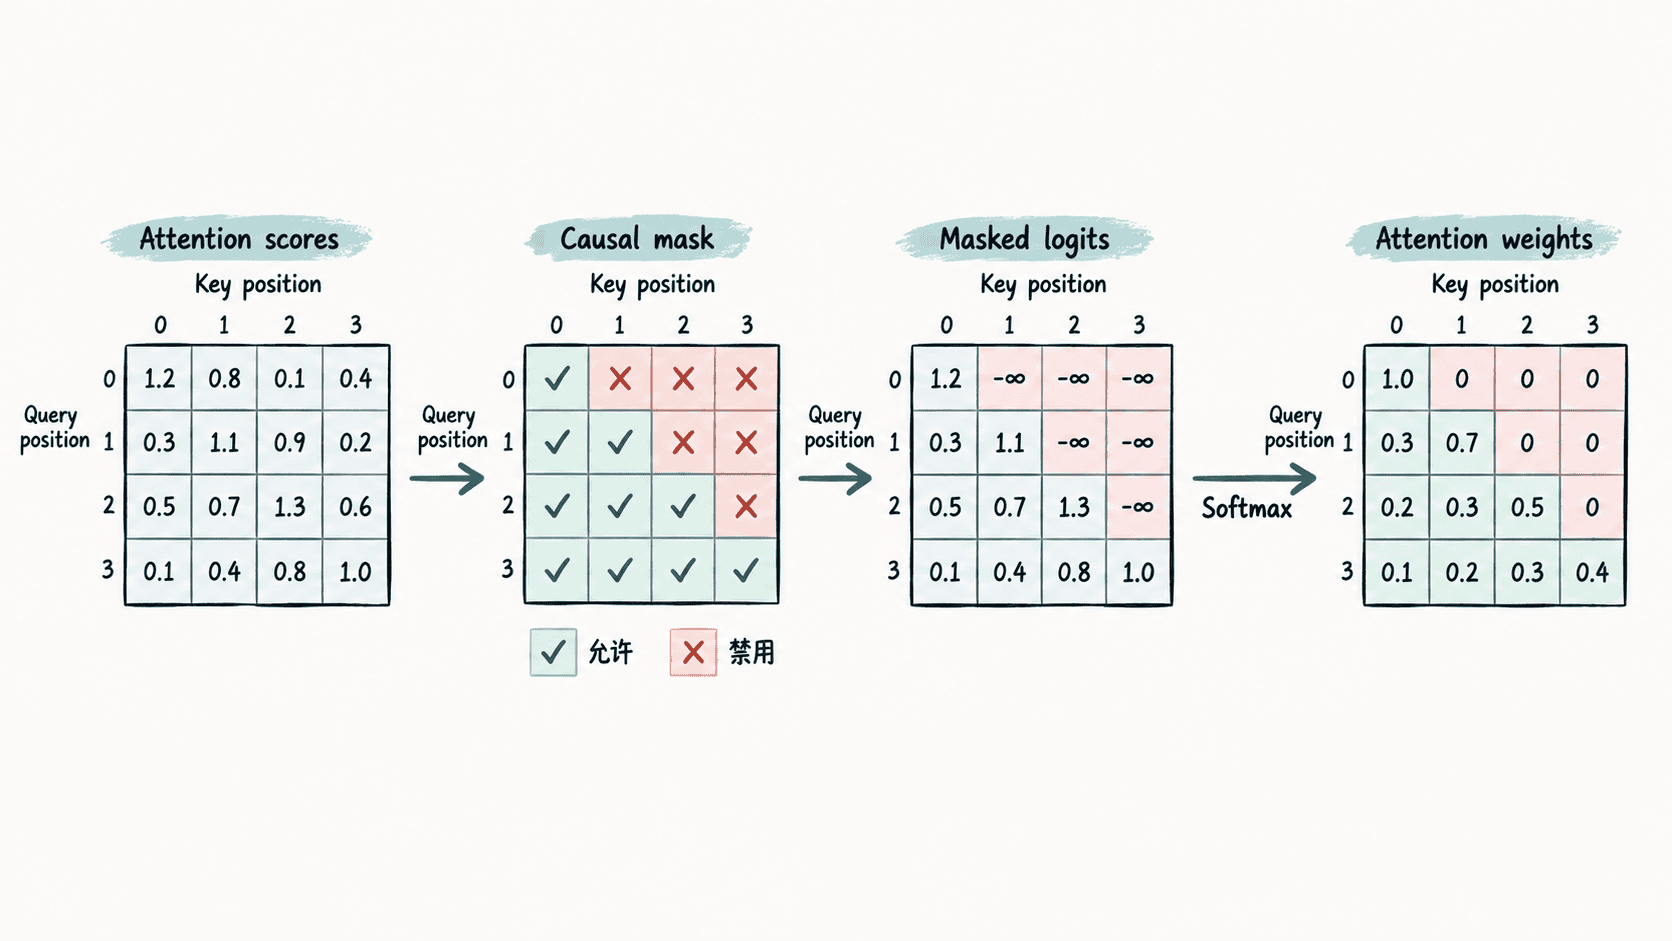
如果在 Softmax 之后才简单把未来概率乘成 0,剩余元素的和通常会小于 1,还需要再次归一化。直接在 logits 阶段屏蔽既符合数学定义,也与常见高性能注意力实现保持一致。
实现下三角 Causal Mask
下面把一个已经计算好的 分数矩阵视为缩放后的注意力 logits。torch.tril 生成包含主对角线的下三角区域,再用 masked_fill 把其余位置改成负无穷。
import torch

torch.set_printoptions(precision=4, sci_mode=False)

scores = torch.tensor([
    [1.0, 2.0, 3.0, 4.0],
    [4.0, 3.0, 2.0, 1.0],
    [1.0, 0.0, 1.0, 0.0],
    [0.0, 1.0, 0.0, 1.0],
])

T = scores.size(-1)
# True 表示当前位置允许读取对应的 key。
mask = torch.tril(torch.ones(T, T, dtype=torch.bool))
masked_scores = scores.masked_fill(~mask, float("-inf"))
weights = torch.softmax(masked_scores, dim=-1)

print(mask.int())
print(weights)
预期输出:
tensor([[1, 0, 0, 0],
        [1, 1, 0, 0],
        [1, 1, 1, 0],
        [1, 1, 1, 1]], dtype=torch.int32)
tensor([[1.0000, 0.0000, 0.0000, 0.0000],
        [0.7311, 0.2689, 0.0000, 0.0000],
        [0.4223, 0.1554, 0.4223, 0.0000],
        [0.1345, 0.3655, 0.1345, 0.3655]])
检查结果时最重要的不是具体概率,而是所有主对角线上方的权重都为 0。第一个 token 只能关注自己,第二个 token 可以关注前两个位置,以此类推。
为什么训练仍然可以并行
因果约束限制的是信息依赖关系,不是要求 GPU 按 token 顺序逐个计算。训练时整段已知序列可以同时生成全部 、、,一次矩阵乘法得到完整的 分数矩阵,再用同一个下三角遮罩同时删除所有非法连接。
因此,一个 batch 中所有训练位置都能并行计算损失,但第 个位置的输出在数学上仍只依赖位置 到 。这也是 GPT 训练吞吐量远高于逐 token 推理的关键原因之一。
生成阶段则不同:下一个 token 本身尚未知,必须先生成它,才能把它加入上下文继续预测后续 token。Causal Mask 能阻止未来信息泄漏,却不能消除生成任务本身的顺序依赖。
实现时容易错的边界
在多头注意力中,分数张量通常形如 [B, H, T, T],二维遮罩需要能够广播到 batch 和 head 维度。主对角线必须保留,否则第一个位置会没有任何可访问元素,对整行负无穷执行 Softmax 会产生无效结果。
如果以后加入 KV Cache,查询长度可能不再等于缓存中的 key 长度,此时不能机械套用一个从零开始的方形 torch.tril;遮罩必须考虑当前查询在完整序列中的位置偏移。对 nanoGPT 的完整序列训练而言,包含主对角线的标准下三角遮罩就是正确起点。