
大模型原理与训练 / 系统课时
用 Dropout 控制过拟合
用 Dropout 控制过拟合
小数据集上的 GPT 很容易把训练样本记住:训练损失继续下降,验证损失却开始回升。Dropout 的作用不是提升模型容量,而是在训练时随机屏蔽部分连接,让注意力、残差投影和前馈网络不过度依赖少数特征;推理时则自动关闭随机屏蔽,使用完整网络输出。
学习目标
- 理解 Dropout 在训练模式与推理模式下的不同行为
- 在注意力权重、残差投影和前馈路径放置 Dropout
- 根据训练集与验证集差距调整 Dropout,而不是机械增大比例
Dropout 实际改变了什么
训练时,nn.Dropout(p) 会以概率 p 将元素置零,并把保留下来的元素按 放大,因此不需要在推理阶段额外缩放。推理时调用 model.eval() 后,Dropout 直接返回输入。
下面先用最小可运行示例验证这一点。
import torch
import torch.nn as nn

torch.manual_seed(7)

dropout = nn.Dropout(p=0.5)
x = torch.ones(1000)

dropout.train()
train_out = dropout(x)
print(bool((train_out == 0).any()))
print(bool(torch.all((train_out == 0) | (train_out == 2))))

dropout.eval()
eval_out = dropout(x)
print(torch.equal(eval_out, x))
预期输出
True
True
True
前两行说明训练时确实发生随机屏蔽,而且保留值被放大为原来的 2 倍;最后一行说明推理模式不会继续丢弃激活。
在 GPT 中放置三个 Dropout
注意力模块里最关键的两个位置是 Softmax 后的注意力权重,以及多头结果完成线性投影之后;前馈网络则通常在第二个线性层之后做 Dropout。这样可以分别约束“关注哪些位置”和“把哪些特征写回残差流”。
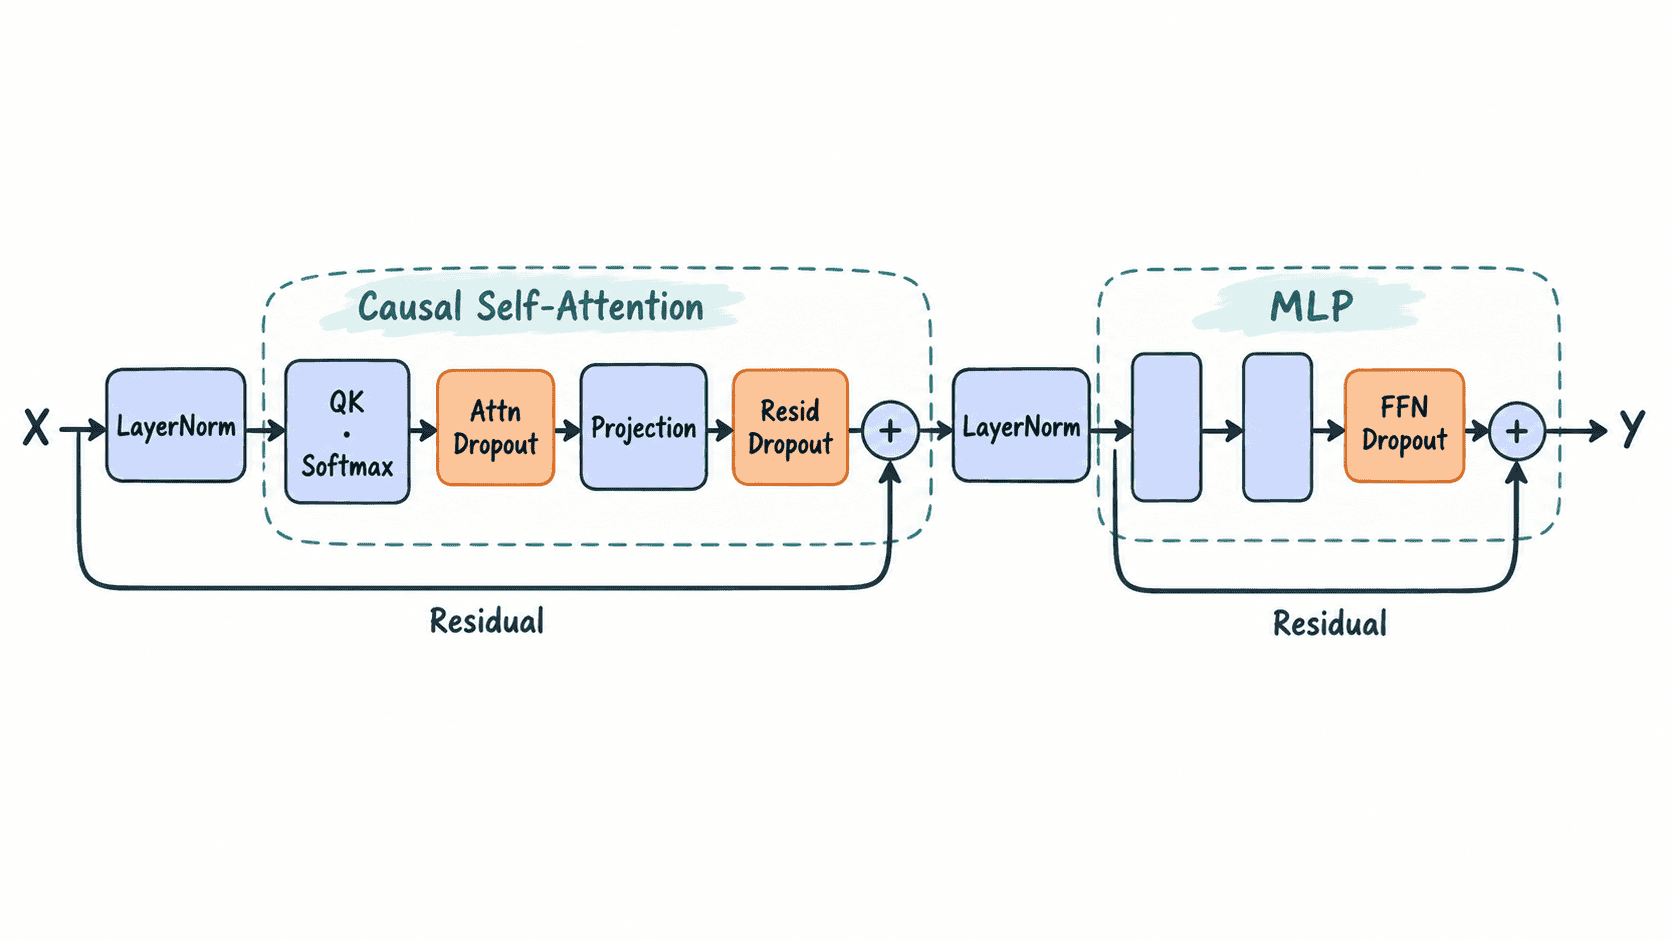
下面是放置位置的片段示例,假设 self.attn_dropout、self.resid_dropout 和 self.mlp_dropout 已在模块初始化时创建,并且 causal_mask 中的 1 表示当前位置可见。
# 片段示例:位于自注意力 forward 内
att = (q @ k.transpose(-2, -1)) * scale
att = att.masked_fill(causal_mask == 0, float("-inf"))
att = torch.softmax(att, dim=-1)
att = self.attn_dropout(att)

y = att @ v
y = self.c_proj(y)
y = self.resid_dropout(y)
该片段依赖当前注意力模块已经准备好 q、k、v、scale、causal_mask 与 self.c_proj。注意力权重 Dropout 应放在 Softmax 之后;若放到 Softmax 之前,会直接改变归一化输入,语义不同。
前馈路径可以采用同一思路:
# 片段示例:位于 MLP forward 内
x = self.c_fc(x)
x = torch.nn.functional.gelu(x)
x = self.c_proj(x)
x = self.mlp_dropout(x)
return x
这里的 Dropout 约束的是 MLP 写回残差流的特征,而不是替代激活函数。
训练与生成必须切换模式
训练循环开始前使用 model.train(),评估验证集和文本生成前使用 model.eval()。这两个调用不仅影响 Dropout,也会统一切换所有子模块的 training 状态。
如果验证损失明显高于训练损失,可以从 0.1 或 0.2 这类较小比例开始尝试;如果训练损失本身都降不下来,继续提高 Dropout 往往只会造成欠拟合。判断依据应是训练曲线与验证曲线的差距,而不是“越大越安全”。