
大模型原理与训练 / 系统课时
排查显存溢出与恢复失败
排查显存溢出与恢复失败
本节解决两类最常见的 nanoGPT 训练中断:训练阶段因显存不足出现 OOM,以及恢复检查点时因设备、配置或字段不一致而失败。完成后,你会有一套固定排查顺序,并能判断该减哪个参数、哪些配置可以改、哪些必须与检查点保持一致。
学习目标
- 根据报错发生阶段,区分显存峰值问题与检查点恢复问题
- 用
block_size、微批大小、梯度累积和模型规模控制显存占用 - 检查设备映射、结构配置和检查点字段,安全恢复训练
先判断错误发生在哪个阶段
不要一看到 CUDA out of memory 就同时修改所有参数。先确认错误发生在首次前向、反向传播,还是 torch.load、load_state_dict、优化器状态恢复阶段。不同阶段对应的根因完全不同。
训练 OOM 通常与单次微批的激活、注意力矩阵、参数和优化器状态有关;恢复失败则更常见于设备变化、模型结构参数不一致、字段缺失或旧检查点的键名不兼容。
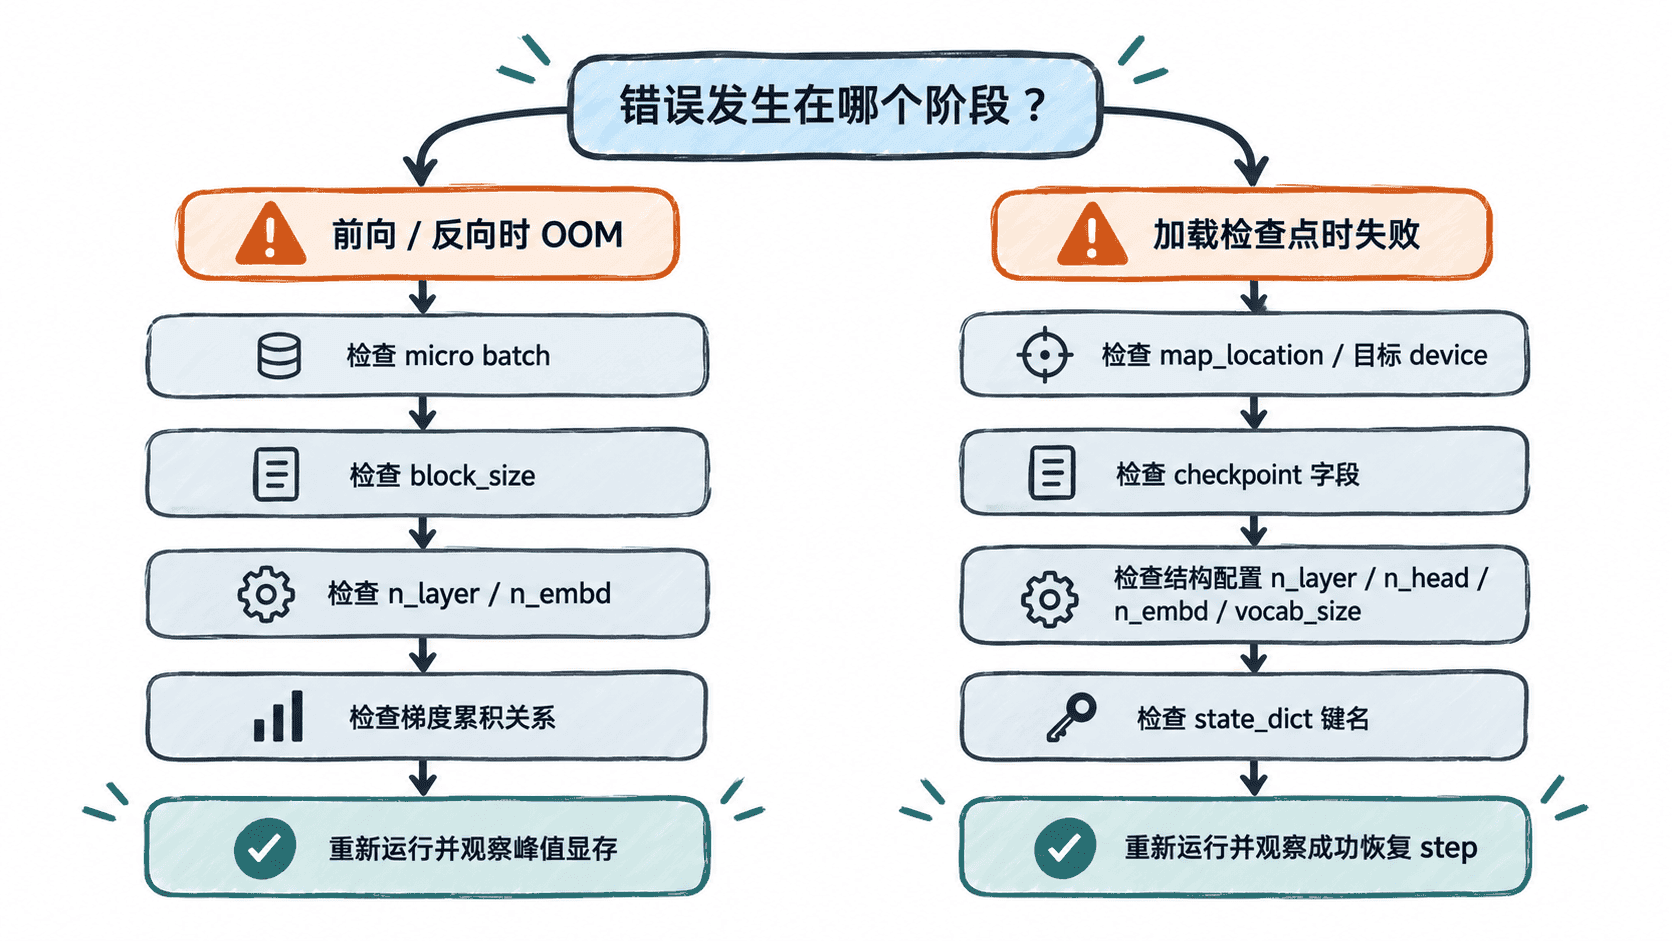
按显存峰值决定先改什么
注意力的中间张量会随序列长度快速增长,因此 block_size 增大通常比等比例增加 batch 更容易推高峰值显存。微批大小决定一次前向和反向同时驻留多少样本;n_layer、n_embd 和 n_head 则共同决定参数量与中间激活规模。
梯度累积本身不会降低一次前向的显存峰值。正确用法是先减小微批 batch_size,再提高 gradient_accumulation_steps,尽量保持有效批量不变。单卡时每次参数更新处理的 token 数可近似写成 batch_size × block_size × gradient_accumulation_steps;多卡训练还要再乘 world_size。
建议按下面顺序收缩:
- 首先减小微批
batch_size,这是对训练语义影响最小的手段。 - 若仍在注意力阶段 OOM,再减小
block_size;这会缩短上下文窗口,需要确认任务可以接受。 - 若模型本身放不下,降低
n_layer或n_embd,并保持n_embd能被n_head整除。 - 最后再调整评估批量、评估频率或启用混合精度等辅助策略,避免把次要优化当成根因修复。
用脚本检查检查点结构
不同实现可能把恢复步数写成 step 或 iter_num,把结构参数写成 model_args 或 config。下面脚本兼容这两组常见命名,并始终先映射到 CPU,因此即使检查点最初保存在另一块 GPU 上,也能先完成字段与结构检查。
import argparse
from pathlib import Path

import torch

parser = argparse.ArgumentParser()
parser.add_argument("--checkpoint", required=True)
args = parser.parse_args()

path = Path(args.checkpoint)
if not path.is_file():
    raise FileNotFoundError(f"checkpoint not found: {path}")

checkpoint = torch.load(path, map_location="cpu")

def pick(*names):
    for name in names:
        if name in checkpoint:
            return name, checkpoint[name]
    raise KeyError(f"none of these fields exist: {names}")

model_key, model_state = pick("model", "model_state_dict")
optimizer_key, _ = pick("optimizer", "optimizer_state_dict")
step_key, step = pick("step", "iter_num")
config_key, saved_config = pick("model_args", "config")

print(f"model field={model_key}")
print(f"optimizer field={optimizer_key}")
print(f"step field={step_key}, value={step}")
print(f"config field={config_key}")
for key in ("block_size", "vocab_size", "n_layer", "n_head", "n_embd"):
    print(f"{key}={saved_config.get(key, '<MISSING>')}")
print(f"model tensors={len(model_state)}")
print("checkpoint validation: OK")
预期输出(字段名和值以实际检查点为准):
model field=<MODEL_FIELD>
optimizer field=<OPTIMIZER_FIELD>
step field=<STEP_FIELD>, value=<STEP>
config field=<CONFIG_FIELD>
block_size=<BLOCK_SIZE>
vocab_size=<VOCAB_SIZE>
n_layer=<N_LAYER>
n_head=<N_HEAD>
n_embd=<N_EMBD>
model tensors=<COUNT>
checkpoint validation: OK
如果这里已经抛出字段缺失错误,不要继续猜设备问题,应先确认保存逻辑和检查点版本。
处理设备变化与配置冲突
从 CUDA 机器迁到 CPU、从 cuda:1 换到 cuda:0,加载时都应显式使用 map_location。真正恢复时,顺序应是:读取检查点结构配置、按该结构重新创建模型、加载模型权重、创建优化器并加载优化器状态,最后从保存的 step 继续。
下面是片段示例,假设当前文件已经定义 GPT,且构造函数接受保存下来的结构配置:
device = "cuda" if torch.cuda.is_available() else "cpu"
checkpoint = torch.load("out/ckpt.pt", map_location=device)

saved_config = (
    checkpoint["model_args"] if "model_args" in checkpoint else checkpoint["config"]
)
state_dict = (
    checkpoint["model"] if "model" in checkpoint else checkpoint["model_state_dict"]
)

prefix = "_orig_mod."
if state_dict and all(key.startswith(prefix) for key in state_dict):
    state_dict = {key[len(prefix):]: value for key, value in state_dict.items()}

model = GPT(saved_config).to(device)
model.load_state_dict(state_dict)

optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)
optimizer_state = (
    checkpoint["optimizer"]
    if "optimizer" in checkpoint
    else checkpoint["optimizer_state_dict"]
)
optimizer.load_state_dict(optimizer_state)

start_step = checkpoint.get("step", checkpoint.get("iter_num"))
print(f"resume step={start_step}, device={device}")
预期输出:
resume step=<STEP>, device=<DEVICE>运行时参数与结构参数要分开看。batch_size、梯度累积次数、日志频率通常可以调整;n_layer、n_head、n_embd、vocab_size 必须与权重形状兼容。block_size 若缩短,可以在明确实现了位置嵌入裁剪时处理;若直接把它增大到检查点未训练过的长度,位置嵌入通常会出现尺寸不匹配。
旧检查点还可能带有编译前缀,例如某些权重键以 _orig_mod. 开头。确认它只是统一前缀后再定向移除;不要用 strict=False 静默吞掉大量不匹配,因为那可能让关键层以随机参数继续训练。
修复后如何验证
修复 OOM 后,先用较短训练跑数十个迭代,确认显存峰值稳定且 loss 可以正常反向更新;若只是把梯度累积调高,还要核对一次参数更新对应的有效 token 数是否符合预期。
修复恢复问题后,至少核对三件事:日志中的起始 step 等于检查点保存值,第一轮评估 loss 与中断前同量级,继续训练后 step 单调递增。能同时满足这三点,才说明恢复的是原训练状态,而不是仅仅“把模型权重加载进来了”。