
大模型原理与训练 / 系统课时
让自研模型对齐 GPT-2 结构
让自研模型对齐 GPT-2 结构
要把 GPT-2 权重装进自研模型,难点不在“参数数量差不多”,而在每个可学习张量的形状、层次位置和权重布局都要对应。本文以 GPT-2 124M 为目标,先检查结构尺寸,再说明哪些权重可直接复制、哪些必须转置。
学习目标
- 核对 GPT-2 124M 的层数、隐藏维度、注意力头、词表和上下文长度
- 判断自研模块的参数形状是否具备加载 GPT-2 权重的条件
- 识别
Conv1D与nn.Linear的权重布局差异以及词嵌入权重共享
先对齐五个决定性尺寸
这里的目标是基础版 GPT-2,也就是常说的 124M 配置:n_layer=12、n_head=12、n_embd=768、vocab_size=50257、block_size=1024。注意力单头维度因此为 ,前馈网络中间维度为 。
这五个值有任意一个不同,都不能把整套权重无条件装入。比如把上下文长度改成 2048,会导致位置嵌入 wpe.weight 的第一维不匹配;把词表扩成 50304,则 token embedding 和输出头都会多出行,需要单独初始化新增部分,而不是直接严格加载。
用脚本先做配置体检
在碰真实权重前,先让配置检查失败得足够早。下面脚本把你的结构参数与 GPT-2 124M 基准逐项比较,并同时打印几个最关键的目标张量形状。将 mine 改成你的实际配置后直接运行即可。
from dataclasses import dataclass, asdict

@dataclass(frozen=True)
class GPTConfig:
    n_layer: int
    n_head: int
    n_embd: int
    vocab_size: int
    block_size: int

target = GPTConfig(
    n_layer=12,
    n_head=12,
    n_embd=768,
    vocab_size=50257,
    block_size=1024,
)

mine = GPTConfig(
    n_layer=12,
    n_head=12,
    n_embd=768,
    vocab_size=50257,
    block_size=1024,
)

mismatches = []
for name, expected in asdict(target).items():
    actual = getattr(mine, name)
    if actual != expected:
        mismatches.append(f"{name}: mine={actual}, gpt2={expected}")

if mine.n_embd % mine.n_head != 0:
    mismatches.append("n_embd must be divisible by n_head")

if mismatches:
    print("incompatible")
    for item in mismatches:
        print("-", item)
else:
    head_dim = mine.n_embd // mine.n_head
    print("config: compatible with GPT-2 124M")
    print(f"head_dim={head_dim}")
    print(f"wte.weight=({mine.vocab_size}, {mine.n_embd})")
    print(f"wpe.weight=({mine.block_size}, {mine.n_embd})")
    print(f"c_attn Linear.weight=({3 * mine.n_embd}, {mine.n_embd})")
    print(f"mlp.c_fc Linear.weight=({4 * mine.n_embd}, {mine.n_embd})")
    print(f"mlp.c_proj Linear.weight=({mine.n_embd}, {4 * mine.n_embd})")
预期输出
config: compatible with GPT-2 124M
head_dim=64
wte.weight=(50257, 768)
wpe.weight=(1024, 768)
c_attn Linear.weight=(2304, 768)
mlp.c_fc Linear.weight=(3072, 768)
mlp.c_proj Linear.weight=(768, 3072)
如果脚本先报 incompatible,不要急着写权重复制代码。先让配置层完全一致,否则后面遇到的 shape mismatch 只是更晚、更难定位的同一个问题。
再对齐模块与参数布局
尺寸一致还不够。GPT-2 每个 Block 都是预归一化结构:先 ln_1 再因果自注意力,残差相加后再 ln_2 与 MLP。MLP 的扩张比例是 4 倍,注意力一次生成 Q、K、V,因此组合投影输出宽度是 3 * n_embd = 2304。
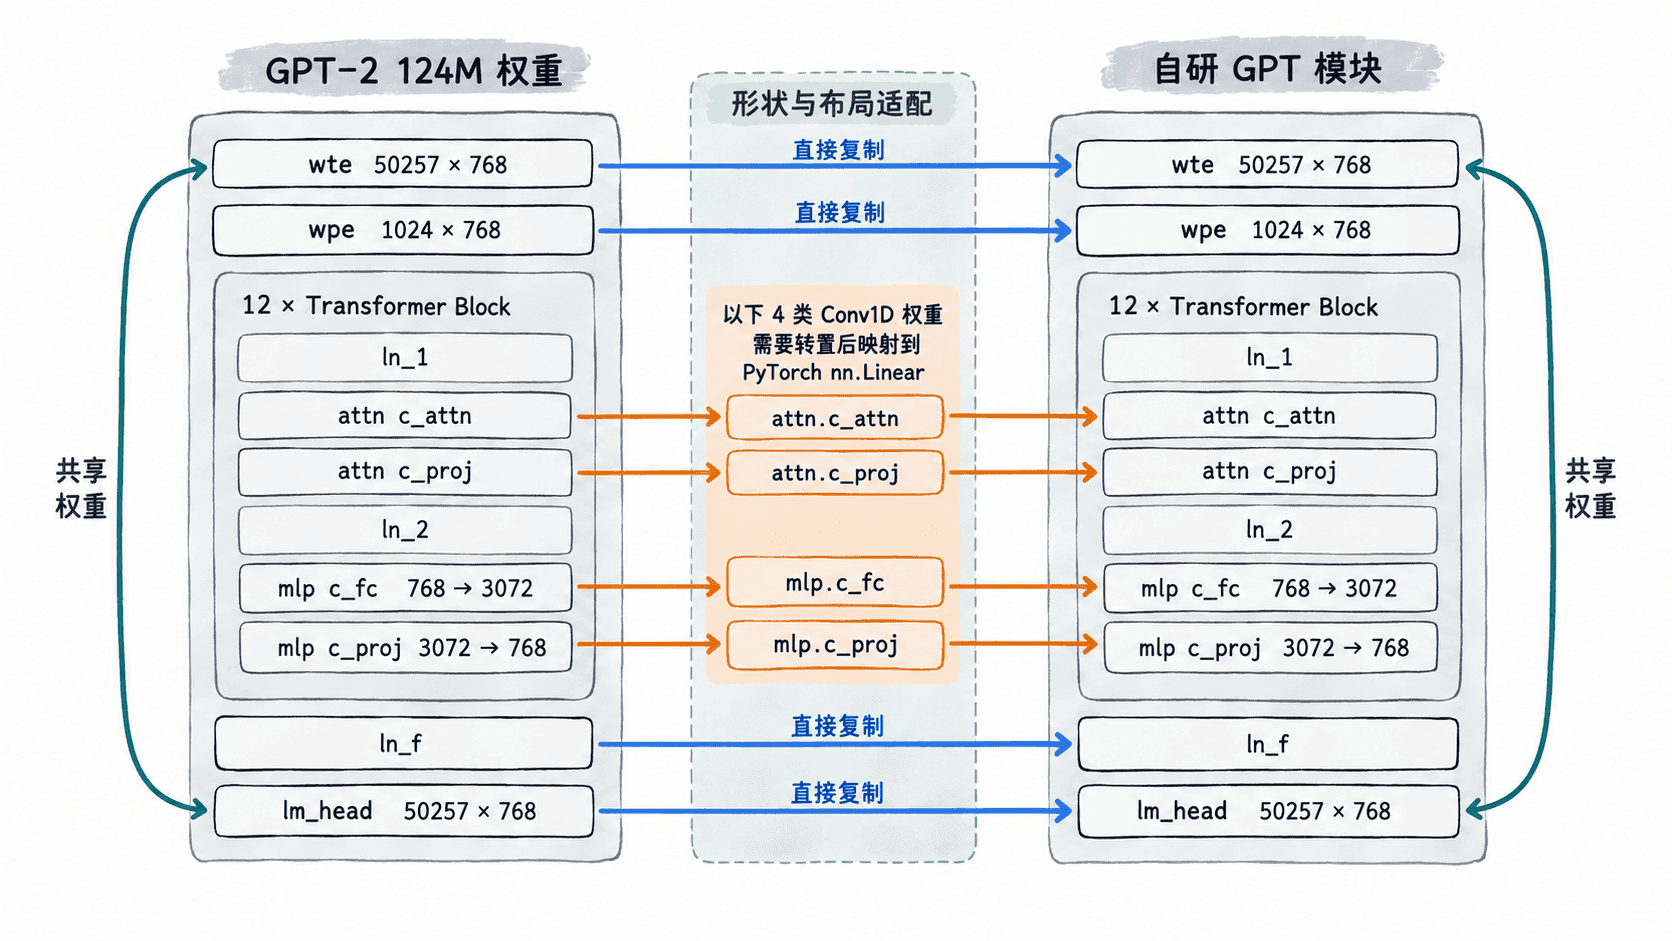
如果你的实现使用 PyTorch nn.Linear,加载常见 GPT-2 checkpoint 时要特别检查线性层布局。GPT-2 实现中常见的 Conv1D 权重布局与 nn.Linear.weight 相反,因此 attn.c_attn.weight、attn.c_proj.weight、mlp.c_fc.weight、mlp.c_proj.weight 通常需要转置后再复制。LayerNorm、token embedding、position embedding 和各层 bias 的形状一致时可直接复制。
| 参数组 | 自研 nn.Linear 目标形状 |
加载动作 |
|---|---|---|
attn.c_attn.weight |
(2304, 768) |
从 GPT-2 Conv1D 权重转置 |
attn.c_proj.weight |
(768, 768) |
转置 |
mlp.c_fc.weight |
(3072, 768) |
转置 |
mlp.c_proj.weight |
(768, 3072) |
转置 |
wte.weight、wpe.weight、LayerNorm |
与目标张量完全相同 | 直接复制 |
还要保持 lm_head.weight 与 wte.weight 共享参数,而不是训练两份独立矩阵。即便两者初始化数值相同,只要不是同一个参数对象,后续训练就会逐渐分叉,这与 GPT-2 的权重绑定行为不同。
区分“能加载”与“行为完全一致”
结构与形状通过只能证明“权重有地方放”,还不能保证同一输入得到完全一致的 logits。若你要做数值级对齐,还要继续核对 LayerNorm 的 epsilon、GELU 形式、注意力缩放、dropout、因果 mask、bias 是否存在,以及位置编号是否从 0 开始。
最稳妥的验收顺序是:先让配置字段完全一致,再让每个 state_dict 张量形状一致,再处理需要转置的四类权重,最后用同一串 token 分别跑参考 GPT-2 与自研模型,对比 logits 的最大绝对误差。只有这四层检查都通过,后续生成结果的差异才值得继续追查采样参数,而不是继续怀疑权重装载。