
大模型原理与训练 / 系统课时
把大语料预处理成二进制数据
把大语料预处理成二进制数据
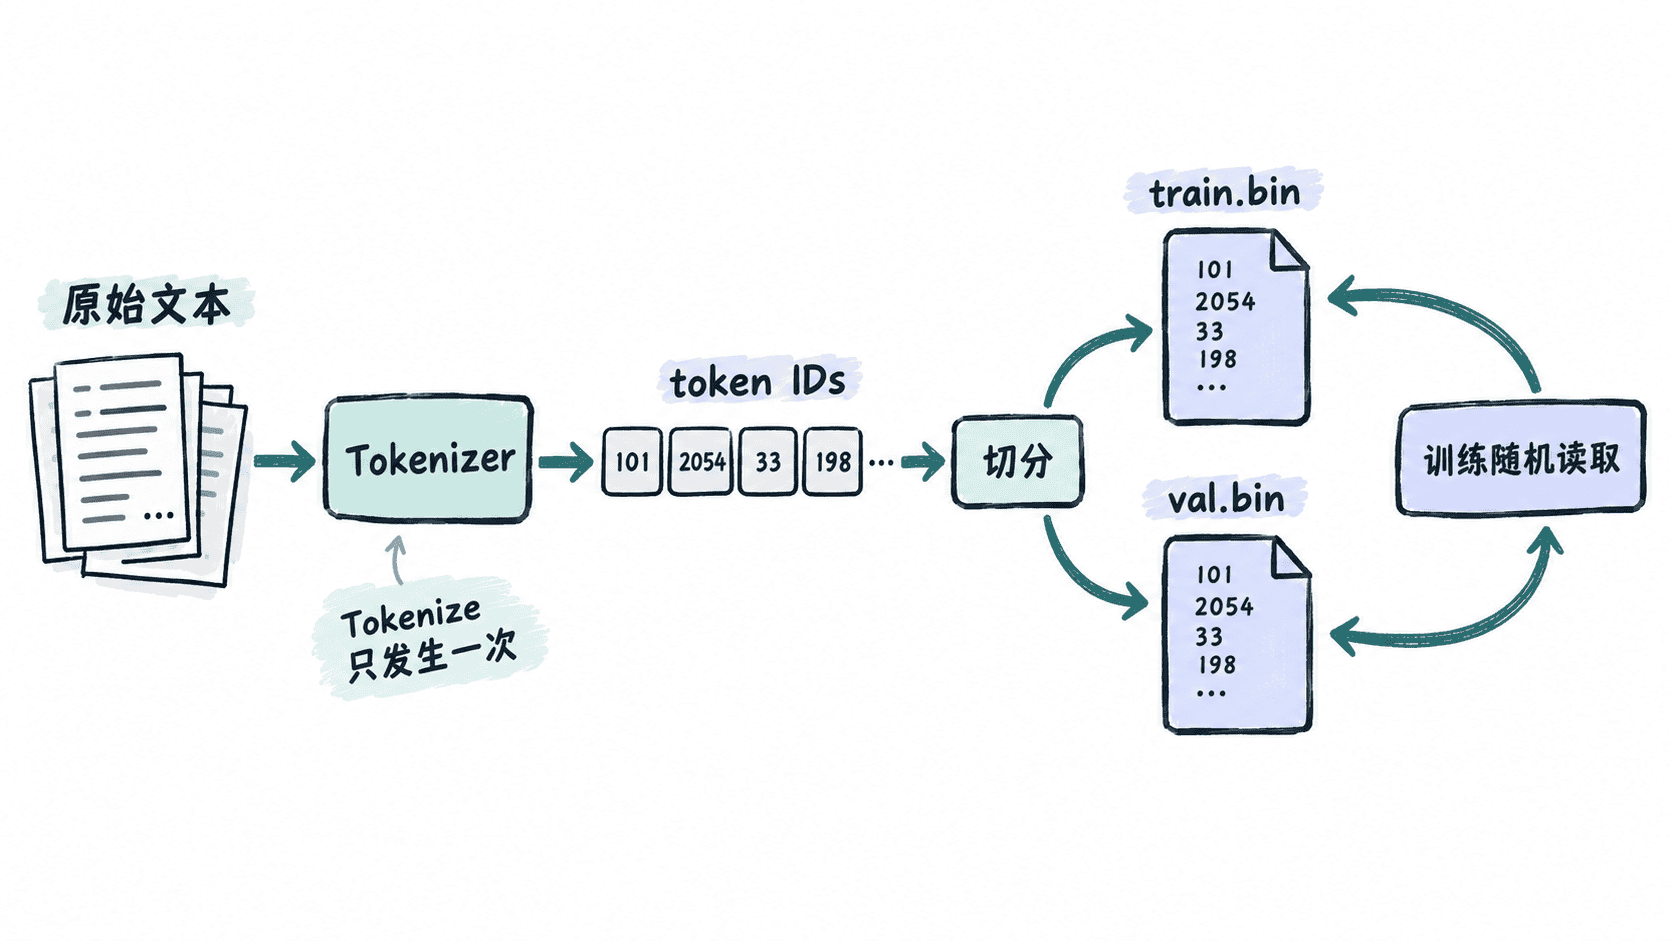
训练循环不应该反复读取原始文本并重新分词。本节把文本一次性转换成连续 token ID,再按训练集和验证集写入紧凑二进制文件,使后续训练只处理整数序列,并明确 tokenizer、整数类型和数据切分必须保持一致的原因。
学习目标
- 把原始文本一次性 Tokenize,并写成连续整数二进制文件
- 根据词表范围选择合适的整数类型,正确切分训练集与验证集
- 解释预处理为何能减少正式训练阶段的重复 CPU 与解析开销
二进制文件真正保存什么
语言模型看到的不是字符串,而是 token ID 序列。假设 tokenizer 把文本转换为 [110, 97, 110, 111, ...],预处理阶段只需按固定整数类型把这些 ID 连续写入文件,不必保存 JSON 数组、换行记录或每条文本的边界。
这种布局很适合自回归训练:训练时只需要从任意位置取连续的 block_size + 1 个 token,前 block_size 个作为输入,后移一个位置作为目标。
写出一个可直接读取的 token 流
下面用 UTF-8 字节作为最小 tokenizer,使示例不依赖外部分词库。每个字节就是一个 0~255 的 token ID,并以小端 uint16 保存。正式项目应把 encode 替换为模型实际使用的固定 tokenizer,但文件写入方式相同。示例需要 Python 3 和 NumPy,保存为 preprocess.py 后执行 python preprocess.py。
from pathlib import Path
import numpy as np

TEXT = 'nanoGPT trains on token streams.\n' * 100
TRAIN_RATIO = 0.9


def encode(text: str) -> np.ndarray:
    # 独立示例使用字节 tokenizer;正式训练必须换成模型对应 tokenizer。
    byte_ids = np.frombuffer(text.encode('utf-8'), dtype=np.uint8)
    return byte_ids.astype('<u2')


def main() -> None:
    ids = encode(TEXT)
    split = int(len(ids) * TRAIN_RATIO)
    train_ids = ids[:split]
    val_ids = ids[split:]

    train_path = Path('train.bin')
    val_path = Path('val.bin')
    train_ids.tofile(train_path)
    val_ids.tofile(val_path)

    print('total tokens=', len(ids), sep='')
    print('train tokens=', len(train_ids), ', bytes=', train_path.stat().st_size, sep='')
    print('val tokens=', len(val_ids), ', bytes=', val_path.stat().st_size, sep='')


if __name__ == '__main__':
    main()
预期输出
total tokens=3300
train tokens=2970, bytes=5940
val tokens=330, bytes=660
每个 token 占 2 字节,因此文件大小应分别等于 token 数乘以 2。这个检查很简单,却能快速发现写入类型或数据长度与预期不一致的问题。
固定 tokenizer 与整数类型
真正的数据集可能包含数十亿 token,预处理前应先确定两件事。第一,训练和生成必须使用同一个 tokenizer;如果预训练完成后更换 token 到 ID 的映射,即使词表大小没变,已有权重也失去原来的语义对应关系。第二,文件的整数类型必须容纳词表中的最大 token ID。
当所有 ID 都小于 65536 时,uint16 每个 token 只占 2 字节;如果词表或特殊 token 的 ID 超出该范围,就应改用 uint32,同时让后续读取代码使用完全相同的 dtype 和字节序。
为什么只做一次分词
若训练循环每取一个 batch 都重新打开文本、解析字符并执行 tokenizer,同一段语料会随着 epoch 和随机采样被重复处理,CPU 分词和对象创建还可能让 GPU 等待数据。预处理把这部分工作提前为一次性的顺序任务,之后训练只需计算随机偏移并读取定长整数片段。
二进制格式也避免了文本解析与 JSON 等结构化格式的额外开销。它的代价是可读性低,因此应把 tokenizer 版本、dtype、训练验证切分规则等元数据单独记录下来。只要这些约定稳定,train.bin 和 val.bin 就可以被后续训练反复复用,而不必再次 Tokenize 原始语料。