
大模型原理与训练 / 系统课时
用 Bigram 跑通训练与生成
用 Bigram 跑通训练与生成
这一课只做一件事:用最小的 Bigram Language Model 把训练到生成的完整链路跑通。你会看到输入 Token 如何得到下一 Token 的 logits,损失如何反向传播并更新参数,以及模型如何把预测结果再次送回自己完成自回归生成。
学习目标
- 实现一个可训练的 Bigram Language Model,并理解它的参数含义。
- 跑通前向计算、交叉熵损失、反向传播与参数更新。
- 用自回归循环从起始 Token 连续生成新 Token。
Bigram 模型到底学什么
Bigram 的假设非常简单:下一个 Token 只由当前 Token 决定。因此不需要注意力,也不需要隐藏状态;只要为每个 Token 保存一行“下一 Token 的打分”即可。
最直接的实现就是一个 nn.Embedding(vocab_size, vocab_size)。输入 Token ID 用来查表,查到的向量长度等于词表大小,向量中的每个元素都是某个候选下一 Token 的 logit。参数矩阵因此是 V × V:行表示当前 Token,列表示下一个 Token。
训练时,输入张量形状为 B × T,查表后得到 B × T × V。交叉熵需要把前两个维度展平为 B*T × V,目标则展平为 B*T,这样每个位置都会独立承担一次“预测下一个 Token”的监督信号。
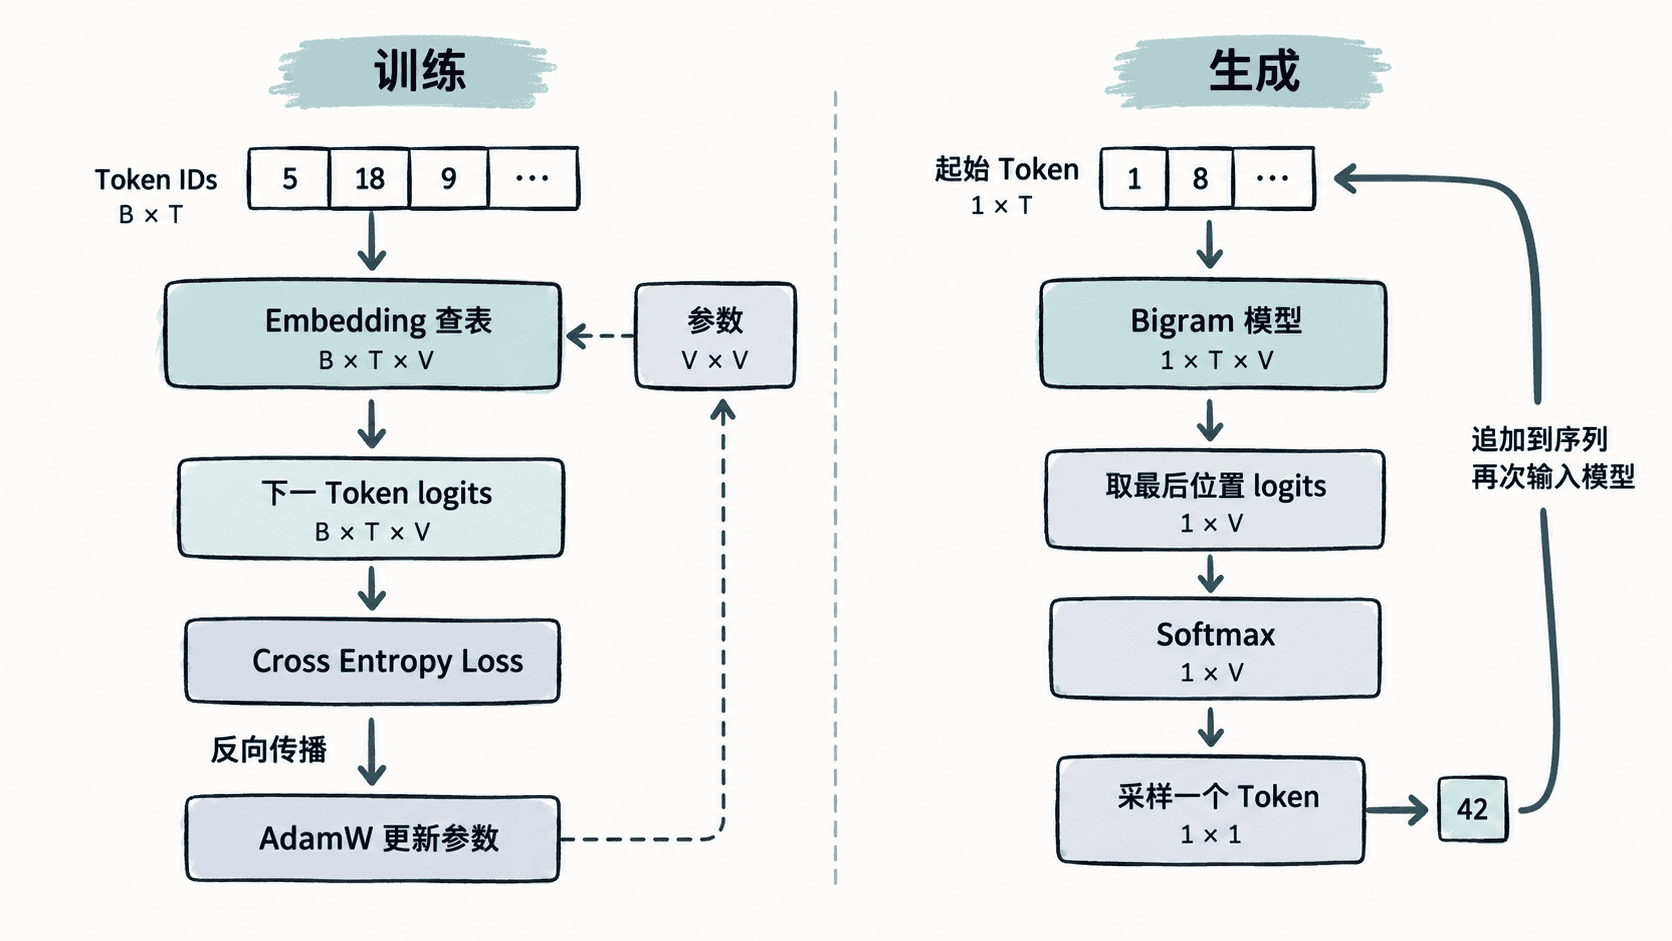
跑通训练闭环
下面的程序使用一个很小的整数序列作为训练数据。它固定取四个长度为 4 的窗口,训练 200 步,并检查三件事:参数确实发生变化、前向输出形状正确、生成序列长度正确。
import torch
import torch.nn as nn
from torch.nn import functional as F

torch.manual_seed(42)

vocab_size = 8
block_size = 4
data = torch.tensor(
    [0, 1, 2, 3, 4, 5, 6, 7, 0, 1, 2, 3],
    dtype=torch.long,
)

def get_batch():
    starts = torch.tensor([0, 2, 4, 6])
    x = torch.stack([data[i:i + block_size] for i in starts])
    y = torch.stack([data[i + 1:i + block_size + 1] for i in starts])
    return x, y

class BigramLanguageModel(nn.Module):
    def __init__(self, vocab_size):
        super().__init__()
        # 每一行对应“当前 Token”,每一列对应“下一个 Token”的 logit。
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets=None):
        logits = self.token_embedding_table(idx)
        loss = None

        if targets is not None:
            batch, time, channels = logits.shape
            logits_for_loss = logits.view(batch * time, channels)
            targets_for_loss = targets.view(batch * time)
            loss = F.cross_entropy(logits_for_loss, targets_for_loss)

        return logits, loss

    @torch.no_grad()
    def generate(self, idx, max_new_tokens):
        for _ in range(max_new_tokens):
            logits, _ = self(idx)
            # 生成时只使用当前序列最后一个位置对下一 Token 的预测。
            next_logits = logits[:, -1, :]
            probs = F.softmax(next_logits, dim=-1)
            next_idx = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, next_idx), dim=1)
        return idx

model = BigramLanguageModel(vocab_size)
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-2)
before = model.token_embedding_table.weight.detach().clone()

for _ in range(200):
    xb, yb = get_batch()
    _, loss = model(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()

xb, yb = get_batch()
logits, loss = model(xb, yb)
generated = model.generate(
    torch.zeros((1, 1), dtype=torch.long),
    max_new_tokens=8,
)

print('parameters changed:', not torch.equal(before, model.token_embedding_table.weight))
print('logits shape:', tuple(logits.shape))
print('loss finite:', bool(torch.isfinite(loss)))
print('generated shape:', tuple(generated.shape))
预期输出
parameters changed: True
logits shape: (4, 4, 8)
loss finite: True
generated shape: (1, 9)
这里没有打印具体损失值,因为不同 PyTorch 版本与底层实现可能产生细微浮点差异;loss finite: True 足以验证损失计算没有出现 NaN 或无穷大。生成内容本身带随机采样,但输出长度固定为“1 个起始 Token + 8 个新 Token”。
训练与生成为什么能接起来
训练阶段的目标是让正确下一 Token 在 logits 中获得更高分数。cross_entropy 同时完成 softmax 归一化和负对数似然计算,backward() 把误差梯度传回 token_embedding_table.weight,优化器再修改这张 V × V 的表。
生成阶段不再提供目标,因此只取最后一个位置的 logits,经 softmax 转为概率后采样一个 Token,并把它拼回输入。下一轮模型看到的是“旧序列 + 新 Token”,于是可以继续预测。这个“预测、追加、再预测”的循环就是后面 GPT 生成逻辑的最小原型。
理解这条基线的边界
Bigram 能证明训练链路是通的,却几乎没有上下文建模能力。两个完全相同的当前 Token,无论前面出现过什么历史,都会得到同一组下一 Token 分布。因此它适合作为基线:如果这一步都无法降低损失或完成生成,问题通常在数据切片、目标对齐、损失形状、梯度或优化器,而不是注意力机制。
真正的 GPT 会在这条链路上逐步替换“只看当前 Token 的查表预测”:先加入 Token 与位置表示,再引入因果自注意力和前馈网络。训练闭环仍然是同一套前向、损失、反向传播、参数更新;生成闭环也仍然是取最后位置 logits、采样并追加。