
大模型原理与训练 / 系统课时
迁移并校验 GPT-2 预训练权重
迁移并校验 GPT-2 预训练权重
把公开 GPT-2 权重装进自研模型,真正难点不是下载,而是确认“同名参数是否同义、张量布局是否一致”。本节完成结构对齐、权重复制、必要转置与输出校验,最终得到可直接用于生成的 GPT-2 模型。
学习目标
- 识别 Hugging Face GPT-2 与自研
nn.Linear模型之间的参数布局差异。 - 正确迁移全部预训练权重,并避开注意力掩码缓冲区。
- 用同一输入比较下一 token logits,定位“权重已加载但结果不一致”的问题。
先把结构对齐
以 gpt2 为例,目标模型至少要与公开 GPT-2 small 保持这些关键配置一致:词表大小 50257、上下文长度 1024、层数 12、注意力头数 12、隐藏维度 768,并启用线性层 bias。推理校验时应调用 eval(),避免 dropout 让两次前向结果随机变化。
GPT-2 的 token embedding 与输出头通常共享权重;如果自研模型没有权重绑定,即使复制值成功,也会留下结构语义差异。参数名不同并不可怕,但必须建立一一映射,不能靠“形状一样”猜对应关系。
真正需要特别处理的是四类矩阵:attn.c_attn.weight、attn.c_proj.weight、mlp.c_fc.weight、mlp.c_proj.weight。Hugging Face GPT-2 使用 Conv1D 风格存储,而常见自研实现使用 nn.Linear,两者权重维度方向相反,因此复制前要转置。
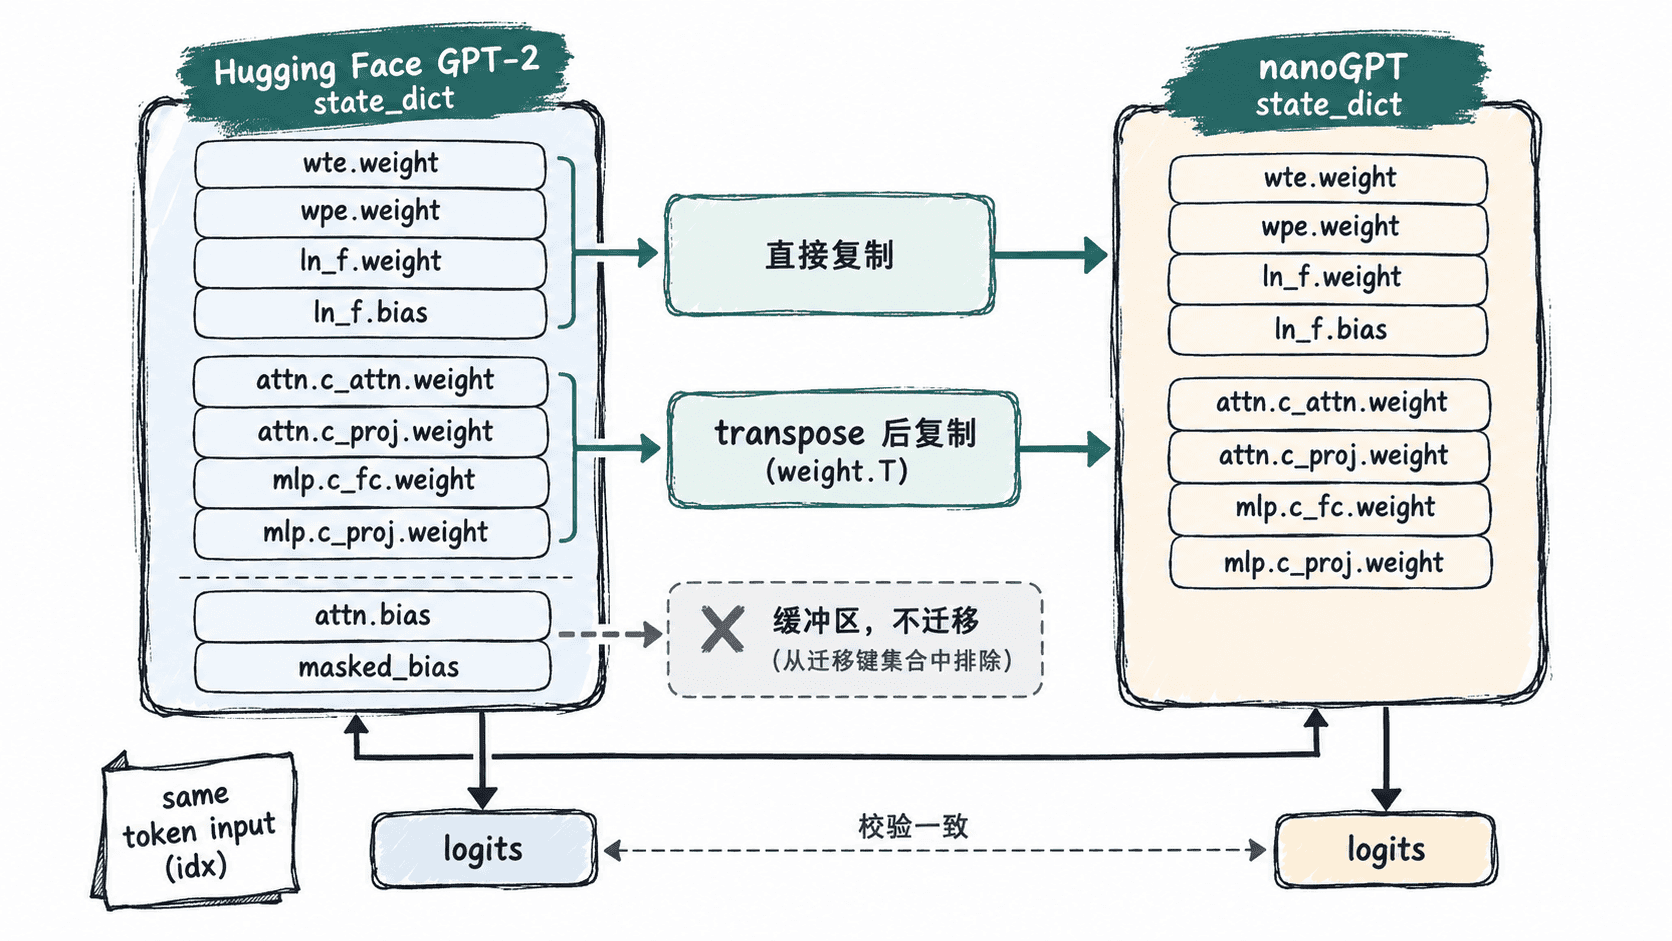
复制权重并处理转置
下面代码是可直接放进项目脚本的主迁移逻辑。它依赖本项目已有 model.py,其中 GPT 与 GPTConfig 的参数命名需要与 nanoGPT 风格一致;如果你改过命名,应先建立显式映射再复制。
from __future__ import annotations

import torch
from transformers import GPT2LMHeadModel

from model import GPT, GPTConfig

TRANSPOSED_SUFFIXES = (
    "attn.c_attn.weight",
    "attn.c_proj.weight",
    "mlp.c_fc.weight",
    "mlp.c_proj.weight",
)


@torch.no_grad()
def load_gpt2_weights(model: GPT, model_type: str = "gpt2") -> GPT2LMHeadModel:
    reference = GPT2LMHeadModel.from_pretrained(model_type).eval()
    src = reference.state_dict()
    dst = model.state_dict()

    # Hugging Face 多一个 masked_bias;两边的因果 mask buffer 都不属于预训练参数。
    src_keys = [
        k for k in src
        if not k.endswith(".attn.masked_bias") and not k.endswith(".attn.bias")
    ]
    dst_keys = [k for k in dst if not k.endswith(".attn.bias")]

    if set(src_keys) != set(dst_keys):
        missing = sorted(set(src_keys) - set(dst_keys))
        extra = sorted(set(dst_keys) - set(src_keys))
        raise KeyError(f"parameter names mismatch, missing={missing}, extra={extra}")

    for key in src_keys:
        if key.endswith(TRANSPOSED_SUFFIXES):
            if src[key].shape[::-1] != dst[key].shape:
                raise ValueError(f"shape mismatch after transpose: {key}")
            dst[key].copy_(src[key].t())
        else:
            if src[key].shape != dst[key].shape:
                raise ValueError(f"shape mismatch: {key}")
            dst[key].copy_(src[key])

    model.load_state_dict(dst, strict=True)
    return reference


config = GPTConfig(
    block_size=1024,
    vocab_size=50257,
    n_layer=12,
    n_head=12,
    n_embd=768,
    dropout=0.0,
    bias=True,
)
model = GPT(config).eval()
reference = load_gpt2_weights(model)
print("migration ok")
预期输出
migration ok这一步如果在 set(src_keys) != set(dst_keys) 处失败,先处理参数命名,而不是删除断言。断言的价值正是阻止某一层漏载后仍继续生成。
用同一输入检查模型输出
权重形状正确只能证明“装得进去”,不能证明前向实现等价。还要用同一批 token 同时喂给参考模型和自研模型,比较最后一个位置的 logits。下面是接在上一段脚本后的片段示例,依赖已经创建好的 model 与 reference。
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("gpt2")
input_ids = tokenizer("Hello, my name is", return_tensors="pt").input_ids

with torch.no_grad():
    ref_logits = reference(input_ids).logits[:, -1:, :]
    our_logits, _ = model(input_ids)

max_abs_diff = (ref_logits - our_logits).abs().max().item()
same_next_token = torch.equal(
    ref_logits.argmax(dim=-1),
    our_logits.argmax(dim=-1),
)

print(f"max_abs_diff={max_abs_diff:.6g}")
print(f"same_next_token={same_next_token}")
预期输出
max_abs_diff=<SMALL_FLOAT>
same_next_token=True
<SMALL_FLOAT> 会随 PyTorch、Transformers 版本、dtype 与具体实现略有变化。若权重逐项已正确复制,但差异仍明显,优先检查 GELU 公式、LayerNorm epsilon、残差顺序、位置 embedding、因果 mask,以及推理时是否仍处于训练模式。
排查迁移后的常见异常
如果出现 shape mismatch,通常不是“权重坏了”,而是目标配置与 GPT-2 型号不匹配,或漏掉了四类需要转置的矩阵。若参数名集合不一致,应该明确写映射表,不要按 state_dict 顺序 zip 复制,因为不同实现的注册顺序并不是可靠协议。
若 logits 差异很小但生成文本逐步分叉,也不一定说明迁移失败。自回归采样会把微小概率差异放大;迁移验收应先看单步 logits、argmax 与固定输入,再进入随机采样验证。只有这条链路通过后,后续 temperature、top-k 等采样参数才有可解释性。