
大模型原理与训练 / 系统课时
排查 Loss 不降与生成乱码
排查 Loss 不降与生成乱码
训练不收敛和生成乱码通常不是同一个问题的两个表象,而是数据、标签、遮罩、优化器、数值稳定性或采样链路中任一环节失配。本节给出从最便宜检查到最昂贵检查的顺序,并用单批次过拟合测试快速判断模型是否具备最基本的学习能力。
学习目标
- 按数据、标签、遮罩、优化和采样链路逐层定位异常
- 用单批次过拟合测试区分实现错误和训练配置问题
- 根据 Loss 形态判断学习率、数值稳定性和模型容量问题
先把症状拆成可验证信号
先区分三类现象:Loss 几乎不动、Loss 剧烈震荡或变成 NaN、Loss 能下降但生成仍然乱码。第一类优先怀疑标签错位、梯度没有更新或学习率过低;第二类优先检查学习率和数值稳定性;第三类则更可能落在 tokenizer、检查点、上下文截断和采样参数上。
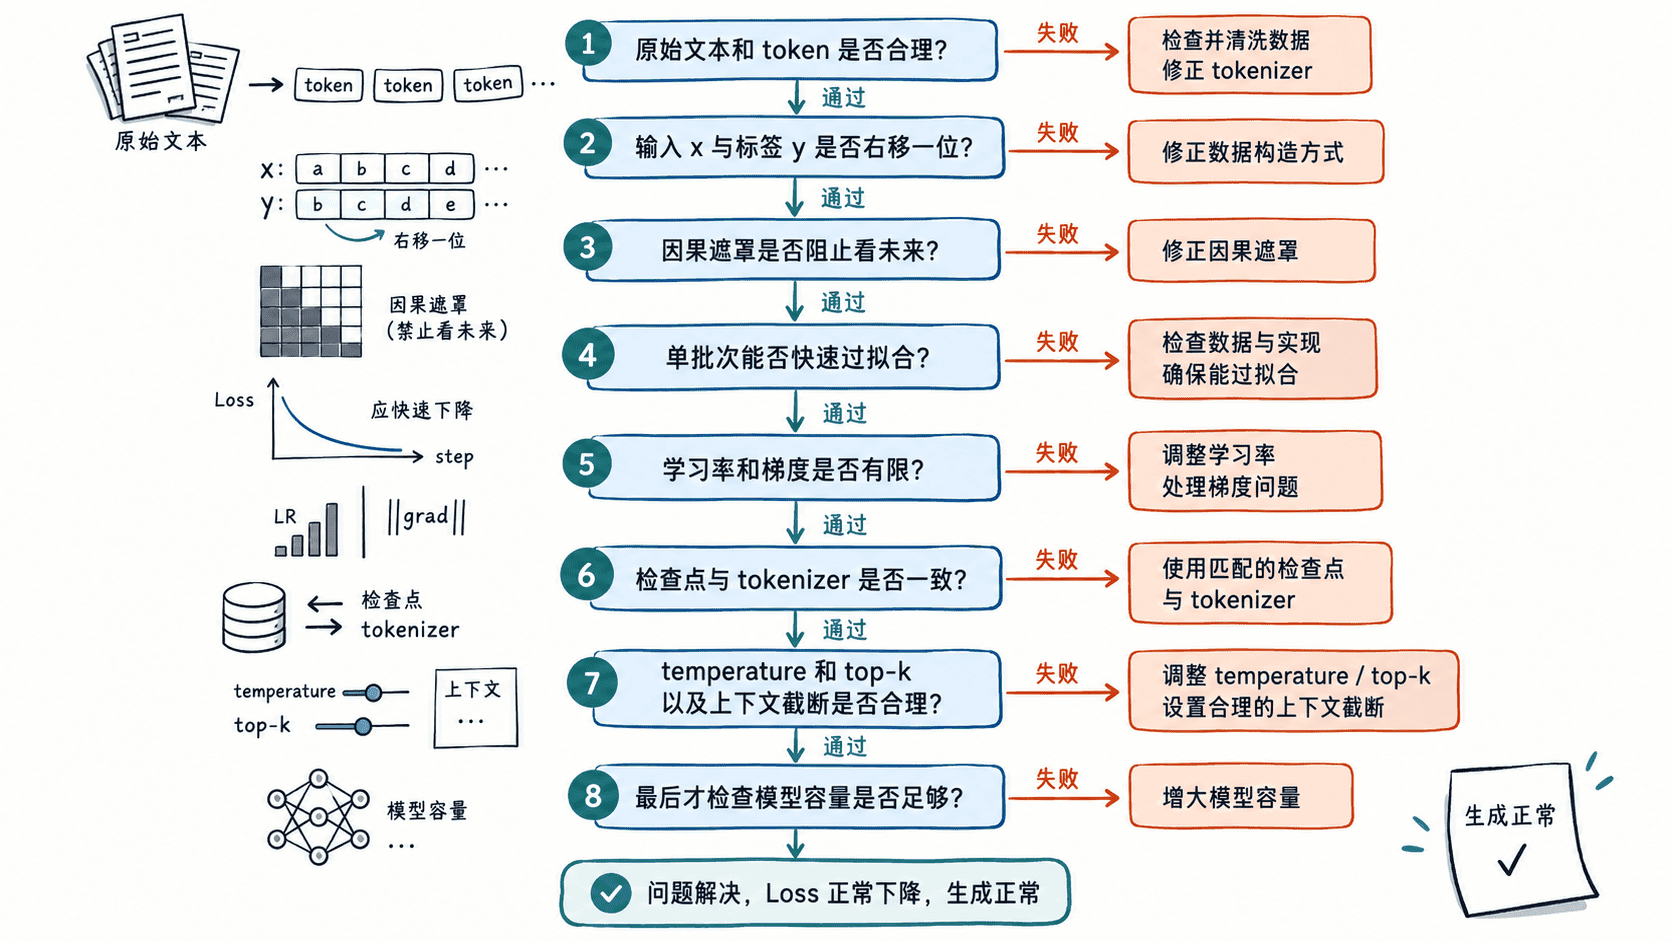
排查顺序很重要。先检查确定性的张量关系,再调整超参数;否则你可能花很长时间调学习率,却没有发现标签其实与输入完全相同。
按顺序检查数据与标签
语言模型训练的核心关系是:输入位置 预测标签位置 。如果把同一段 token 同时当作 x 和 y,模型会学习复制当前 token;如果标签多移或少移一位,Loss 也可能下降,但生成语义会明显异常。
先直接打印一个短样本的 token ID,并确认 x[:, 1:] 与 y[:, :-1] 对齐。之后再确认词表没有意外变化,例如微调时重新构建 tokenizer,却加载了旧检查点的 embedding 权重。
检查遮罩、学习率和数值稳定性
因果注意力必须禁止当前位置读取未来 token。遮罩方向反了时,训练 Loss 可能异常漂亮,因为模型偷看了答案,但自回归生成时没有未来信息可读,于是立刻崩溃。反过来,如果连过去位置也被遮掉,模型又会失去上下文能力。
学习率则看 Loss 形态:几乎水平且梯度正常,先尝试适度增大学习率;高频剧烈震荡或很快出现 NaN,先降低学习率,再检查梯度、logits 和 Loss 是否都为有限值。混合精度训练还要确认缩放器没有持续跳过更新。
用单批次过拟合作为总开关
单批次过拟合是最有效的实现级自检之一:固定一小段 token,连续在同一个 batch 上更新,Loss 应该明显下降。若连一个 batch 都学不会,就不要继续调数据量、epoch 或采样温度,优先检查前向计算、标签、梯度和参数更新。
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "cpu"
vocab_size = 16
tokens = torch.tensor([[1, 2, 3, 4, 5, 6]], dtype=torch.long, device=device)
x = tokens[:, :-1]
y = tokens[:, 1:]

class TinyCausalLM(nn.Module):
    def __init__(self):
        super().__init__()
        self.emb = nn.Embedding(vocab_size, 32)
        self.attn = nn.MultiheadAttention(32, 4, batch_first=True)
        self.norm = nn.LayerNorm(32)
        self.head = nn.Linear(32, vocab_size)

    def forward(self, idx):
        h = self.emb(idx)
        t = idx.size(1)
        # True 表示禁止注意该位置,因此只遮住严格的未来区域。
        future = torch.triu(
            torch.ones(t, t, dtype=torch.bool, device=idx.device),
            diagonal=1,
        )
        attn_out, _ = self.attn(
            h, h, h,
            attn_mask=future,
            need_weights=False,
        )
        return self.head(self.norm(h + attn_out))

model = TinyCausalLM().to(device)
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-2)

with torch.no_grad():
    initial = F.cross_entropy(
        model(x).reshape(-1, vocab_size),
        y.reshape(-1),
    ).item()

for _ in range(200):
    logits = model(x)
    loss = F.cross_entropy(logits.reshape(-1, vocab_size), y.reshape(-1))
    optimizer.zero_grad(set_to_none=True)
    loss.backward()

    # 梯度出现 NaN/Inf 时,继续调采样参数没有意义。
    assert all(
        p.grad is None or torch.isfinite(p.grad).all()
        for p in model.parameters()
    )
    optimizer.step()

with torch.no_grad():
    final = F.cross_entropy(
        model(x).reshape(-1, vocab_size),
        y.reshape(-1),
    ).item()

assert torch.equal(x[:, 1:], y[:, :-1])
assert final < initial * 0.25
print(f"label shift: ok, initial={initial:.4f}, final={final:.4f}")
print("single-batch overfit: passed")
预期输出中的 Loss 数值会变化,但最终 Loss 应显著低于初始值,并且断言全部通过。
label shift: ok, initial=<LOSS>, final=<LOWER_LOSS>
single-batch overfit: passed
如果这个测试失败,先不要怀疑模型容量。检查是否忘了 optimizer.step()、是否在错误位置调用 detach()、参数是否被错误冻结,以及 cross_entropy 接收到的 logits 最后一维是否真的是词表大小。
生成仍乱码时检查采样链路
单批次测试通过、真实训练 Loss 也能下降,但生成乱码时,优先核对训练和推理是否使用同一 tokenizer、词表顺序和词表大小。embedding 或输出层只要与 tokenizer 映射错位,模型学到的 token ID 就会被解释成另一套符号。
然后把采样策略收紧:先用较低 temperature,限制合理的 top_k,并确认每次生成只把最后 block_size 个 token 送回模型。若贪心生成也完全不可读,再回到检查点一致性和训练数据;如果贪心正常而高温采样乱码,问题通常在采样参数而不是训练本身。
模型容量应最后检查。只有当数据、标签、遮罩、梯度、学习率、检查点和采样都已验证正确,而且训练 Loss 与验证 Loss 都长期停在明显偏高位置时,才有理由增加层数、宽度或上下文长度。按这个顺序排查,能把 Loss 不降和生成乱码从模糊现象收敛成几个可以逐项验证的工程问题。