
大模型原理与训练 / 系统课时
把单头扩展成多头注意力
把单头扩展成多头注意力
单头注意力只能用一组查询、键和值去解释上下文关系。本篇把它扩展为并行的多个 Attention Head,再把各头结果拼接回原始嵌入维度,最终得到一个可直接放进 nanoGPT Block 的多头因果自注意力模块。
学习目标
- 理解多头注意力为什么要把嵌入维度拆成多个独立子空间
- 用 PyTorch 实现多个因果 Attention Head 的并行计算与结果拼接
- 检查张量形状、因果遮罩与输出维度是否正确
多头注意力改变了什么
设输入张量形状为 (B, T, C),其中 B 是批大小,T 是序列长度,C 是嵌入维度。单头注意力只产生一张注意力权重图;多头注意力让多组独立的 query、key、value 投影同时观察同一序列。
如果 C = 32、n_head = 4,每个头可使用 head_size = 8。四个头分别得到 (B, T, 8),最后沿最后一维拼接为 (B, T, 32)。不同头因此拥有独立参数和独立注意力权重,可以在不同子空间学习不同的上下文关系。
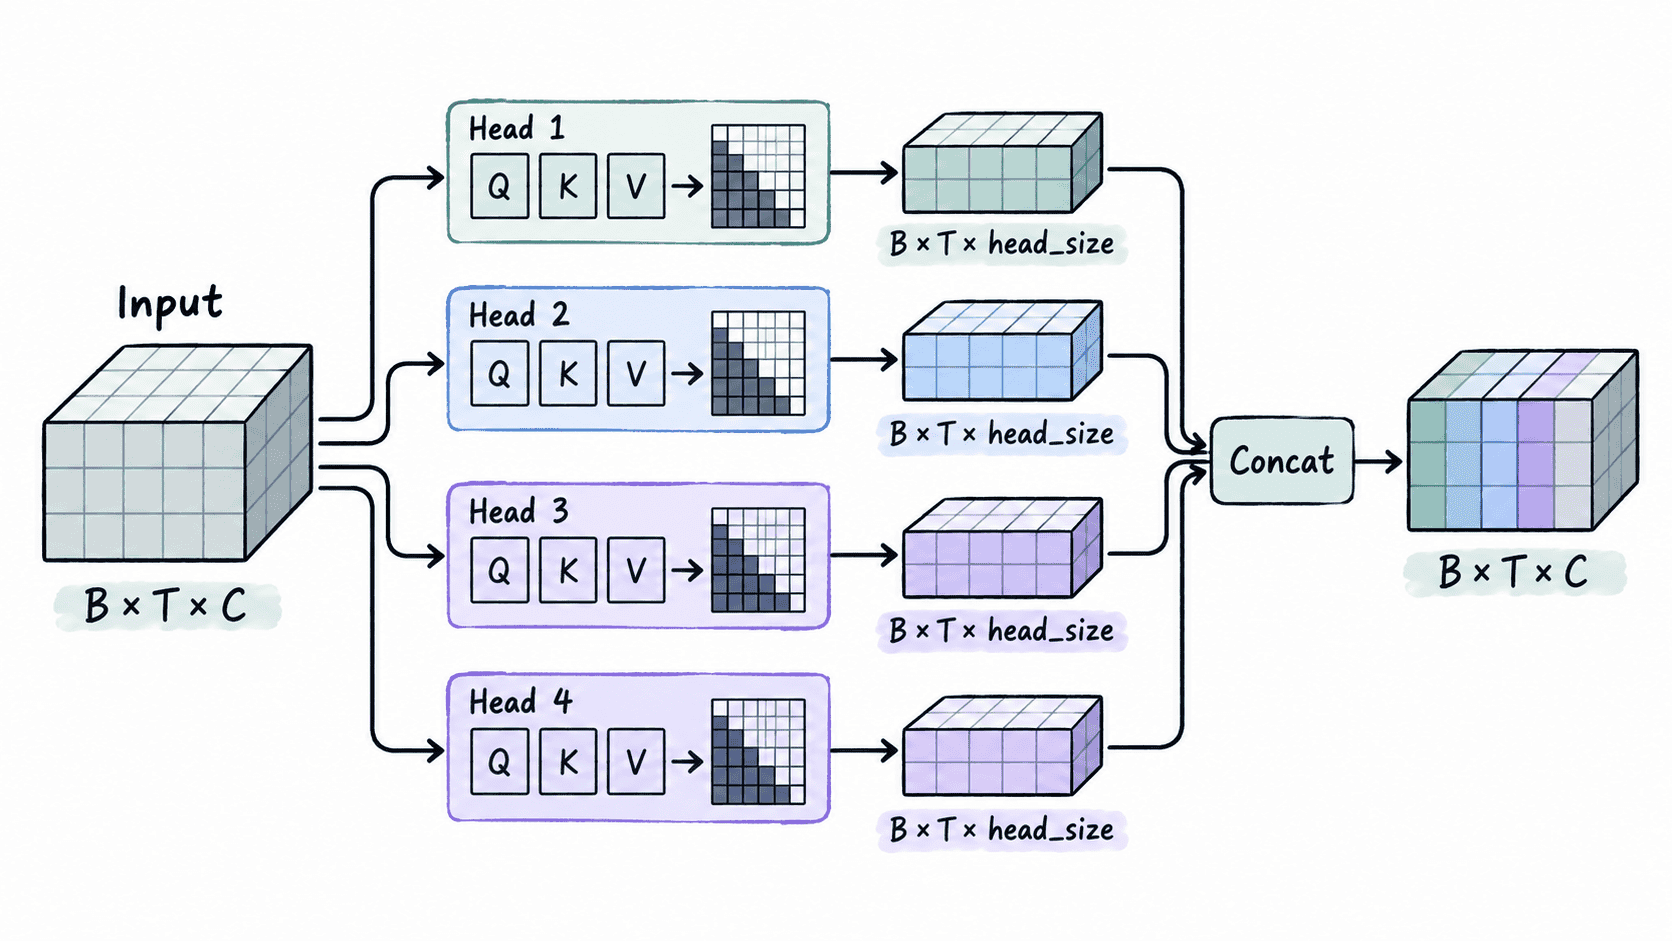
关键约束是所有头的输出维度之和仍等于 C。如果每个头都输出完整的 C 维,拼接后会膨胀成 n_head * C,无法直接接回原有 GPT Block。
实现并行 Head 与拼接
下面的完整示例先定义单个因果 Head,再用 nn.ModuleList 创建多个独立 Head。每个 Head 接收同一输入,内部使用下三角遮罩屏蔽未来 Token,最终通过 torch.cat(..., dim=-1) 沿通道维拼接。
import torch
import torch.nn as nn
from torch.nn import functional as F

class Head(nn.Module):
    def __init__(self, n_embd: int, head_size: int, block_size: int):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)

        # 遮罩不是可训练参数,但需要跟随模型迁移到对应设备。
        self.register_buffer("tril", torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        _, T, _ = x.shape
        k = self.key(x)
        q = self.query(x)

        # 缩放点积后屏蔽未来位置,再归一化为注意力权重。
        wei = q @ k.transpose(-2, -1) * (k.shape[-1] ** -0.5)
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float("-inf"))
        wei = F.softmax(wei, dim=-1)
        return wei @ self.value(x)

class MultiHeadAttention(nn.Module):
    def __init__(self, n_embd: int, num_heads: int, block_size: int):
        super().__init__()
        if n_embd % num_heads != 0:
            raise ValueError("n_embd 必须能被 num_heads 整除")

        self.head_size = n_embd // num_heads
        self.heads = nn.ModuleList(
            [Head(n_embd, self.head_size, block_size) for _ in range(num_heads)]
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return torch.cat([head(x) for head in self.heads], dim=-1)

if __name__ == "__main__":
    torch.manual_seed(42)
    B, T, C = 2, 8, 32
    x = torch.randn(B, T, C)

    attn = MultiHeadAttention(n_embd=C, num_heads=4, block_size=16)
    y = attn(x)

    # 修改最后一个未来位置,前 7 个位置的输出不应变化。
    x_changed = x.clone()
    x_changed[:, 7, :] += 1000
    y_changed = attn(x_changed)

    print("input:", tuple(x.shape))
    print("output:", tuple(y.shape))
    print("heads:", len(attn.heads))
    print("head_size:", attn.head_size)
    print("prefix_unchanged:", torch.allclose(y[:, :7], y_changed[:, :7], atol=1e-5))
预期输出:
input: (2, 8, 32)
output: (2, 8, 32)
heads: 4
head_size: 8
prefix_unchanged: True
prefix_unchanged: True 说明改变第 8 个 Token 不会反向影响前 7 个位置,因果遮罩仍然有效。输出最后一维保持 32,说明四个 8 维 Head 已正确拼接。
理解独立子空间
多个 Head 的“独立”来自各自拥有不同的线性层参数,而不是把输入预先硬切成四段。每个 Head 都能看到完整的 C 维输入,再把它投影到自己的 head_size 维子空间中。因此,一个头可以关注近邻关系,另一个头可以关注更远的依赖,具体模式由训练数据决定。
拼接只负责把这些子空间并排放回通道维,并不会再次交换信息。在更完整的 GPT 实现中,拼接后通常还会接一个输出投影,让不同头的结果重新混合;本节先保留并行 Head 与拼接这一核心结构。
常见维度错误
n_embd 必须能被 num_heads 整除。比如 C = 30、num_heads = 8 时无法得到等宽的 Head,本例会直接抛出 ValueError,避免静默截断。
另一个常见错误是把 torch.cat 写到序列维 dim=1。这样会把序列长度从 T 扩成 n_head * T,破坏 Token 位置结构。多头注意力要扩展并恢复的是特征通道维,因此拼接必须发生在最后一维 dim=-1。