
大模型原理与训练 / 系统课时
完成一轮小型 GPT 预训练
完成一轮小型 GPT 预训练
这一节把已经准备好的 token 数据真正送进一个小型 GPT,串起取批次、前向计算、AdamW、学习率调度、验证集评估与检查点保存。完成后,你将得到一条可重复运行、能用验证损失判断是否继续训练的最小预训练闭环。
学习目标
- 把训练数据、GPT、优化器和学习率调度器接成完整训练循环
- 定期计算训练与验证损失,并保存验证集最优检查点
- 根据验证损失趋势判断继续训练、提前停止或调整配置
先锁定训练输入与验收指标
下面示例假设数据预处理已经产出 data/shakespeare_char/train.bin、val.bin 和 meta.pkl。两个二进制文件保存 uint16 token ID,meta.pkl 至少包含 vocab_size。如果你使用 GPT-2 BPE 数据,只需把目录改成对应预处理结果,训练循环本身不变。
这轮训练先只验收三件事:训练损失能够下降;验证损失在若干评估点上至少出现一次改善;out/ckpt.pt 能保存最优模型、优化器状态和迭代位置。不要只看训练损失,它持续下降而验证损失回升,通常说明已经开始过拟合。
看清一次迭代如何闭环
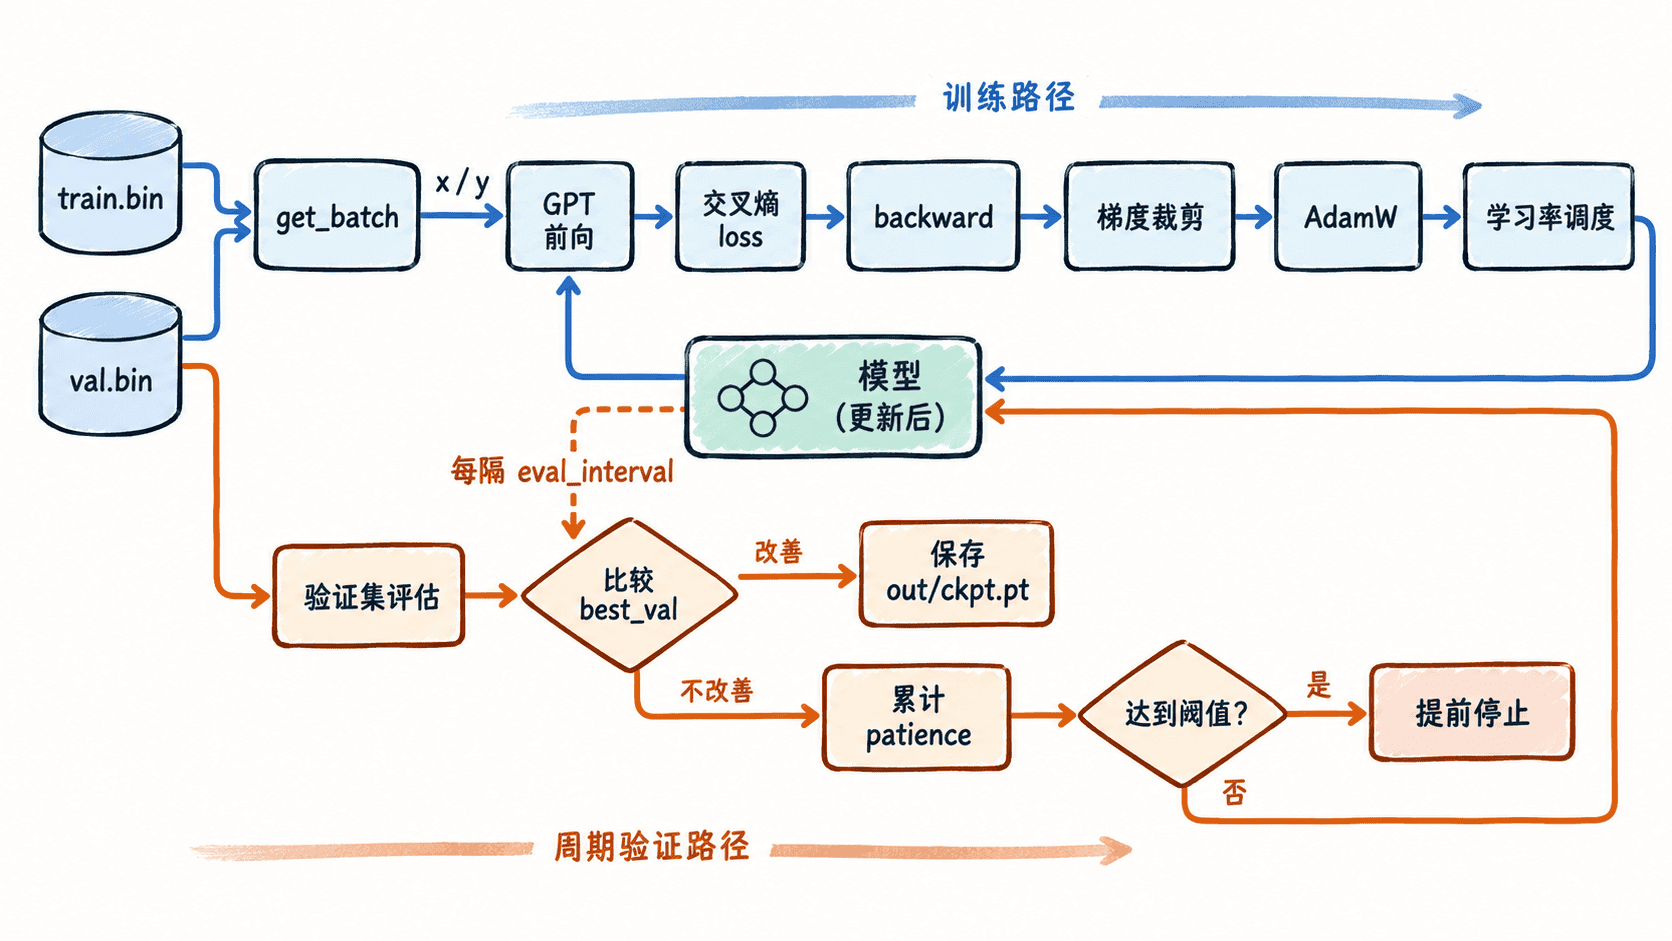
训练时每个 batch 都会执行“取样本 → 前向 → 计算 loss → 反向 → 更新参数”。验证路径不做反向传播,只周期性抽取多个 batch 求平均 loss。只有验证 loss 创下新低时才覆盖检查点,因此磁盘中的文件始终代表当前最好版本,而不是最后一次迭代。
跑通一轮可恢复训练
将下面程序保存为 train_small.py,并在项目根目录执行 python train_small.py。示例使用一个最小因果 Transformer,重点是把训练闭环完整跑通;如果你已经有自己的 GPT 类,可保持训练循环不变,只替换 TinyGPT。
from pathlib import Path
import math
import pickle

import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(1337)
device = "cuda" if torch.cuda.is_available() else "cpu"

data_dir = Path("data/shakespeare_char")
out_dir = Path("out")
out_dir.mkdir(exist_ok=True)
ckpt_path = out_dir / "ckpt.pt"

block_size = 128
batch_size = 32
n_layer, n_head, n_embd = 4, 4, 128
max_iters = 600
eval_interval, eval_iters = 100, 20
learning_rate, min_lr = 3e-4, 3e-5
warmup_iters = 50
patience = 3

with open(data_dir / "meta.pkl", "rb") as f:
    vocab_size = pickle.load(f)["vocab_size"]

train_data = np.memmap(data_dir / "train.bin", dtype=np.uint16, mode="r")
val_data = np.memmap(data_dir / "val.bin", dtype=np.uint16, mode="r")

def get_batch(split):
    data = train_data if split == "train" else val_data
    ix = torch.randint(len(data) - block_size - 1, (batch_size,))
    x = torch.stack([
        torch.from_numpy(np.array(data[i:i + block_size], dtype=np.int64))
        for i in ix
    ])
    y = torch.stack([
        torch.from_numpy(np.array(data[i + 1:i + 1 + block_size], dtype=np.int64))
        for i in ix
    ])
    return x.to(device), y.to(device)

class Block(nn.Module):
    def __init__(self):
        super().__init__()
        self.ln1 = nn.LayerNorm(n_embd)
        self.attn = nn.MultiheadAttention(
            n_embd, n_head, dropout=0.0, batch_first=True
        )
        self.ln2 = nn.LayerNorm(n_embd)
        self.mlp = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.GELU(),
            nn.Linear(4 * n_embd, n_embd),
        )

    def forward(self, x):
        t = x.size(1)
        mask = torch.full((t, t), float("-inf"), device=x.device)
        mask = torch.triu(mask, diagonal=1)
        h = self.ln1(x)
        a, _ = self.attn(h, h, h, attn_mask=mask, need_weights=False)
        x = x + a
        return x + self.mlp(self.ln2(x))

class TinyGPT(nn.Module):
    def __init__(self):
        super().__init__()
        self.tok_emb = nn.Embedding(vocab_size, n_embd)
        self.pos_emb = nn.Embedding(block_size, n_embd)
        self.blocks = nn.ModuleList([Block() for _ in range(n_layer)])
        self.ln_f = nn.LayerNorm(n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size, bias=False)
        self.lm_head.weight = self.tok_emb.weight

    def forward(self, idx, targets=None):
        _, t = idx.shape
        pos = torch.arange(t, device=idx.device)
        x = self.tok_emb(idx) + self.pos_emb(pos)
        for block in self.blocks:
            x = block(x)
        logits = self.lm_head(self.ln_f(x))
        loss = None
        if targets is not None:
            loss = F.cross_entropy(
                logits.view(-1, vocab_size), targets.view(-1)
            )
        return logits, loss

model = TinyGPT().to(device)
optimizer = torch.optim.AdamW(
    model.parameters(), lr=learning_rate, weight_decay=0.1
)

def get_lr(it):
    if it < warmup_iters:
        return learning_rate * (it + 1) / warmup_iters
    ratio = min(1.0, (it - warmup_iters) / (max_iters - warmup_iters))
    coeff = 0.5 * (1.0 + math.cos(math.pi * ratio))
    return min_lr + coeff * (learning_rate - min_lr)

@torch.no_grad()
def estimate_loss():
    model.eval()
    result = {}
    for split in ("train", "val"):
        values = torch.zeros(eval_iters)
        for k in range(eval_iters):
            x, y = get_batch(split)
            _, loss = model(x, y)
            values[k] = loss.item()
        result[split] = values.mean().item()
    model.train()
    return result

start_iter, best_val, stale = 0, float("inf"), 0
if ckpt_path.exists():
    state = torch.load(ckpt_path, map_location=device)
    model.load_state_dict(state["model"])
    optimizer.load_state_dict(state["optimizer"])
    start_iter = state["iter"] + 1
    best_val = state["best_val"]
    print(f"resumed from iter={start_iter}")

print(f"device={device} vocab_size={vocab_size}")

for it in range(start_iter, max_iters):
    lr = get_lr(it)
    for group in optimizer.param_groups:
        group["lr"] = lr

    if it % eval_interval == 0:
        losses = estimate_loss()
        print(
            f"iter={it:04d} train_loss={losses['train']:.4f} "
            f"val_loss={losses['val']:.4f} lr={lr:.2e}"
        )
        if losses["val"] < best_val:
            best_val, stale = losses["val"], 0
            torch.save(
                {
                    "model": model.state_dict(),
                    "optimizer": optimizer.state_dict(),
                    "iter": it,
                    "best_val": best_val,
                },
                ckpt_path,
            )
            print(f"checkpoint saved: {ckpt_path}")
        else:
            stale += 1
            if stale >= patience:
                print("early stop: validation loss stopped improving")
                break

    x, y = get_batch("train")
    _, loss = model(x, y)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
    optimizer.step()

print(f"training finished: best_val={best_val:.4f}")
预期输出
device=<DEVICE> vocab_size=<VOCAB_SIZE>
iter=0000 train_loss=<TRAIN_LOSS> val_loss=<VAL_LOSS> lr=<LEARNING_RATE>
checkpoint saved: out/ckpt.pt
iter=0100 train_loss=<TRAIN_LOSS> val_loss=<VAL_LOSS> lr=<LEARNING_RATE>
...
training finished: best_val=<BEST_VAL><DEVICE>、<VOCAB_SIZE> 和各项 loss 会随环境、数据与随机采样变化。第一次评估必然会保存检查点,因为初始 best_val 为正无穷;后续只有验证损失继续降低才会覆盖该文件。如果连续三个评估点都没有改善,程序会提前停止。
用验证损失决定下一步
观察验证曲线时,先比较趋势而不是单个点。训练损失与验证损失都下降,说明还在有效学习;训练损失下降但验证损失连续上升,优先考虑提前停止、增大数据量或减小模型容量;两者都几乎不动,则检查学习率是否过小、数据是否重复或梯度是否异常。
如果 loss 明显震荡甚至变成 nan,先把学习率降低到原来的三分之一到十分之一,再检查输入 token 是否越界和梯度范数是否爆炸。若训练稳定但很慢,可在显存允许时增大 batch_size,或使用梯度累积获得更大的有效 batch,而不要直接把学习率同时放大。
验收检查点而不是只看日志
训练结束后至少确认 out/ckpt.pt 存在,并且保存的是验证集最优版本。重新执行脚本时,如果看到 resumed from iter=<ITER>,说明模型、优化器和迭代位置都能恢复;若只恢复模型参数而丢失优化器状态,学习率与 AdamW 的动量会重新开始,继续训练的轨迹会发生明显变化。
完成这一轮后,是否继续扩大模型或训练步数应由验证损失决定:验证损失仍稳定下降时继续训练;长期平台期先调学习率或数据;持续恶化则保留最佳检查点并停止,而不是机械地跑满最大迭代数。