
大模型原理与训练 / 系统课时
固定随机性复现实验结果
固定随机性复现实验结果
同一份 nanoGPT 代码重复运行却得到不同曲线,往往不是模型逻辑错了,而是初始化、批次采样、Dropout、数据加载或设备内核消耗了不同随机序列。本节建立可复现边界,让实验差异尽量只来自你主动修改的变量。
学习目标
- 同时固定 Python、NumPy 与 PyTorch 的随机源
- 将数据采样随机性与模型内部随机性隔离
- 区分逐位确定性与工程上可比较的实验复现
复现不等于只写一个 seed
torch.manual_seed() 只覆盖 PyTorch 的随机状态,不能自动控制 Python random、NumPy、数据加载 worker 或所有设备级算法。更隐蔽的问题是共享随机序列:如果训练采样与评估采样都调用全局 RNG,那么仅仅修改 eval_interval,就可能改变后续训练批次。
因此要把“随机来源”拆开管理:全局种子负责模型初始化和常规算子;独立 torch.Generator 负责训练数据采样;评估阶段再使用自己的生成器。实验配置、数据切分和软件环境也必须一起固定,否则相同 seed 仍然不能代表相同实验。
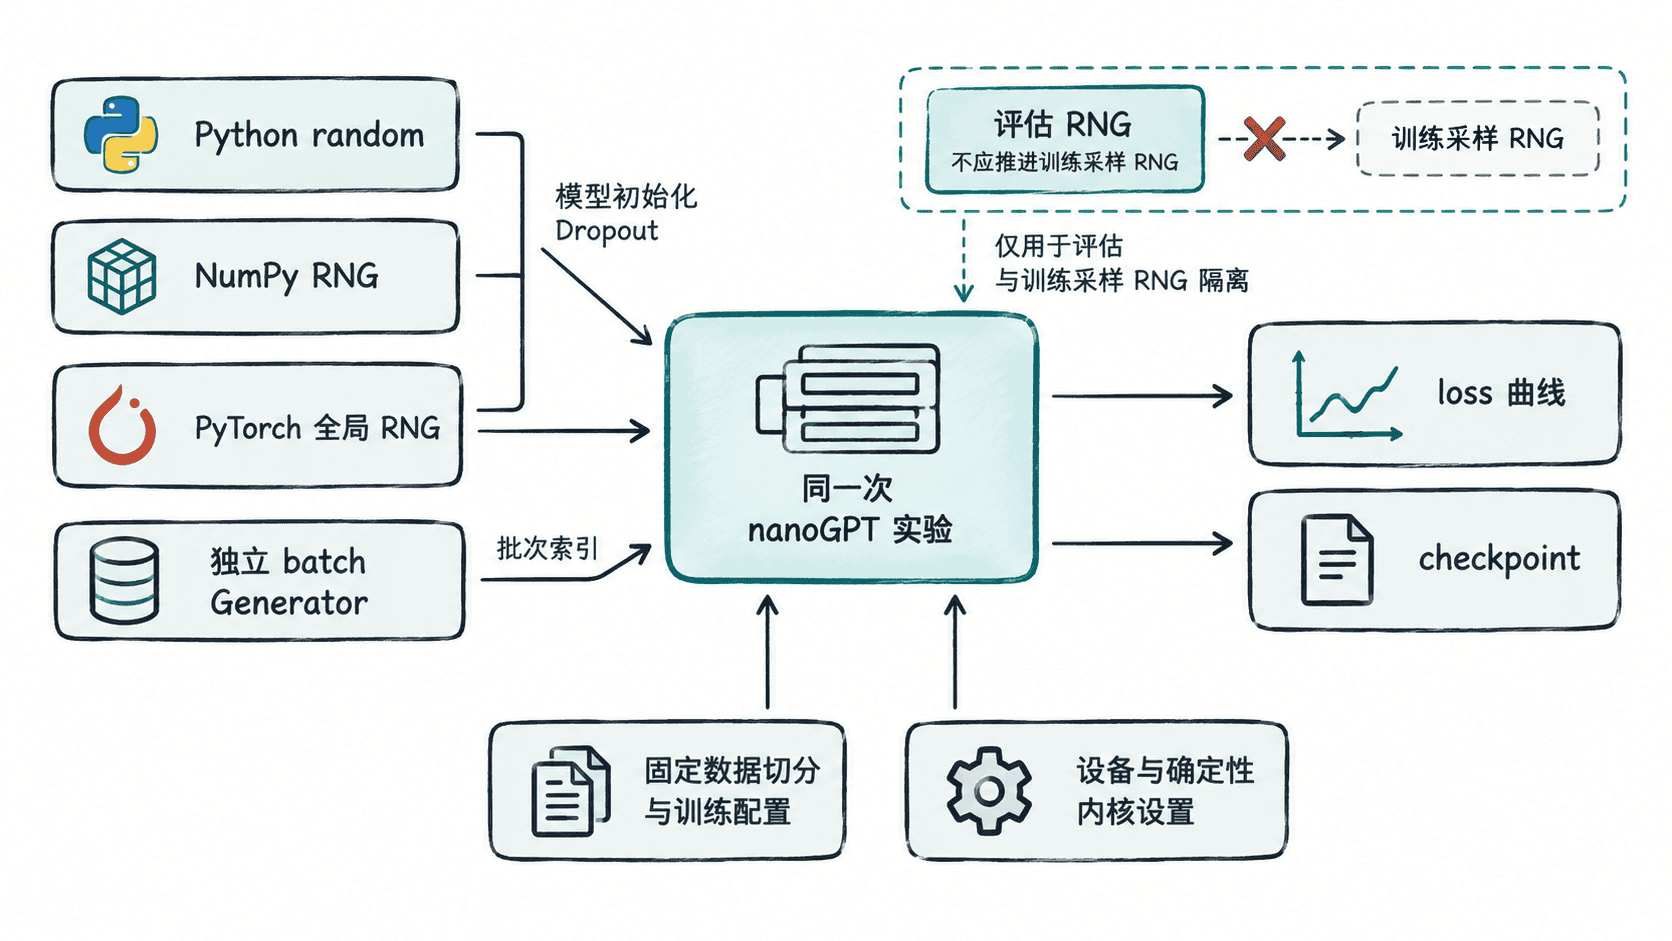
用独立生成器固定批次序列
下面的脚本把常见随机源集中到 seed_everything(),并为批次索引单独创建生成器。相同 seed 连续运行两次会得到完全相同的前五个 loss;修改 seed 后,初始化和采样序列都会变化。
import random
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F

def seed_everything(seed):
    random.seed(seed)
    np.random.seed(seed)
    torch.manual_seed(seed)
    if torch.cuda.is_available():
        torch.cuda.manual_seed_all(seed)

    # 请求确定性算法;遇到无确定性实现的算子时直接报错。
    torch.use_deterministic_algorithms(True)
    if torch.backends.cudnn.is_available():
        torch.backends.cudnn.benchmark = False
        torch.backends.cudnn.deterministic = True

vocab_size = 16
block_size = 4
batch_size = 8
data = torch.arange(0, 256) % vocab_size

def get_batch(generator):
    ix = torch.randint(
        0,
        len(data) - block_size - 1,
        (batch_size,),
        generator=generator,
    )
    x = torch.stack([data[i:i + block_size] for i in ix])
    y = torch.stack([data[i + 1:i + block_size + 1] for i in ix])
    return x, y

class TinyLM(nn.Module):
    def __init__(self):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets):
        logits = self.embedding(idx)
        b, t, c = logits.shape
        loss = F.cross_entropy(
            logits.view(b * t, c), targets.view(b * t)
        )
        return logits, loss

def run(seed):
    seed_everything(seed)

    # 数据采样拥有独立随机流,不受其他随机操作的调用次数影响。
    batch_gen = torch.Generator().manual_seed(seed + 1)
    model = TinyLM()
    optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
    losses = []

    for _ in range(5):
        xb, yb = get_batch(batch_gen)
        _, loss = model(xb, yb)
        losses.append(round(loss.item(), 6))

        optimizer.zero_grad(set_to_none=True)
        loss.backward()
        optimizer.step()

    return losses

first = run(1234)
second = run(1234)
third = run(1235)

print("same seed equal:", first == second)
print("different seed equal:", first == third)
print("losses:", first)
预期输出(同一 PyTorch/CPU 环境下):
same seed equal: True
different seed equal: False
losses: [3.753762, 3.416495, 3.432346, 3.362266, 3.292966]
这个检查比“看起来差不多”更严格:它直接验证相同 seed 是否产生同一批次序列、同一初始化和同一训练轨迹。
设备差异决定确定性的上限
完全逐位一致通常只应承诺在相同代码、依赖版本、硬件类型、设备、算子实现和运行参数下成立。CPU 与 GPU、不同 GPU 架构、不同 PyTorch 或 CUDA 版本,都可能因为浮点规约顺序和内核实现差异得到略有不同的结果。
torch.use_deterministic_algorithms(True) 的价值不是“让所有平台都得到同一串数字”,而是在当前环境中尽量选择确定性实现;如果某个算子没有确定性实现,它会暴露问题而不是静默继续。启用确定性通常还会牺牲一部分性能,因此更适合调试、回归测试和关键对比实验。
如果使用多进程 DataLoader,还需要固定其 generator 并正确初始化 worker seed。否则主进程已经固定随机种子,worker 仍可能以不同顺序产生样本。
用工程可复现替代不现实的逐位一致
日常训练更实用的目标是“同一结论可重复”:固定数据版本与切分、seed、batch size、学习率、模型配置、评估协议和依赖版本,然后要求关键指标在合理容差内一致。只有定位数值 bug 或写回归测试时,才值得进一步追求逐位相等。
每次实验至少记录 seed、代码提交版本、PyTorch/CUDA 版本、设备型号、训练参数和验证集最优 loss。比较两个实验时,先确认这些条件一致,再把指标差异归因于模型改动;否则所谓“提升”很可能只是随机性或环境变化。