
大模型原理与训练 / 系统课时
加入逐位置前馈网络
加入逐位置前馈网络
自注意力解决的是不同 Token 之间如何交换信息,但交换后的每个位置还需要独立做非线性变换。本篇实现 GPT Block 中的前馈网络,让每个 Token 在不与其他位置混合的前提下完成“扩维、激活、投影回嵌入维度”的特征加工。
学习目标
- 理解注意力与逐位置前馈网络在 GPT Block 中的职责分工
- 用两层线性层和非线性激活实现逐位置 MLP
- 验证前馈网络只改变最后一个特征维,不改变批次和序列长度
为什么还需要前馈网络
多头注意力输出形状仍是 (B, T, C)。它擅长根据上下文重新组合不同 Token 的信息,但如果后面没有非线性变换,模型对每个位置内部特征的加工能力会受限。
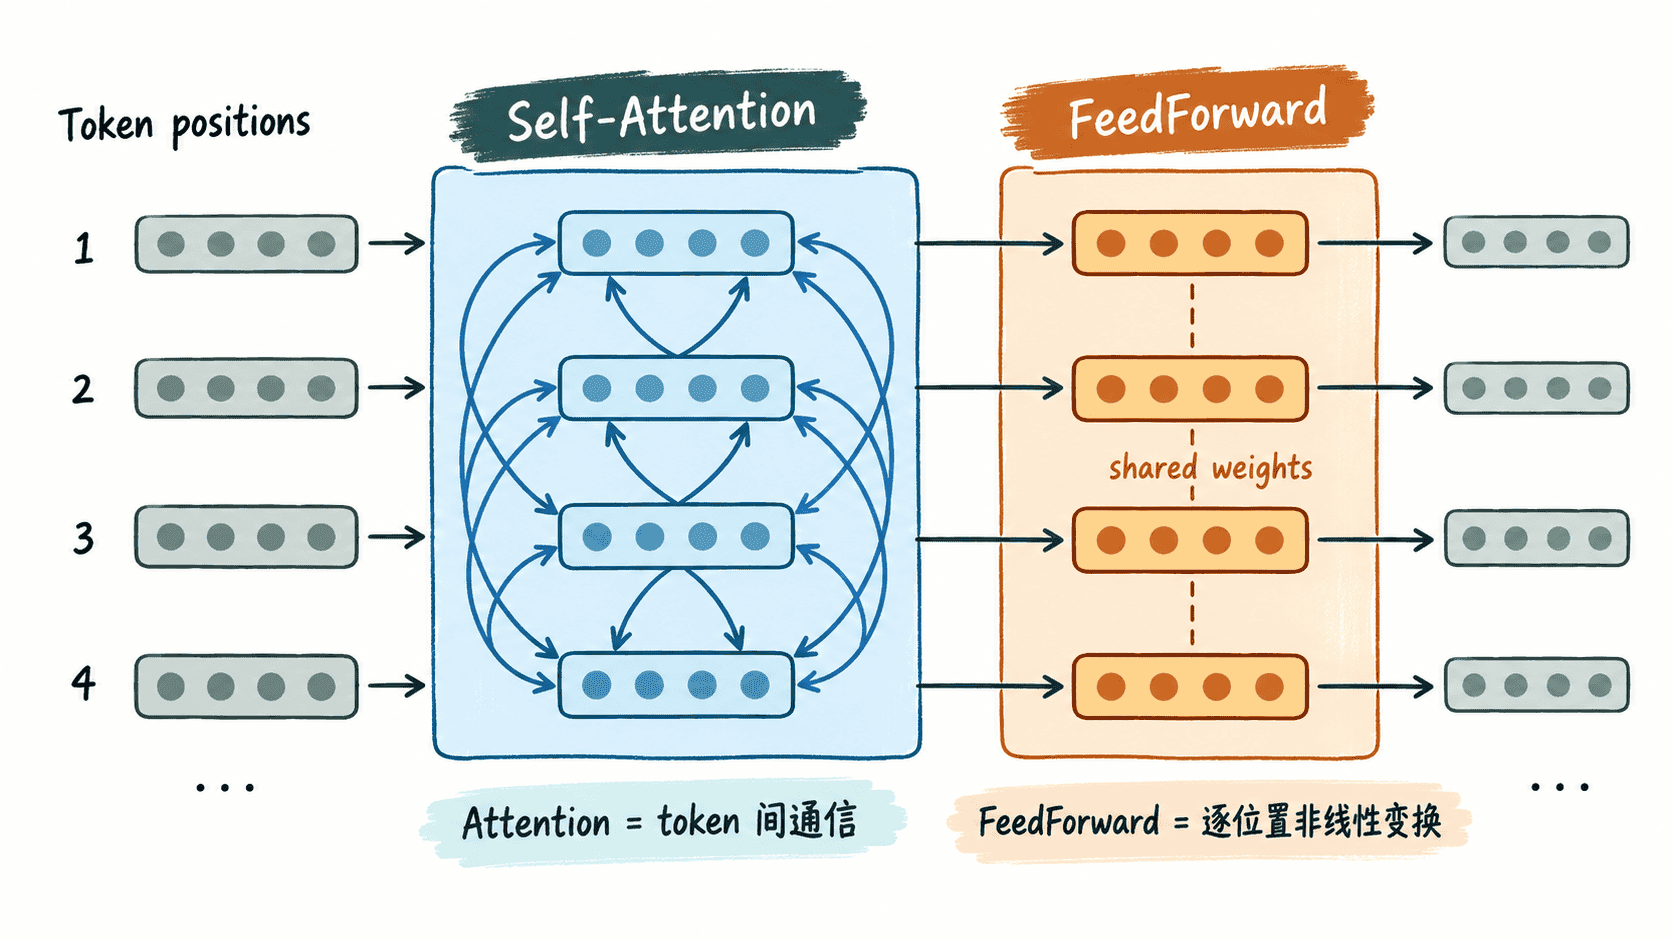
逐位置前馈网络对序列中的每个位置应用同一套 MLP。对于某个 Token,它只读取自己的 C 维向量,不直接读取相邻位置。可以把两者分工理解为:注意力负责“从别的位置取什么信息”,前馈网络负责“拿到信息后怎样加工”。
实现逐位置 MLP
nanoGPT 风格的前馈网络可以用两个线性层组成。第一层把通道从 C 扩到更宽的隐藏维度,经过激活函数后,第二层再投影回 C。常见 Transformer 会使用 4 * C 作为中间宽度。
下面用 ReLU 保持实现直观。重点不是激活函数名称,而是“先扩维做非线性加工,再回到原始嵌入维度”的结构。
import torch
import torch.nn as nn

class FeedForward(nn.Module):
    def __init__(self, n_embd: int):
        super().__init__()
        self.net = nn.Sequential(
            # 扩大每个 Token 的内部特征空间。
            nn.Linear(n_embd, 4 * n_embd),
            nn.ReLU(),
            nn.Linear(4 * n_embd, n_embd),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.net(x)

if __name__ == "__main__":
    torch.manual_seed(42)
    B, T, C = 2, 8, 32
    x = torch.randn(B, T, C)

    ffwd = FeedForward(n_embd=C)
    y = ffwd(x)

    # 只修改最后一个 Token,其他位置的输出应保持不变。
    x_changed = x.clone()
    x_changed[:, 7, :] += 1000
    y_changed = ffwd(x_changed)

    print("input:", tuple(x.shape))
    print("hidden_width:", 4 * C)
    print("output:", tuple(y.shape))
    print("prefix_unchanged:", torch.allclose(y[:, :7], y_changed[:, :7], atol=1e-5))
预期输出:
input: (2, 8, 32)
hidden_width: 128
output: (2, 8, 32)
prefix_unchanged: True
输入和输出都保持 (2, 8, 32),只有模块内部暂时扩展到 128 维。prefix_unchanged: True 则证明修改最后一个 Token 不会影响其他位置,符合逐位置计算的预期。
为什么它不会混合 Token
nn.Linear 默认作用于张量的最后一维。给它 (B, T, C) 输入时,PyTorch 会把同一个线性变换独立应用到全部 B × T 个位置,而不会把 T 维展平后互相混合。
单个位置的计算可以写成:
其中 x_t 只表示第 t 个 Token 的特征向量。所有位置共享 W_1、W_2,所以参数量不会随序列长度 T 增长,变化的只是实际计算次数。
接入 GPT Block 时保持接口一致
注意力输出 (B, T, C),前馈网络也输出 (B, T, C)。这种形状对齐很重要,因为后续加入残差连接时,需要把子层输出与输入做逐元素相加。
注意力和 MLP 都会改变向量内容,但职责不同:注意力的权重依赖当前序列,并沿时间维聚合历史信息;前馈网络使用固定参数,对每个位置做独立非线性映射,不访问其他位置。
在完整 GPT Block 中,这两个子层通常还会配合残差连接、LayerNorm 和 Dropout。当前最小实现先保证最关键的接口:序列长度不变、嵌入维度最终不变、每个 Token 经过更宽隐藏层独立完成非线性加工。