
大模型原理与训练 / 系统课时
用温度与 Top-k 控制采样
用温度与 Top-k 控制采样
自回归生成并不是每一步都选最大概率 token,而是先把当前 logits 变成一个可采样分布。温度控制分布的尖锐程度,Top-k 控制候选集合大小;把两者放进同一生成循环,就能在稳定性与多样性之间做可重复的调节。
学习目标
- 实现完整的自回归采样循环,并正确裁剪上下文窗口。
- 理解
temperature如何改变概率分布、top_k如何截断低概率候选。 - 根据“稳定、平衡、探索”三类目标选择合理参数,并识别过低或过高设置的副作用。
采样循环的关键顺序
每生成一个 token,都要执行同一条链路:截取最近的上下文,前向得到最后位置 logits,用温度缩放,按 Top-k 屏蔽尾部候选,做 softmax,再用多项式采样得到下一个 token,最后把它拼回序列继续迭代。
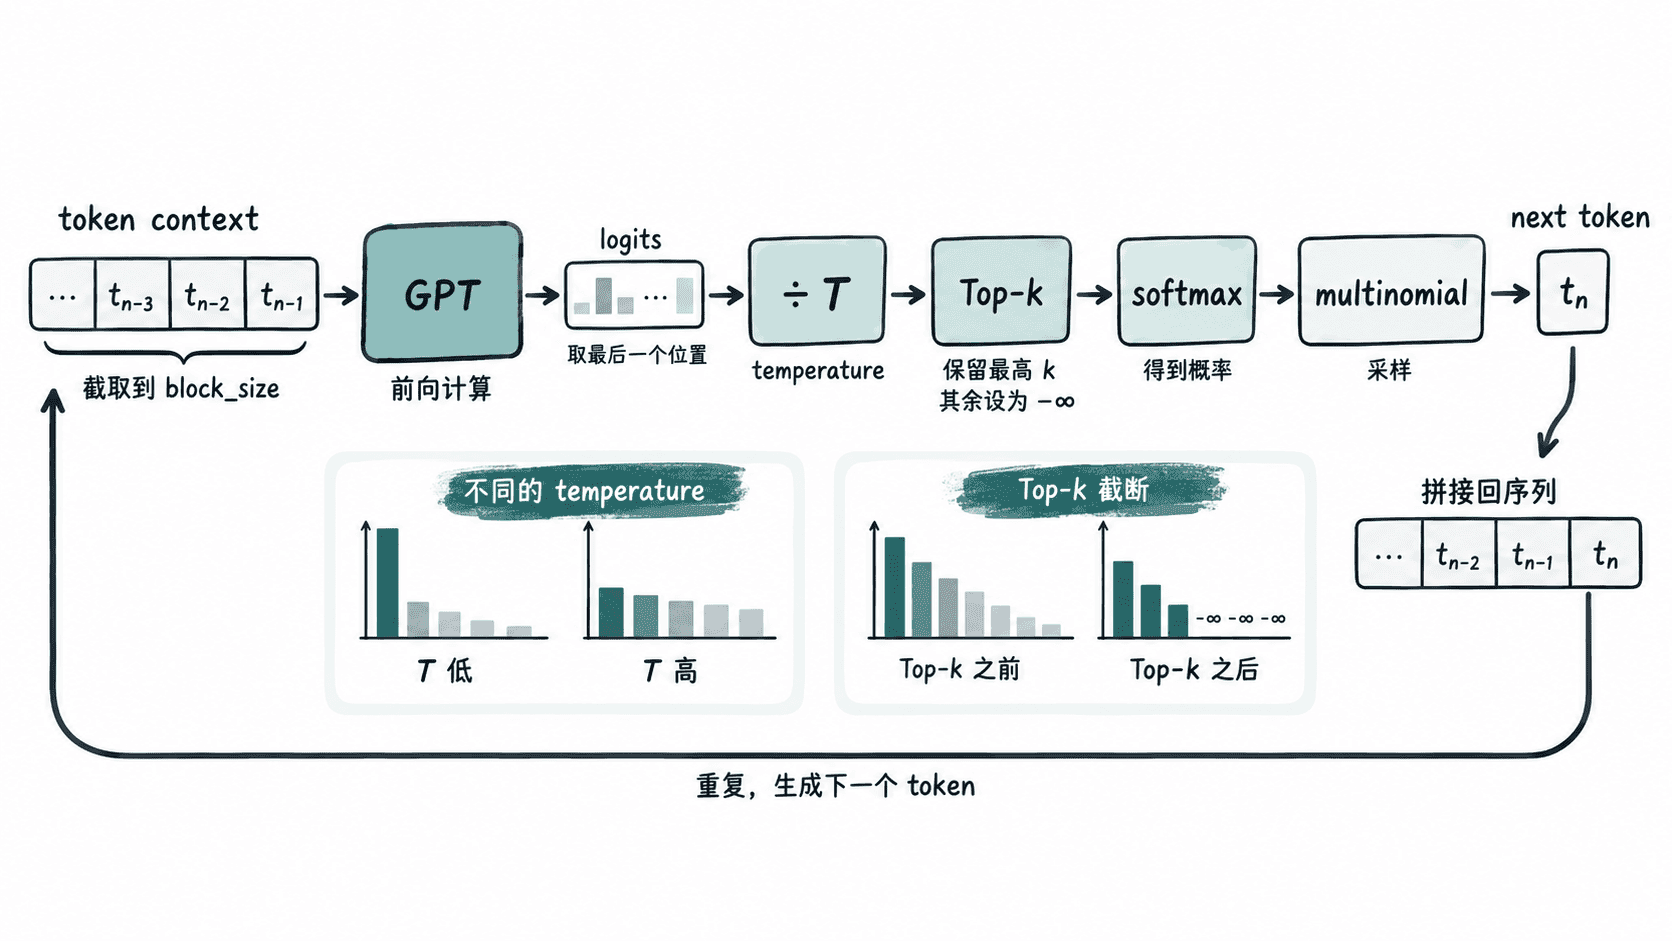
温度的计算是把 logits 除以正数 。当 时,大 logits 与小 logits 的差距被放大,分布更尖;当 时差距缩小,分布更平。Top-k 则只保留分数最高的 个 token,其他位置设为负无穷,因此 softmax 后它们的概率变为 0。
实现可控生成函数
下面函数兼容常见 nanoGPT 接口:model(idx) 返回 (logits, loss),并且无 targets 时至少给出最后一个位置的 logits。它会主动校验参数,避免 temperature=0 造成除零或负的 top_k 产生无意义行为。
from __future__ import annotations

import torch
import torch.nn.functional as F


@torch.no_grad()
def generate(
    model,
    idx: torch.Tensor,
    max_new_tokens: int,
    *,
    block_size: int,
    temperature: float = 1.0,
    top_k: int | None = None,
) -> torch.Tensor:
    if temperature <= 0:
        raise ValueError("temperature must be > 0")
    if top_k is not None and top_k <= 0:
        raise ValueError("top_k must be a positive integer or None")

    for _ in range(max_new_tokens):
        # 模型只能看到最近 block_size 个 token,避免越过位置 embedding 范围。
        idx_cond = idx[:, -block_size:]
        logits, _ = model(idx_cond)
        logits = logits[:, -1, :] / temperature

        if top_k is not None:
            k = min(top_k, logits.size(-1))
            values, _ = torch.topk(logits, k)
            cutoff = values[:, [-1]]
            logits = logits.masked_fill(logits < cutoff, float("-inf"))

        probs = F.softmax(logits, dim=-1)
        next_token = torch.multinomial(probs, num_samples=1)
        idx = torch.cat((idx, next_token), dim=1)

    return idx
这段函数本身不负责加载模型或 tokenizer。它只处理“给定 token 序列,怎样继续采样”,因此可以直接复用在从零训练模型、迁移后的 GPT-2 或任意兼容接口的模型上。
用三组参数比较生成风格
下面是完整调用方式的片段示例,依赖项目中的 model.py 与一个已训练 checkpoint。把 <PATH> 替换成实际 checkpoint 路径;示例使用 GPT-2 的 tiktoken 编码器。
import torch
import tiktoken

from model import GPT, GPTConfig

device = "cuda" if torch.cuda.is_available() else "cpu"
checkpoint = torch.load("<PATH>/ckpt.pt", map_location=device)

config = GPTConfig(**checkpoint["model_args"])
model = GPT(config)
model.load_state_dict(checkpoint["model"])
model.to(device).eval()

enc = tiktoken.get_encoding("gpt2")
prompt = "The future of software is"
start = torch.tensor(
    [enc.encode(prompt)],
    dtype=torch.long,
    device=device,
)

settings = [
    ("stable", 0.7, 40),
    ("balanced", 0.9, 100),
    ("exploratory", 1.2, None),
]

for name, temperature, top_k in settings:
    torch.manual_seed(42)
    out = generate(
        model,
        start.clone(),
        80,
        block_size=config.block_size,
        temperature=temperature,
        top_k=top_k,
    )
    text = enc.decode(out[0].tolist())
    print(f"[{name}]")
    print(text)
预期输出
[stable]
<GENERATED_TEXT>

[balanced]
<GENERATED_TEXT>

[exploratory]
<GENERATED_TEXT>
<GENERATED_TEXT> 取决于 checkpoint、设备和随机数实现,实际内容会不同。固定随机种子可以让同一环境中的比较更稳定,但 GPU 算子和软件版本仍可能带来细微差异。
选择参数时看什么
通常可以把 temperature=0.7, top_k=40 作为偏稳健起点:候选范围较小,且高概率 token 更占优势。需要更多变化时可逐步升高温度或放宽 Top-k,而不是一次把两者都推到极端。
| 目标 | temperature | top_k | 典型表现 |
|---|---|---|---|
| 稳定、少跑偏 | 0.6~0.8 | 20~50 | 更集中,也更容易重复 |
| 平衡 | 0.8~1.0 | 50~200 | 连贯性与变化较均衡 |
| 强探索 | 1.0~1.3 | None 或较大值 |
多样性高,跑题和乱码风险上升 |
这些范围是调参起点,不是模型无关的固定答案。小模型、训练不足的模型或领域窄模型通常更容易在高温下失控;相反,Top-k 过小会长期反复选择少数高频 token,形成循环句式。
如果业务需要完全确定的输出,不要把 temperature 设为 0,而应显式改用 argmax 做 greedy decoding。这样“随机采样”和“确定性解码”两种行为在代码层面是清晰分离的,也更容易测试与排障。