
大模型原理与训练 / 系统课时
定位吞吐没有随 GPU 增长
定位吞吐没有随 GPU 增长
多卡训练增加 GPU 后,如果每秒处理的 Token 几乎不涨,问题通常不在“DDP 没启动”,而在数据供给、单卡利用率、梯度同步或每卡工作量。这里用固定口径的单卡/多卡对照,把计算瓶颈与通信瓶颈拆开定位。
学习目标
- 用吞吐、MFU 与 GPU 利用率判断扩展效率是否真的异常
- 按数据准备、计算、梯度同步、批次规模的顺序定位瓶颈
- 设计单卡与多卡对照实验,避免把批次变化误判为硬件扩展问题
先统一吞吐口径
不要直接比较 iter/s。一次优化步处理了多少 Token,会随 batch_size、block_size、梯度累积和 GPU 数变化。更稳妥的口径是:
其中 是每卡微批次大小, 是序列长度, 是每个进程实际执行的梯度累积次数, 是 GPU 数。扩展效率可写成 。
nanoGPT 的 DDP 训练可能会按 world_size 调整每个进程实际执行的梯度累积次数,因此计算 Token 数时应以运行时实际值为准,而不是只看配置文件里的字面值。若要比较固定全局批次的强扩展,就保持每个优化步的全局 Token 数一致;若要测试硬件能否“吃满更多卡”,则保持每卡工作量接近一致,并接受全局批次随卡数增长。
从项目根目录先跑单卡基线,再用同一数据和模型配置跑多卡。将 <PATH> 替换为同一个 nanoGPT 配置文件路径。
CUDA_VISIBLE_DEVICES=0 python train.py <PATH> --max_iters=200 --eval_interval=1000000 --log_interval=10 --compile=True
CUDA_VISIBLE_DEVICES=0,1,2,3 torchrun --standalone --nproc_per_node=4 train.py <PATH> --max_iters=200 --eval_interval=1000000 --log_interval=10 --compile=True
预期输出
iter <ID>: loss <LOSS>, time <TIME>ms, mfu <MFU>%
...
前几十步可能包含编译、缓存和显存分配开销,不要纳入稳态平均。记录稳定区间的步耗时与 MFU,再按实际每步 Token 数换算 tokens/s;如果四卡吞吐明显小于单卡的四倍,就进入下面的分段定位。
沿数据到同步链路定位
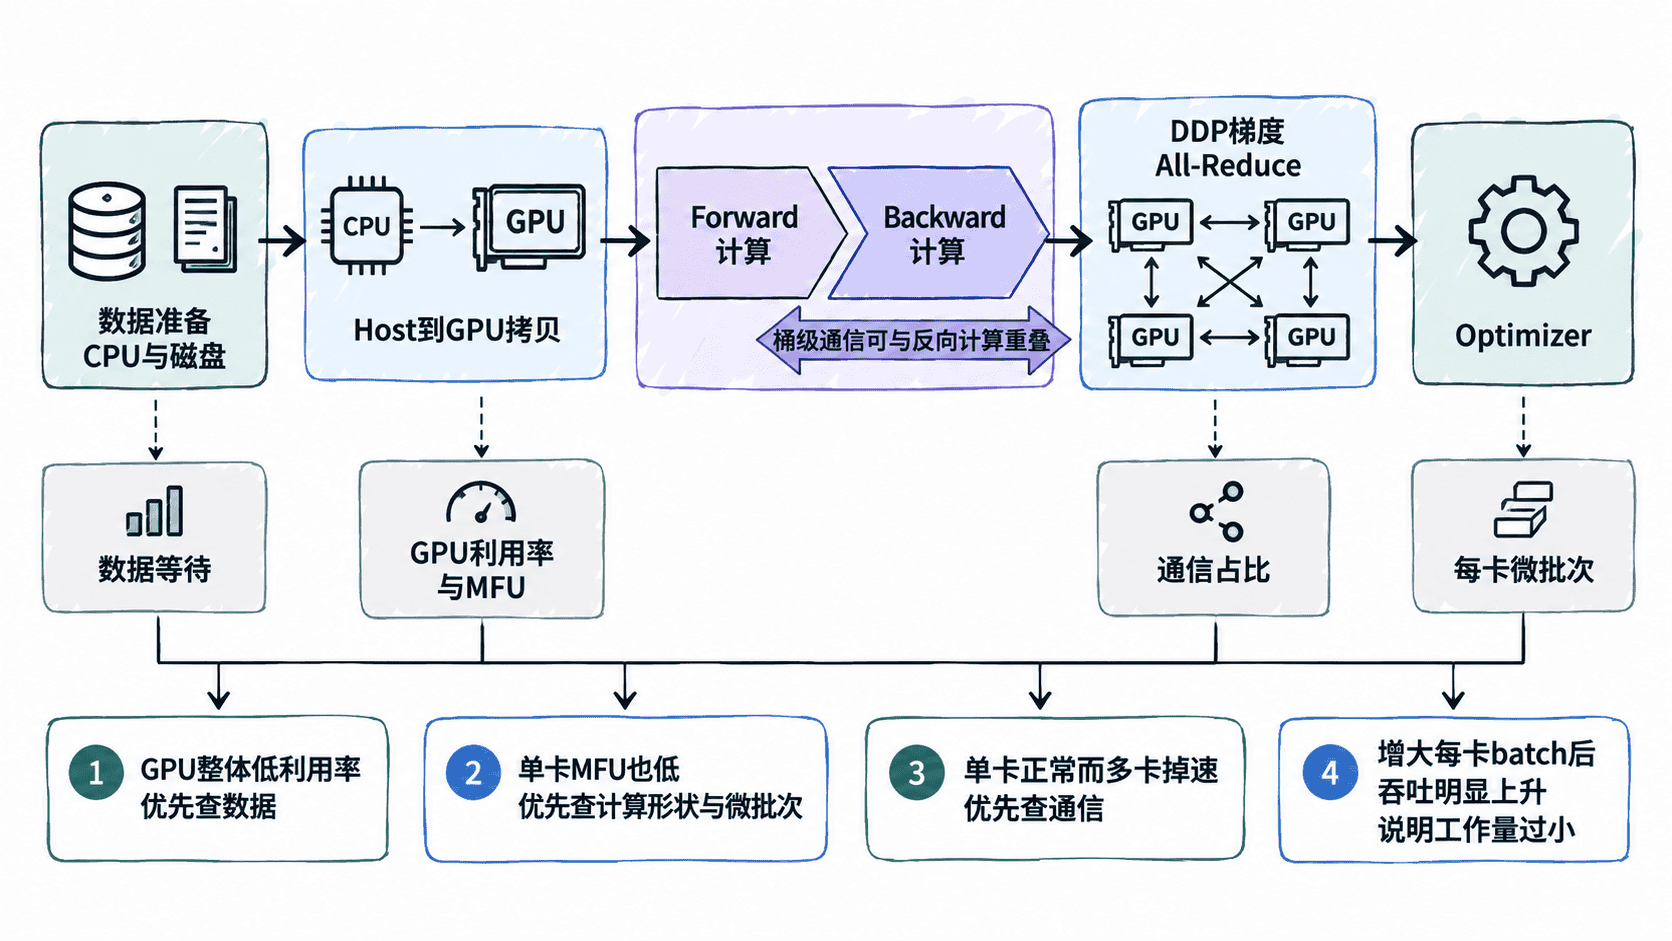
先观察所有 GPU 是否持续有活。下面的命令每秒打印一次核心利用率、显存活动、显存占用与功耗;动态数值因 GPU 型号和训练阶段而异。
nvidia-smi --query-gpu=index,utilization.gpu,utilization.memory,memory.used,power.draw --format=csv -l 1预期输出
index, utilization.gpu [%], utilization.memory [%], memory.used [MiB], power.draw [W]
0, <GPU_UTIL> %, <MEM_UTIL> %, <MEMORY> MiB, <POWER> W
1, <GPU_UTIL> %, <MEM_UTIL> %, <MEMORY> MiB, <POWER> W
...
如果所有 GPU 周期性一起掉到低利用率,同时 CPU、磁盘或数据解码很忙,优先查 get_batch、内存映射、随机采样和 Host-to-Device 拷贝。数据应尽量提前准备成二进制 Token,避免训练步里反复做文本解析或 Tokenize;能使用 pinned memory 与异步拷贝时,也不要让主线程同步等待。
如果单卡本身 MFU 就很低,多卡只会放大问题。常见原因是每卡 batch_size 太小、序列太短、模型太小,导致大量小 Kernel 和调度开销占比过高。梯度累积只能减少优化器更新频率,不能把一个过小的微批次变成更饱和的矩阵乘,因此应先在显存允许范围内增大每卡微批次。
判断是不是梯度同步拖慢
单卡利用率高,而增加 GPU 后每步出现规律性的空洞,才更像通信瓶颈。PyTorch DDP 会在反向传播过程中按 Bucket 发起梯度 All-Reduce;当互联带宽不足、Bucket 太碎或每卡计算量太少时,通信无法被反向计算覆盖,最终暴露在关键路径上。
此时重点核对 GPU 拓扑和进程绑定,确认同机 GPU 是否走预期的 NVLink、PCIe 路径,以及 NCCL 是否退化到较慢链路。可短时启用 NCCL_DEBUG=INFO 检查通信初始化,但不要用详细调试日志做正式吞吐基准,因为日志本身会扰动时间。
可以用现象快速分类:
| 现象 | 更可能的瓶颈 | 优先动作 |
|---|---|---|
| 单卡与多卡 GPU 利用率都低 | 数据或每卡计算量不足 | 先查取数等待,再增大微批次 |
| 单卡 MFU 高,多卡 MFU 明显下降 | 梯度同步 | 查拓扑、NCCL 路径与通信覆盖 |
增大每卡 batch_size 后扩展效率明显改善 |
每卡工作量过小 | 保持更大的局部微批次重新基准 |
| 多卡只在固定全局批次下变差 | 强扩展已接近通信极限 | 对比固定每卡工作量的第二组实验 |
用最小对照实验下结论
最终至少做两组对照。第一组保持全局每步 Token 数一致,回答“同一训练工作量能否被更多 GPU 更快完成”;第二组保持每卡微批次和每卡累积工作量接近一致,回答“新增 GPU 是否真的带来更多总吞吐”。如果第二组能接近线性增长而第一组不能,硬件与 DDP 通常没有故障,只是固定工作量被切得太碎;如果第二组仍明显掉速,再把证据集中到数据等待或通信链路,而不是盲目调整学习率、优化器等与吞吐无关的参数。