
大模型原理与训练 / 系统课时
放对 LayerNorm 的位置
放对 LayerNorm 的位置
这一节实现 GPT 常用的 Pre-Norm Transformer Block:先对残差分支输入做 LayerNorm,再进入注意力或 MLP。你会同时验证归一化发生在隐藏维度,而不是 batch 或序列维度,并理解归一化位置为什么会影响深层训练。
学习目标
- 正确使用
LayerNorm(n_embd)归一化每个 token 的隐藏向量 - 实现先归一化、再计算子层、最后残差相加的 Pre-Norm Block
- 区分 Pre-Norm 与 Post-Norm 的数据路径和训练特性
LayerNorm 到底归一化哪一维
GPT 中常见隐藏状态形状为 [B, T, C],分别表示批量大小、序列长度和隐藏维度。写下 nn.LayerNorm(C) 时,PyTorch 默认只归一化最后一个维度,因此每个 token 都独立计算自己 C 个特征的均值和方差。
这意味着第一个样本不会与第二个样本混合,位置 0 也不会与位置 1 混合。LayerNorm 调整的是“一个 token 内部各特征的尺度”,所以它天然适合长度变化、batch 大小变化的语言模型。
对单个 token 的隐藏向量,可以把核心计算理解为先减去该向量的均值,再除以标准差,最后应用可学习的缩放和偏移参数。PyTorch 还会加入很小的 eps,避免方差接近零时发生数值问题。
Pre-Norm 把归一化放在子层之前
Pre-Norm Block 的两条主路径可以写成 x = x + Attention(LN(x)) 和 x = x + MLP(LN(x))。LayerNorm 只位于需要计算新增量的分支上,恒等残差路径仍然直接携带原始 x。
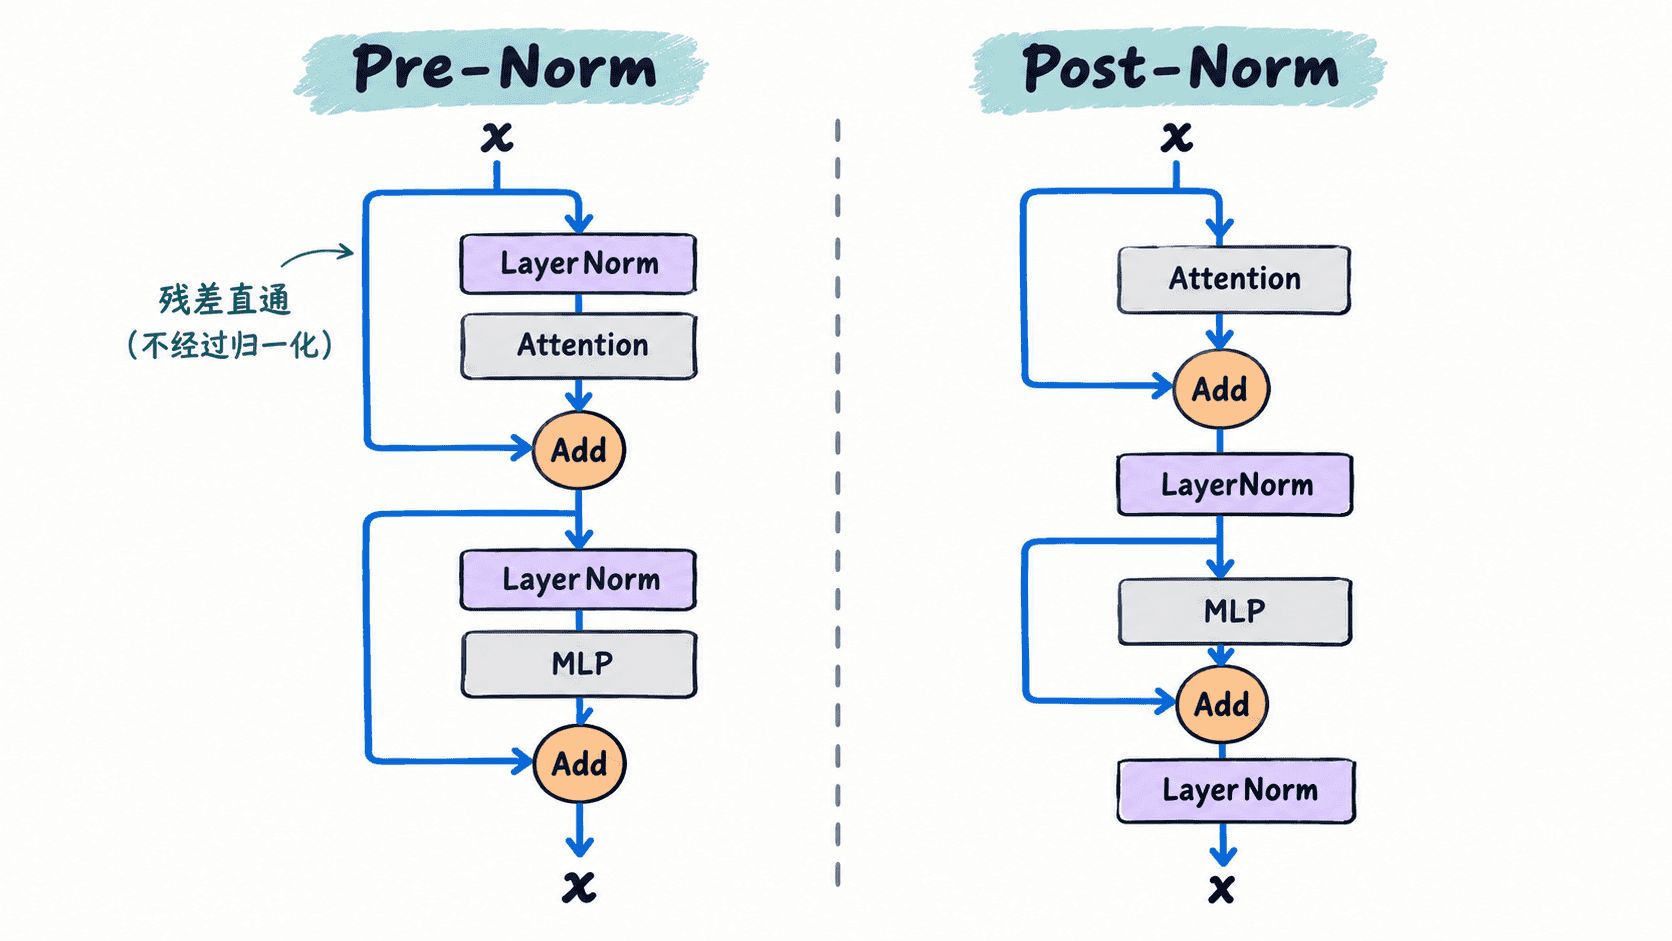
这种布局让跨 Block 的主残差路径保持得更直接。对于较深的 Transformer,Pre-Norm 通常更容易优化,因此 GPT 系模型广泛采用这种组织方式。不过这不是“Pre-Norm 在所有模型上都绝对更好”的结论;初始化、学习率、深度和其他稳定化技术也会影响最终训练行为。
实现并验证 Pre-Norm Block
下面的代码同时验证两个问题:LayerNorm(4) 是否逐 token 归一化最后一维,以及完整 Block 是否保持 [B, T, C] 的张量形状。
import torch
from torch import nn

class PreNormBlock(nn.Module):
    def __init__(self, n_embd: int, n_head: int):
        super().__init__()
        self.ln1 = nn.LayerNorm(n_embd)
        self.attn = nn.MultiheadAttention(
            embed_dim=n_embd,
            num_heads=n_head,
            batch_first=True,
        )
        self.ln2 = nn.LayerNorm(n_embd)
        self.mlp = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.GELU(),
            nn.Linear(4 * n_embd, n_embd),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # Pre-Norm:先规范化计算分支,残差支路仍直接保留 x。
        h = self.ln1(x)
        attn_out, _ = self.attn(h, h, h, need_weights=False)
        x = x + attn_out

        # 第二个子层重复同样的“LN -> 子层 -> 残差相加”顺序。
        x = x + self.mlp(self.ln2(x))
        return x

x = torch.tensor([
    [[1.0, 2.0, 3.0, 4.0], [10.0, 20.0, 30.0, 40.0]]
])

ln = nn.LayerNorm(4)
z = ln(x)
expected_means = torch.zeros_like(z.mean(dim=-1))
expected_vars = torch.ones_like(z.var(dim=-1, unbiased=False))

print("normalized shape:", tuple(z.shape))
print("token means near zero:", bool(torch.allclose(
    z.mean(dim=-1), expected_means, atol=1e-5
)))
print("token variances near one:", bool(torch.allclose(
    z.var(dim=-1, unbiased=False), expected_vars, atol=1e-4
)))

block = PreNormBlock(n_embd=4, n_head=2)
y = block(x)
print("block shape:", tuple(y.shape))
预期输出
normalized shape: (1, 2, 4)
token means near zero: True
token variances near one: True
block shape: (1, 2, 4)
这里检查的是最后一个维度。两个 token 的原始数值尺度相差很大,但各自经过 LayerNorm 后,都独立获得接近 0 的均值和接近 1 的方差;序列中的两个位置并没有被混在一起统计。
最容易放错的三个位置
第一种错误是把 LayerNorm 理解成对整个 [B, T, C] 张量统一标准化。nn.LayerNorm(n_embd) 的 normalized_shape 对应末尾隐藏维度,因此不需要根据 batch 大小或序列长度重新创建归一化层。
第二种错误是口头上说使用 Pre-Norm,代码却写成 x = ln(x + sublayer(x))。这已经改变为 Post-Norm 数据路径。两种结构都真实存在,但在复现 nanoGPT 或其他指定架构时,位置必须严格匹配模型定义。
第三种错误是只在整个网络入口做一次 LayerNorm,然后让所有 Block 共用这个结果。每个 Block 的输入分布都会随前面层的更新而变化,所以两个子层各自需要对应的 LayerNorm。GPT 通常还会在所有 Block 之后、语言模型输出头之前再放一个最终 LayerNorm。
把 LayerNorm 放到正确位置后,Block 就形成了稳定而清晰的结构:归一化后的分支负责计算新信息,未归一化的残差主路负责跨层保留表示。后续继续堆叠 Block 时,每一层都能遵循同一接口而不改变 [B, T, C] 的外部形状。