
大模型原理与训练 / 系统课时
用梯度裁剪压住异常更新
用梯度裁剪压住异常更新
一次异常 batch 就可能产生远大于平时的梯度,使参数跨出稳定区域,随后出现 loss 尖峰甚至 NaN。本节用全局梯度范数监控异常更新,并把 Gradient Clipping 放到正确的反向传播与 optimizer 更新位置。
学习目标
- 理解全局梯度范数和梯度裁剪实际改变了什么
- 使用
clip_grad_norm_在参数更新前限制异常梯度 - 在梯度累积和混合精度训练中安排正确的裁剪顺序
裁剪的是更新幅度而不是单个异常值
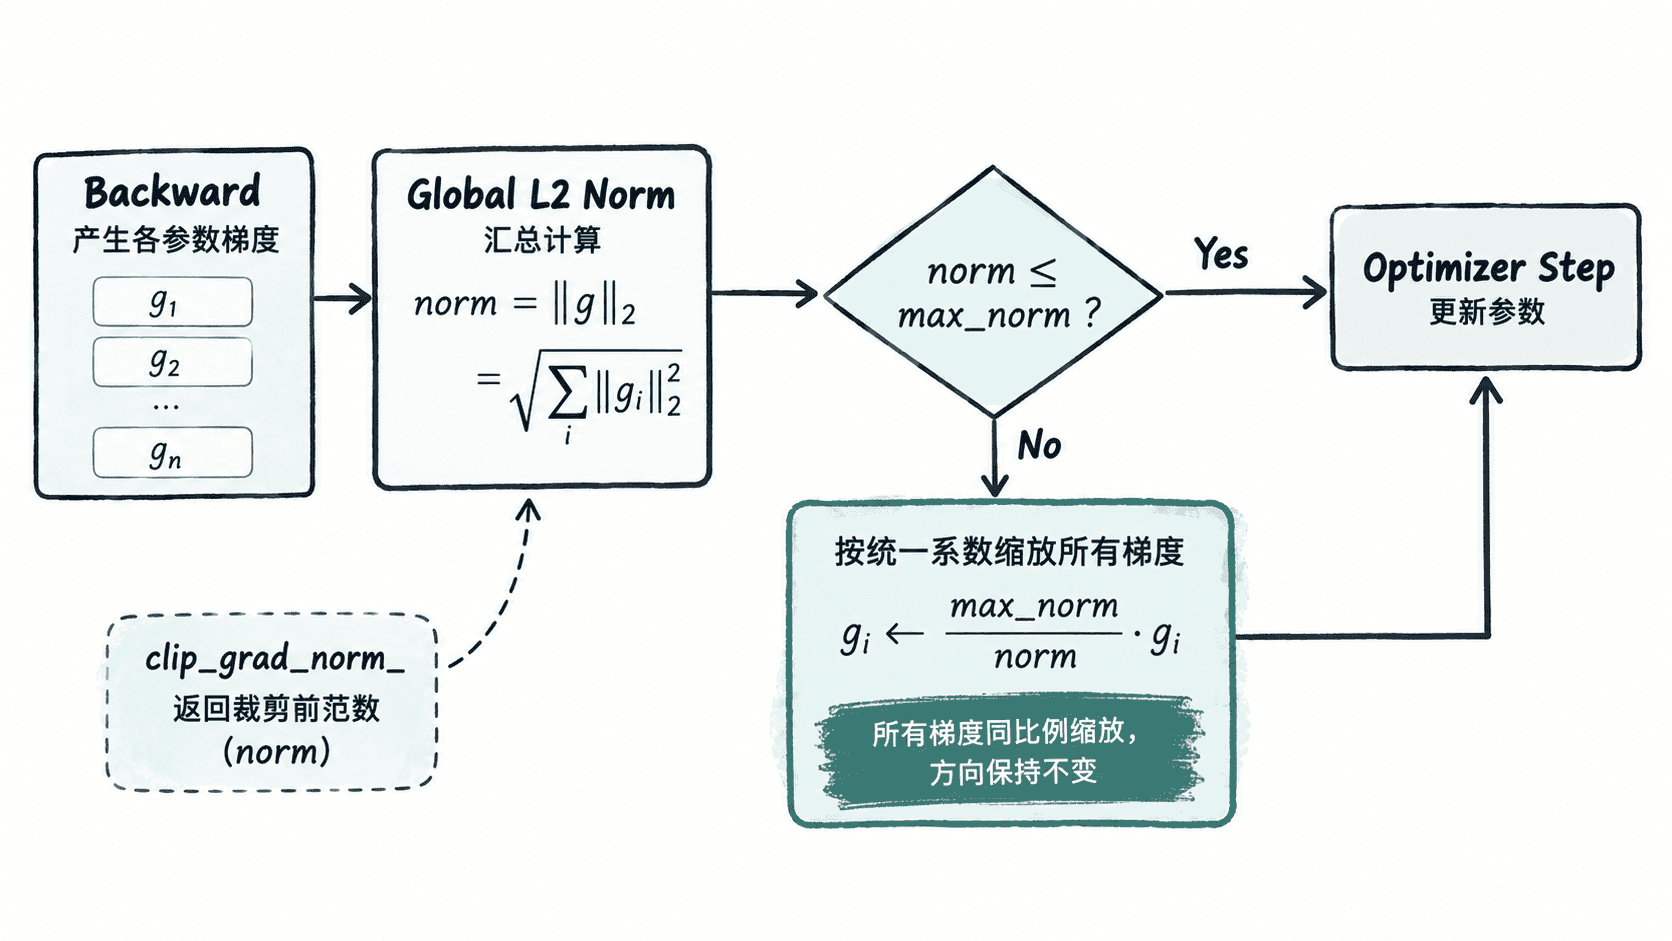
常见的 norm clipping 会把所有待更新参数的梯度视为一个整体,计算全局 L2 范数。若范数没有超过阈值,梯度保持不变;若超过 max_norm,所有梯度按同一比例缩小,使新的全局范数接近阈值。
因此,裁剪不会把某个元素粗暴改成固定上下限,也不会改变梯度整体方向。它相当于给一次参数更新设置最大幅度保险丝:普通更新不受影响,只有异常大的更新会被统一缩小。
用可重复示例观察裁剪效果
下面故意构造梯度为 [6000, 8000] 的参数,其 L2 范数正好是 10000。把阈值设为 1.0 后,两个分量会按同一比例缩成约 [0.6, 0.8],再由 SGD 完成参数更新。
import torch
from torch.nn.utils import clip_grad_norm_


torch.manual_seed(0)
w = torch.nn.Parameter(torch.tensor([3.0, 4.0]))
optimizer = torch.optim.SGD([w], lr=0.1)

# loss 的系数被故意放大,用于稳定复现一次异常大的梯度。
loss = 1000.0 * w.square().sum()
optimizer.zero_grad(set_to_none=True)
loss.backward()

before_norm = clip_grad_norm_([w], max_norm=1.0)
after_norm = w.grad.norm(2).item()
optimizer.step()

print(f"before_norm={before_norm.item():.4f}")
print(f"after_norm={after_norm:.4f}")
print("w=", [round(float(x), 2) for x in w.detach()])
预期输出:
before_norm=10000.0000
after_norm=1.0000
w= [2.94, 3.92]
clip_grad_norm_ 的返回值是裁剪前的总梯度范数,因此非常适合直接写入训练日志。示例中参数仍然沿原梯度方向移动,但单步变化被限制在可控范围内。
放到训练循环的正确位置
裁剪必须发生在 backward() 之后、optimizer.step() 之前。使用梯度累积时,应先完成本次 optimizer update 对应的全部 micro-batch 反向传播,再裁剪一次;如果每个 micro-batch 都提前裁剪,最终累积得到的梯度就不再等价。
混合精度还多一个容易遗漏的顺序要求:GradScaler 会暂时把梯度放大,因此需要先调用 unscale_() 恢复真实尺度,再计算范数和执行裁剪。
片段示例:下面假定 model、optimizer、scaler 已创建,并且当前一次参数更新所需的所有 micro-batch 已经执行完 scaler.scale(loss).backward()。
# 必须先恢复真实梯度尺度,否则阈值比较没有意义。
scaler.unscale_(optimizer)
grad_norm = torch.nn.utils.clip_grad_norm_(
    model.parameters(),
    max_norm=1.0,
)

scaler.step(optimizer)
scaler.update()
optimizer.zero_grad(set_to_none=True)
验证时记录 grad_norm 即可得到裁剪前范数。如果不使用 GradScaler,直接在普通 loss.backward() 之后调用 clip_grad_norm_,不需要 unscale_()。
用日志判断阈值是否合理
max_norm=1.0 是常见起点,但不是所有模型都必须使用同一个数字。阈值是否合适,要看未裁剪梯度范数的长期分布,而不是只看某一次峰值。
阈值过低时,大多数更新都会触发裁剪,等于长期人为缩小有效步长;训练可能非常平稳,却明显变慢。阈值过高时,日志中虽然几乎从不裁剪,但真正危险的异常梯度仍可能直接进入 optimizer。
可以同时记录裁剪前 grad_norm、loss 和是否超过阈值。如果 loss 尖峰总与巨大梯度范数同步,而加入裁剪后训练能够继续,说明它确实挡住了异常更新;如果梯度范数长期异常,则应继续检查学习率、数据、loss 计算和混合精度缩放,而不是不断降低裁剪阈值掩盖根因。
梯度裁剪最适合充当最后一道稳定性保护:正常梯度原样通过,少数异常更新被限制。把它与梯度范数日志一起使用,才能既压住偶发尖峰,又保留发现训练配置错误的证据。