
大模型原理与训练 / 系统课时
接上词表投影与语言模型损失
接上词表投影与语言模型损失
前面的 Transformer 块只产出每个位置的隐藏向量,还不能直接表示下一个 Token 是谁。这一节补上最终归一化、词表投影和交叉熵损失,把形状为 (B, T, C) 的隐藏状态变成 (B, T, V) 的 logits,并得到可反向传播的标量损失。
学习目标
- 说明最终 LayerNorm、LM Head 与词表维度之间的关系。
- 正确把
(B, T, V)logits 与(B, T)标签交给交叉熵。 - 区分训练时的损失计算与生成时的下一 Token 选择。
从隐藏状态得到词表 logits
设批大小为 B、序列长度为 T、隐藏维度为 C、词表大小为 V。Transformer 主干输出 h 的形状是 (B, T, C)。先经过最终 LayerNorm,再用一个 C -> V 的线性层投影,每个位置便得到对整个词表的未归一化分数。
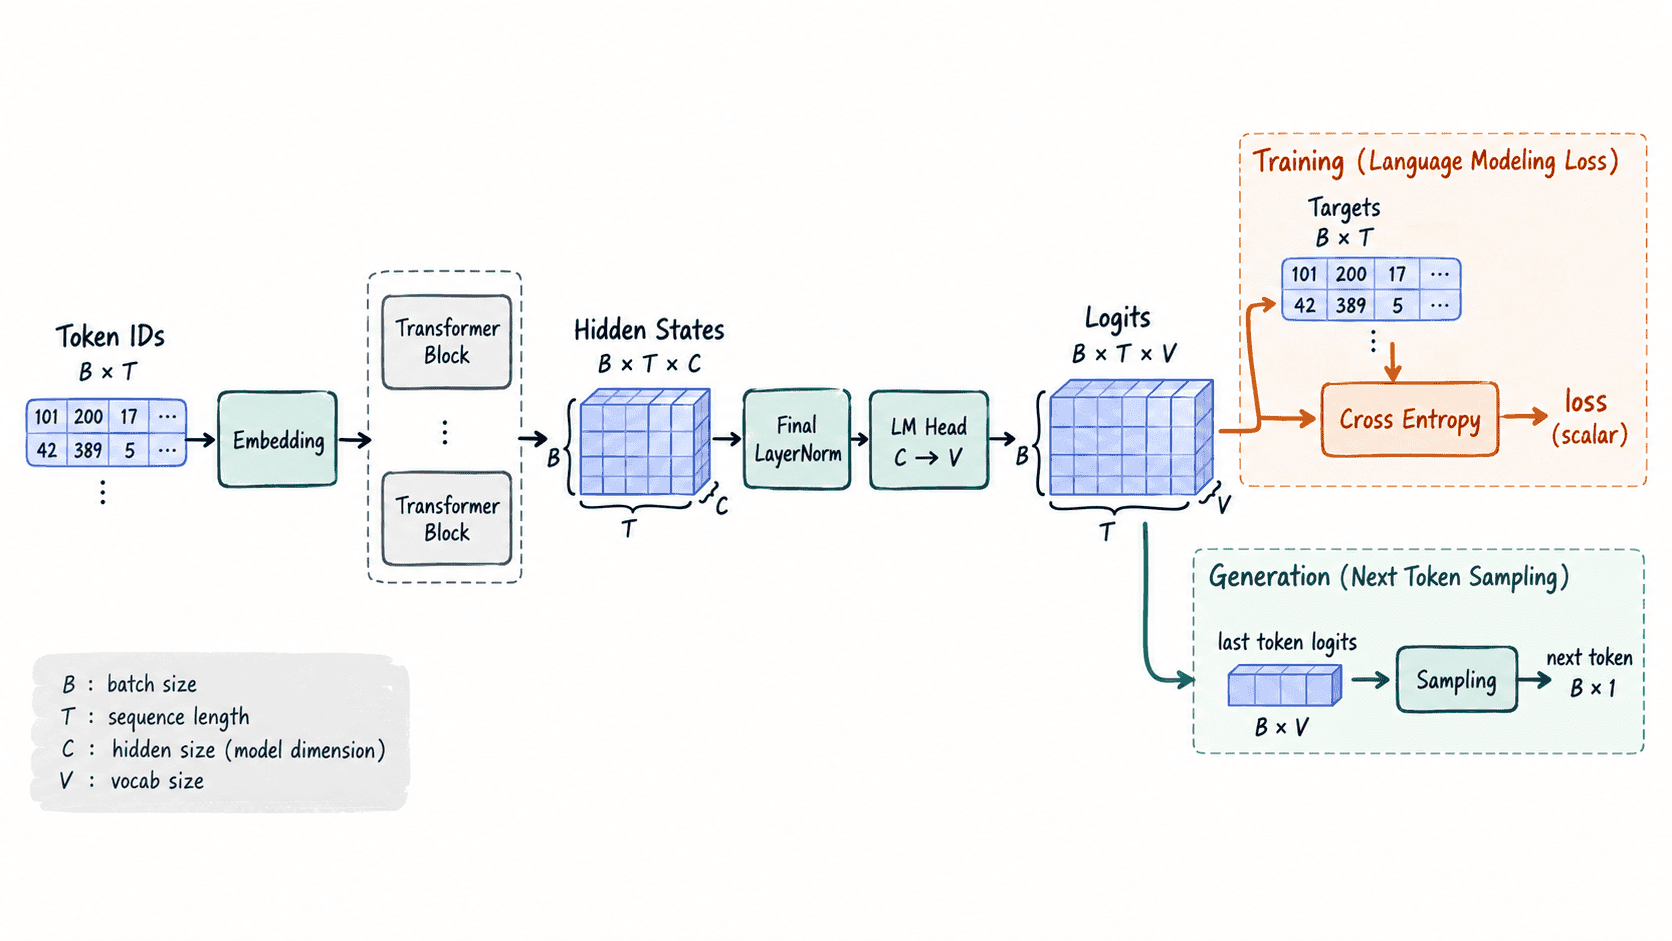
LM Head 通常不带 bias。nanoGPT 还常把 Token Embedding 与 LM Head 的权重绑定,让输入词向量矩阵与输出分类矩阵共享同一组参数。这样既减少参数量,也让输入和输出使用同一个词语表示空间。若采用权重绑定,后续配置优化器时还要确保共享参数不会被重复加入参数组。
用交叉熵连接训练目标
自回归训练的标签是当前位置之后的那个 Token。数据批通常已经把输入和目标错开一位,例如原序列 [t0, t1, t2, t3] 会形成输入 [t0, t1, t2] 和目标 [t1, t2, t3]。因果注意力负责阻止当前位置看到未来,LM Head 本身只负责逐位置分类。
PyTorch 的 cross_entropy 可以把所有位置看成独立的词表分类任务。常见做法是把 logits 从 (B, T, V) 展成 (B*T, V),再把 targets 从 (B, T) 展成 (B*T)。不要先手动做 softmax;交叉熵内部会以数值稳定的方式完成对应计算。
下面的最小示例独立演示最终归一化、词表投影与损失计算。
import torch
import torch.nn as nn
import torch.nn.functional as F

class GPTOutputHead(nn.Module):
    def __init__(self, n_embd: int, vocab_size: int):
        super().__init__()
        self.ln_f = nn.LayerNorm(n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size, bias=False)

    def forward(self, hidden, targets=None):
        hidden = self.ln_f(hidden)
        logits = self.lm_head(hidden)

        loss = None
        if targets is not None:
            # 每个时间步都是一次 V 类分类,展平后一次计算交叉熵。
            b, t, v = logits.shape
            loss = F.cross_entropy(
                logits.reshape(b * t, v),
                targets.reshape(b * t),
            )
        return logits, loss

torch.manual_seed(7)
head = GPTOutputHead(n_embd=16, vocab_size=32)
hidden = torch.randn(2, 4, 16)
targets = torch.randint(0, 32, (2, 4))

logits, loss = head(hidden, targets)
print('logits_shape', tuple(logits.shape))
print('targets_shape', tuple(targets.shape))
print('loss_is_finite', bool(torch.isfinite(loss)))
预期输出
logits_shape (2, 4, 32)
targets_shape (2, 4)
loss_is_finite True
损失的具体数值会随参数初始化和运行环境变化,因此验证重点是输出形状正确,并且 loss 是有限标量。
训练与生成走不同分支
训练时需要所有时间步的 logits,因为每个位置都对应一个监督目标;一次前向可以累计 B*T 个分类项。生成时只关心序列最后一个位置对下一个 Token 的预测,因此通常读取 logits[:, -1, :],再配合 temperature、top-k 或其他采样策略选择新 Token。
另一个常见错误是 targets 超出 [0, V-1]。如果训练数据使用特殊忽略标记,例如 -1,必须显式给 cross_entropy 配置匹配的 ignore_index,否则会出现类别索引越界。
检查完整前向路径
把输出层接到 GPT 主干后,至少检查三件事:主干输出最后一维等于 n_embd,LM Head 输出最后一维等于 vocab_size,targets 与 logits 的前两维完全一致。满足这些条件后,标量 loss 就能沿 LM Head、最终 LayerNorm 和全部 Transformer Block 反向传播到 Embedding,完整的语言模型训练路径才真正闭合。