
大模型原理与训练 / 系统课时
用加权聚合读取历史上下文
用加权聚合读取历史上下文
这一节只解决一个问题:序列中第 个位置怎样在不偷看未来的前提下,把自己和历史位置的信息汇成一个上下文向量。我们先用固定均值建立可运行基线,再把循环写法改成一次矩阵乘法,为后续内容相关的注意力权重做好准备。
学习目标
- 解释因果聚合为什么只能读取当前位置及其左侧历史。
- 用下三角权重矩阵和矩阵乘法实现历史均值聚合。
- 说明固定平均与真正自注意力之间还缺少什么。
从当前位置读取历史
设序列表示为 ,其中 是序列长度, 是每个 token 的通道数。最简单的上下文读取方式,是让位置 对 到 的向量取平均:
这个规则已经具有因果性:位置 能看到自己和过去,却不能访问 之后的未来。它还没有“注意”哪些历史更重要,只是给所有可见位置相同权重。
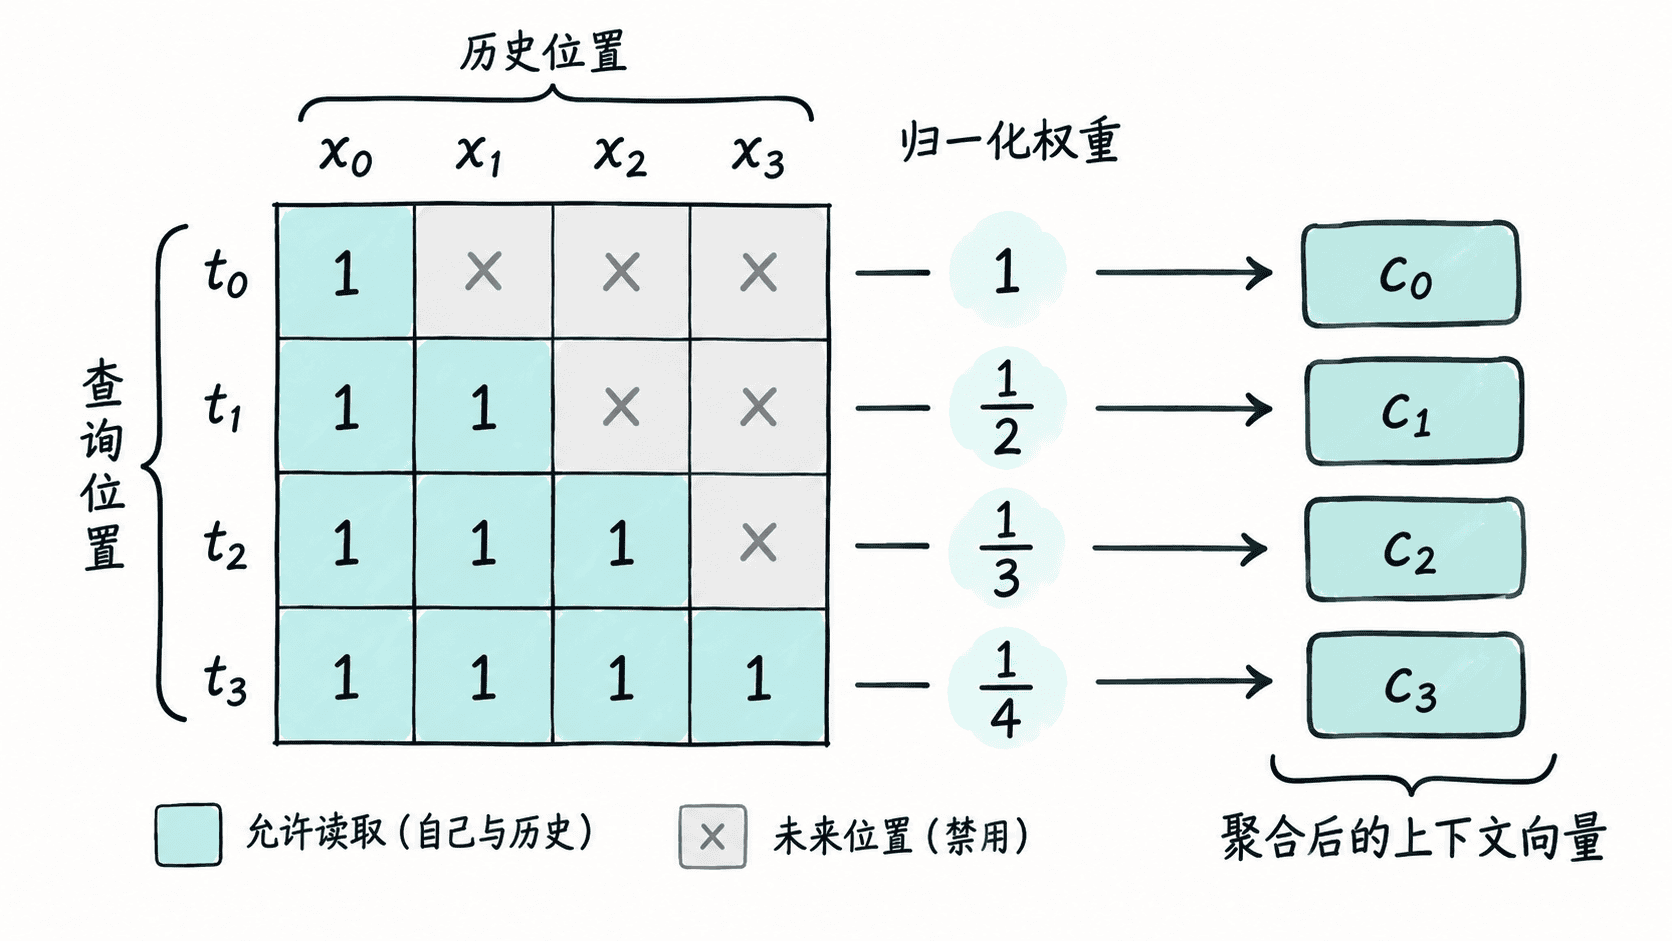
用矩阵乘法完成均值聚合
循环可以直接表达定义,但训练时我们更希望一次处理整段序列。构造一个下三角矩阵,再把每一行归一化,使每行权重和为 1,最后执行 wei @ x 即可同时得到所有位置的历史均值。
python
import torch

torch.set_printoptions(precision=4, sci_mode=False)

x = torch.tensor([
    [1.0, 0.0],
    [0.0, 2.0],
    [3.0, 1.0],
    [2.0, 4.0],
])

# 下三角决定“能看谁”,逐行归一化决定各历史位置的固定平均权重。
wei = torch.tril(torch.ones(4, 4))
wei = wei / wei.sum(dim=1, keepdim=True)
context = wei @ x

print(wei)
print(context)
预期输出
text
tensor([[1.0000, 0.0000, 0.0000, 0.0000],
        [0.5000, 0.5000, 0.0000, 0.0000],
        [0.3333, 0.3333, 0.3333, 0.0000],
        [0.2500, 0.2500, 0.2500, 0.2500]])
tensor([[1.0000, 0.0000],
        [0.5000, 1.0000],
        [1.3333, 1.0000],
        [1.5000, 1.7500]])
矩阵乘法的第 行只会混合 到 。例如最后一行四个权重都是 ,所以输出正好是四个输入向量的平均值。这里没有循环依赖,GPU 可以并行计算整张权重矩阵与全部通道。
固定平均为什么还不够
均值聚合的问题不是“看不到历史”,而是不会根据内容改变读取比例。无论当前 token 是什么,它对同一段历史都使用固定的 权重;真正的自注意力则会先比较当前位置与各历史位置的内容相关性,再得到不同权重。
后续注意力会替换“固定权重如何产生”这一部分,但 权重矩阵 @ Value 的聚合形式仍然保留。因果下三角约束也不会消失:模型可以学习更聪明地分配历史权重,却仍不能把未来 token 泄漏给当前位置。
按自己的节奏,确认真正理解。