
大模型原理与训练 / 系统课时
保存检查点并从中断位置恢复
保存检查点并从中断位置恢复
本节把“训练能跑”推进到“训练能续”。你会把模型参数、优化器状态、迭代步和关键配置一起写入检查点,在进程退出后恢复到一致状态,并建立一套判断恢复参数是否安全的最小规则。
学习目标
- 能保存并恢复模型、优化器、迭代步和关键训练配置
- 能让恢复后的训练从正确迭代位置继续,而不是重新开始
- 能识别模型结构、优化器和训练参数不一致带来的恢复风险
检查点保存的不是只有模型权重
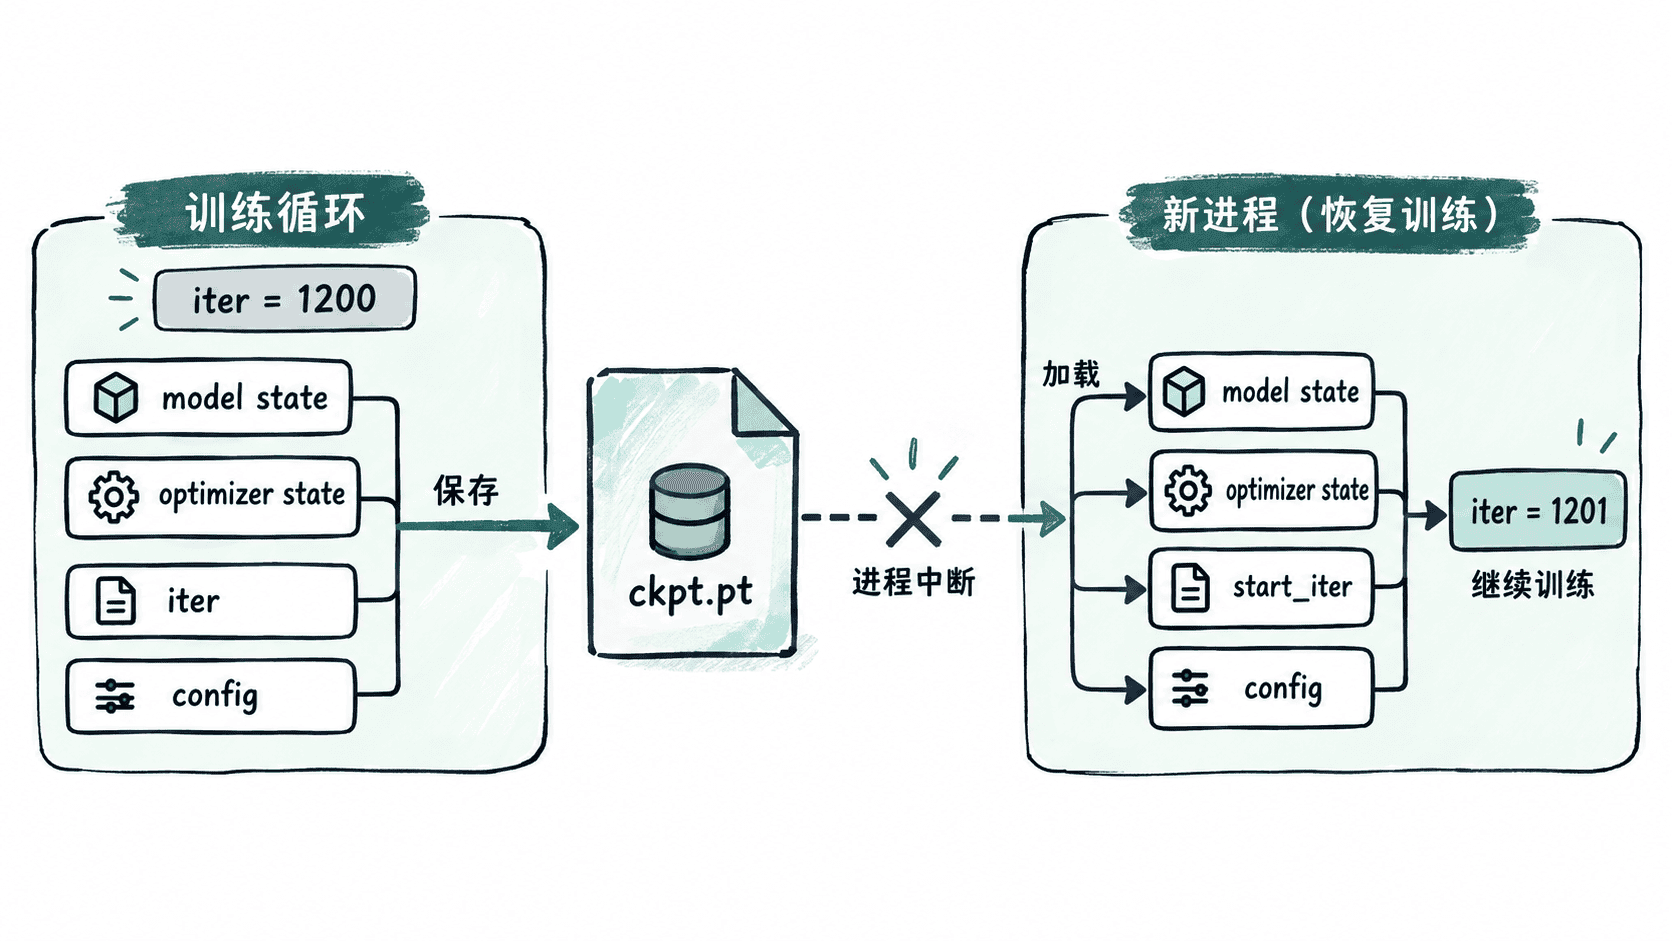
只保存 model.state_dict() 适合推理,却不足以继续训练。优化器通常还保存动量、一阶或二阶矩等历史状态;如果这些状态丢失,即使模型权重相同,恢复后的更新轨迹也会突然变化。迭代步同样重要,因为学习率调度、日志频率和评估频率常依赖它。
一个可恢复的检查点至少应包含模型状态、优化器状态、当前迭代步和影响模型结构或训练语义的关键配置。随机数状态、梯度缩放器状态和数据迭代位置是否需要保存,则取决于你是否要求严格复现到“下一批数据也一致”。
用一个完整脚本保存并恢复
下面的脚本用一个小型 PyTorch 模型演示与 nanoGPT 相同的恢复要点。真实 GPT 训练时只需要把这里的 TinyModel 换成你的 GPT 模型,保存字段和恢复顺序保持一致。
from pathlib import Path

import torch
from torch import nn

class TinyModel(nn.Module):
    def __init__(self, width: int) -> None:
        super().__init__()
        self.proj = nn.Linear(width, width)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.proj(x)

def save_checkpoint(path: Path, model, optimizer, iter_num: int, config: dict) -> None:
    path.parent.mkdir(parents=True, exist_ok=True)
    tmp_path = path.with_suffix(".tmp")
    payload = {
        "model": model.state_dict(),
        "optimizer": optimizer.state_dict(),
        "iter_num": iter_num,
        "config": config,
    }
    # 先写临时文件,再原子替换,避免进程中断留下半个检查点。
    torch.save(payload, tmp_path)
    tmp_path.replace(path)

def load_checkpoint(path: Path, model, optimizer) -> tuple[int, dict]:
    checkpoint = torch.load(path, map_location="cpu")
    model.load_state_dict(checkpoint["model"])
    optimizer.load_state_dict(checkpoint["optimizer"])
    # 保存的是已完成的迭代,因此下一步从 +1 开始。
    return checkpoint["iter_num"] + 1, checkpoint["config"]

config = {"n_embd": 8, "learning_rate": 1e-3}
model = TinyModel(config["n_embd"])
optimizer = torch.optim.AdamW(model.parameters(), lr=config["learning_rate"])

# 先执行一步训练,确保 AdamW 已产生需要恢复的历史状态。
x = torch.ones(2, config["n_embd"])
loss = model(x).square().mean()
loss.backward()
optimizer.step()

ckpt_path = Path("out/ckpt.pt")
save_checkpoint(ckpt_path, model, optimizer, iter_num=1200, config=config)

# 用全新的模型和优化器模拟进程重启。
restored_model = TinyModel(config["n_embd"])
restored_optimizer = torch.optim.AdamW(restored_model.parameters(), lr=9e-4)
start_iter, saved_config = load_checkpoint(
    ckpt_path, restored_model, restored_optimizer
)

print(f"start_iter={start_iter}")
print(f"saved_n_embd={saved_config['n_embd']}")
print(f"restored_lr={restored_optimizer.param_groups[0]['lr']}")
预期输出
start_iter=1201
saved_n_embd=8
restored_lr=0.001
输出里的学习率说明优化器状态也被恢复了:新建优化器时临时传入的 9e-4 被检查点中的参数组配置覆盖。真实运行中的检查点路径、设备和迭代步会不同,但恢复语义应保持一致。
恢复顺序决定是否真的“接着训”
恢复训练时,先创建与检查点兼容的模型,再加载模型权重,然后恢复优化器状态,最后设置起始迭代步。若学习率调度器按 iter_num 计算学习率,也应使用恢复后的迭代步,而不是从 0 重新计数。
如果检查点记录的是“刚完成的迭代号”,下一次通常从 iter_num + 1 开始;如果你的训练循环保存的是“下一次将执行的迭代号”,就不要再加 1。两种设计都可以,关键是保存端和恢复端必须使用同一约定,否则会出现重复一步或跳过一步的隐蔽错误。
哪些参数不能随意改
恢复时最危险的是模型结构不一致,例如 n_layer、n_head、n_embd 或词表大小发生变化。此时 load_state_dict 通常会因参数形状不匹配而报错;即使强行忽略缺失键,也已经不再是严格意义上的原训练续跑。
优化器类型和参数分组也应保持兼容。把 AdamW 换成 SGD,或改变哪些参数参与 weight decay,都会让旧优化器状态失去原有含义。相比之下,日志目录、评估间隔这类运行参数通常可以调整;学习率是否允许调整,则应由项目显式规定,而不是悄悄覆盖。
一个稳妥策略是把配置分成两类:模型结构和训练语义类参数默认从检查点读取并锁定;设备、日志频率等运行参数允许启动时覆盖。这样既能恢复训练,又不会把一次实验悄悄变成另一套实验。
验证恢复是否可信
恢复成功不等于恢复正确。至少检查三件事:日志中的起始迭代是否连续;恢复后首个学习率是否与中断前调度一致;保存前后用同一输入做前向计算时,模型输出是否一致。若还要求严格复现,则继续保存并恢复随机数状态、AMP GradScaler 状态以及数据采样器位置。
真正可靠的检查点机制有一个简单标准:中断只改变训练发生的时间,不应在你没有明确允许的情况下改变模型结构、优化器历史和训练进度。