
大模型原理与训练 / 系统课时
分离训练集与验证集损失
分离训练集与验证集损失
单看训练批次的 loss,只能说明模型正在拟合刚采到的数据,无法判断泛化是否同步改善。本节把训练与验证损失分开估计,并用稳定的评估批次识别欠拟合、过拟合和随机采样造成的假波动。
学习目标
- 实现不会污染训练随机序列的周期性
estimate_loss - 根据训练集与验证集 loss 的相对走势判断模型状态
- 通过固定评估采样和增加评估批次数降低噪声
先定义可信的评估方式
训练循环里的单个 loss 波动很大,因为它只来自当前 mini-batch。可靠的比较至少要满足三个条件:训练集与验证集物理分离;评估时不执行反向传播;每次记录的是多个批次的平均值,而不是某一个批次的偶然结果。
验证集不能参与参数更新。对语言模型语料,通常先按连续位置切分,再分别在两段数据内采样上下文窗口,这样不会让同一段相邻 token 同时落入训练和验证样本。
model.eval() 与 torch.no_grad() 解决的是不同问题:前者切换 Dropout 等模块的行为,后者关闭梯度图记录。评估完成后必须恢复 model.train(),否则后续训练会继续处于推理模式。
实现周期性 loss estimation
下面的最小示例使用一个 bigram 语言模型模拟 nanoGPT 训练循环。训练批次和评估批次使用不同的随机生成器;estimate_loss() 每次都重新创建固定种子的评估生成器,因此评估频率不会改变后续训练采样顺序,同一步之间的比较也更稳定。
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(42)

vocab_size = 32
block_size = 8
batch_size = 16
eval_iters = 20

# 构造确定性 token 序列,并在采样前先切分训练集与验证集。
data = torch.arange(0, 800) % vocab_size
n = int(0.9 * len(data))
train_data, val_data = data[:n], data[n:]
train_gen = torch.Generator().manual_seed(1)

def get_batch(source, generator):
    ix = torch.randint(
        0, len(source) - block_size, (batch_size,), generator=generator
    )
    x = torch.stack([source[i:i + block_size] for i in ix])
    y = torch.stack([source[i + 1:i + block_size + 1] for i in ix])
    return x, y

class BigramLM(nn.Module):
    def __init__(self):
        super().__init__()
        self.token_embedding = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets=None):
        logits = self.token_embedding(idx)
        loss = None
        if targets is not None:
            b, t, c = logits.shape
            loss = F.cross_entropy(
                logits.view(b * t, c), targets.view(b * t)
            )
        return logits, loss

model = BigramLM()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-2)

@torch.no_grad()
def estimate_loss():
    result = {}
    model.eval()

    # 固定评估采样,让不同训练步之间的 loss 更可比。
    for split, source, seed in (
        ("train", train_data, 2),
        ("val", val_data, 3),
    ):
        eval_gen = torch.Generator().manual_seed(seed)
        losses = torch.empty(eval_iters)
        for k in range(eval_iters):
            xb, yb = get_batch(source, eval_gen)
            _, loss = model(xb, yb)
            losses[k] = loss.item()
        result[split] = losses.mean().item()

    model.train()
    return result

for step in range(201):
    if step % 50 == 0:
        losses = estimate_loss()
        print(
            f"step {step:3d} | train {losses['train']:.3f} "
            f"| val {losses['val']:.3f}"
        )

    xb, yb = get_batch(train_data, train_gen)
    _, loss = model(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
预期输出(同一 PyTorch/CPU 环境下应接近以下结果,不同版本末位可能略有差异):
step   0 | train 3.784 | val 3.764
step  50 | train 2.905 | val 2.887
step 100 | train 2.109 | val 2.092
step 150 | train 1.453 | val 1.438
step 200 | train 0.968 | val 0.957
这个例子中两条曲线同步下降,说明模型仍在学习,而且验证数据上的改进没有明显落后于训练数据。
读懂两条 loss 曲线
判断模型状态时不要只看某一个数值,而要观察一段训练区间内两条曲线的方向和间距。
| 现象 | 更可能的解释 | 下一步 |
|---|---|---|
| train 与 val 都高且持续下降 | 欠拟合或训练尚未充分 | 继续训练,确认学习率与模型容量 |
| train 持续下降,val 先降后升 | 过拟合 | 采用更早 checkpoint,增加正则化或数据 |
| 两条曲线都明显抖动但无稳定趋势 | 评估噪声过大 | 增加 eval_iters 或固定评估样本 |
| train 很低而 val 长期明显更高 | 泛化差或数据分布不一致 | 检查切分策略与训练数据覆盖 |
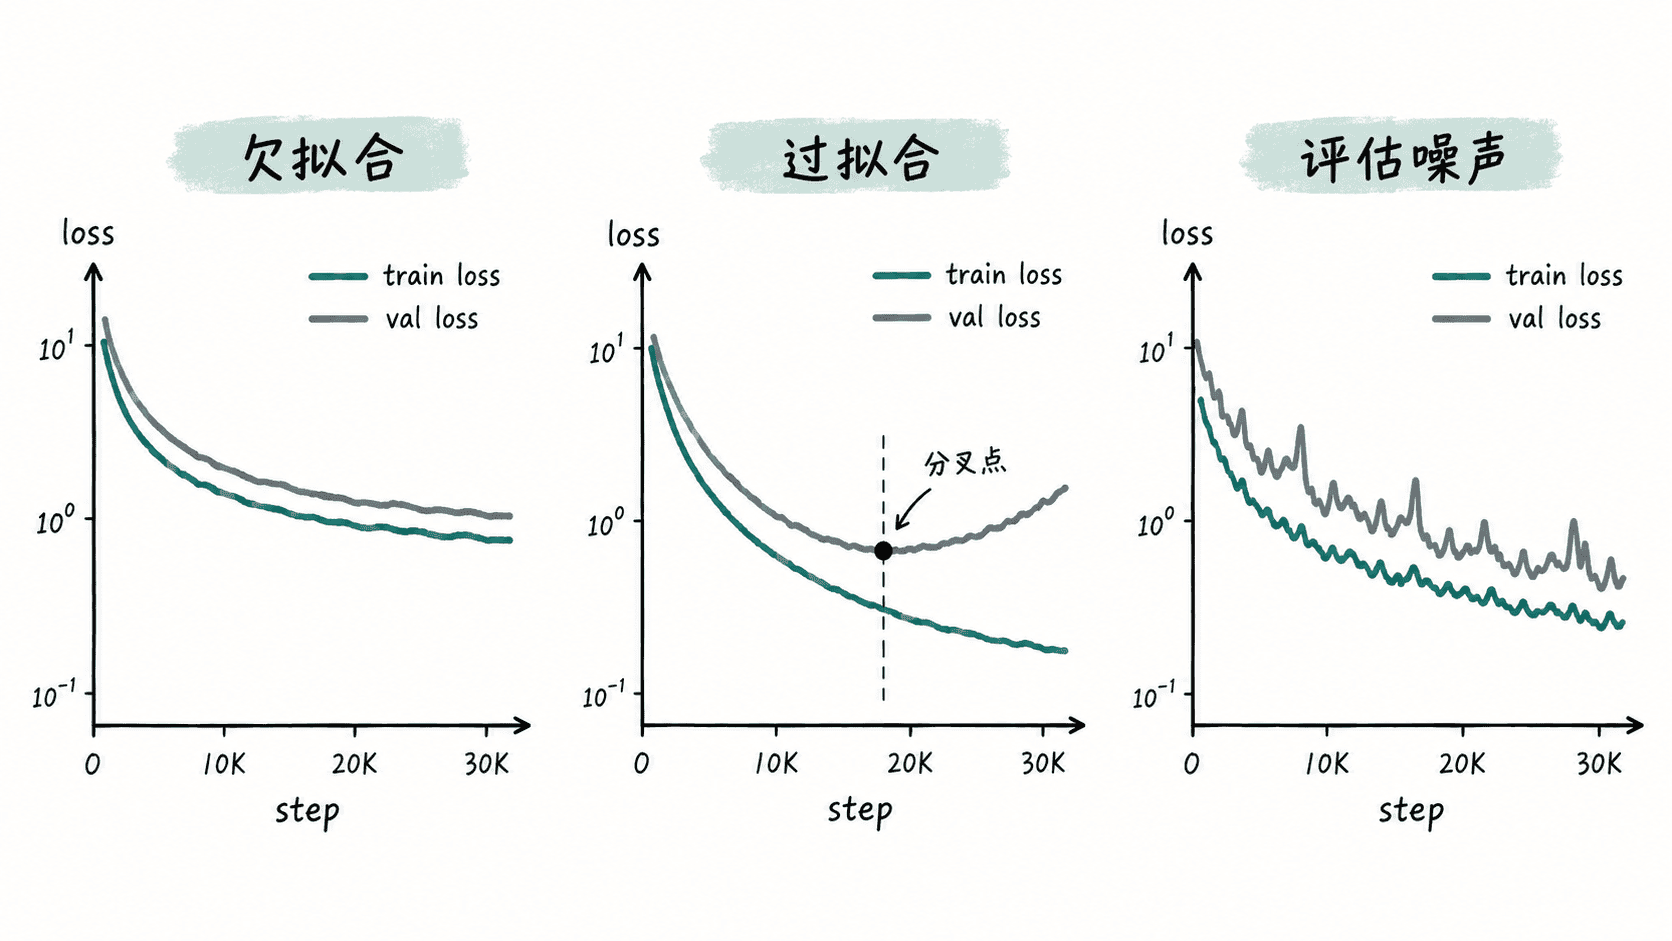
真正的过拟合是验证损失的趋势恶化,而不是某一次验证值高于上一次。只看相邻两个评估点,很容易把采样噪声误判成模型退化。
控制评估噪声与数据泄漏
eval_iters 越大,均值通常越稳定,但评估会占用更多训练时间。语料较小且显存允许时,可以遍历整个验证集;语料很大时,则应保持固定评估协议,例如固定采样种子、固定批次数和固定 block_size,再比较不同实验。
还要避免验证集泄漏。不能根据验证集反复改训练数据并继续把同一验证集当作“未知数据”;需要大量调参时,应保留独立测试集用于最终一次验收。对于 nanoGPT 实验,最有价值的记录不是某个瞬时 loss,而是同一评估协议下 train/val 曲线、最低 val loss 对应的 step,以及该 checkpoint 的完整配置。