
大模型原理与训练 / 系统课时
设计 Warmup 与余弦学习率
设计 Warmup 与余弦学习率
GPT 训练不能从第一步就用峰值学习率,也不适合始终保持固定学习率。本节实现一条可直接接入训练循环的 Warmup 与余弦衰减曲线,并从 loss 变化判断预热、峰值和衰减区间是否设置合理。
学习目标
- 实现 Warmup、余弦衰减和最低学习率组成的分段调度函数
- 正确把学习率调度绑定到参数更新步,而不是梯度累积的微批次
- 根据训练曲线识别预热不足、峰值过高和衰减过早等问题
把学习率看成训练状态变量
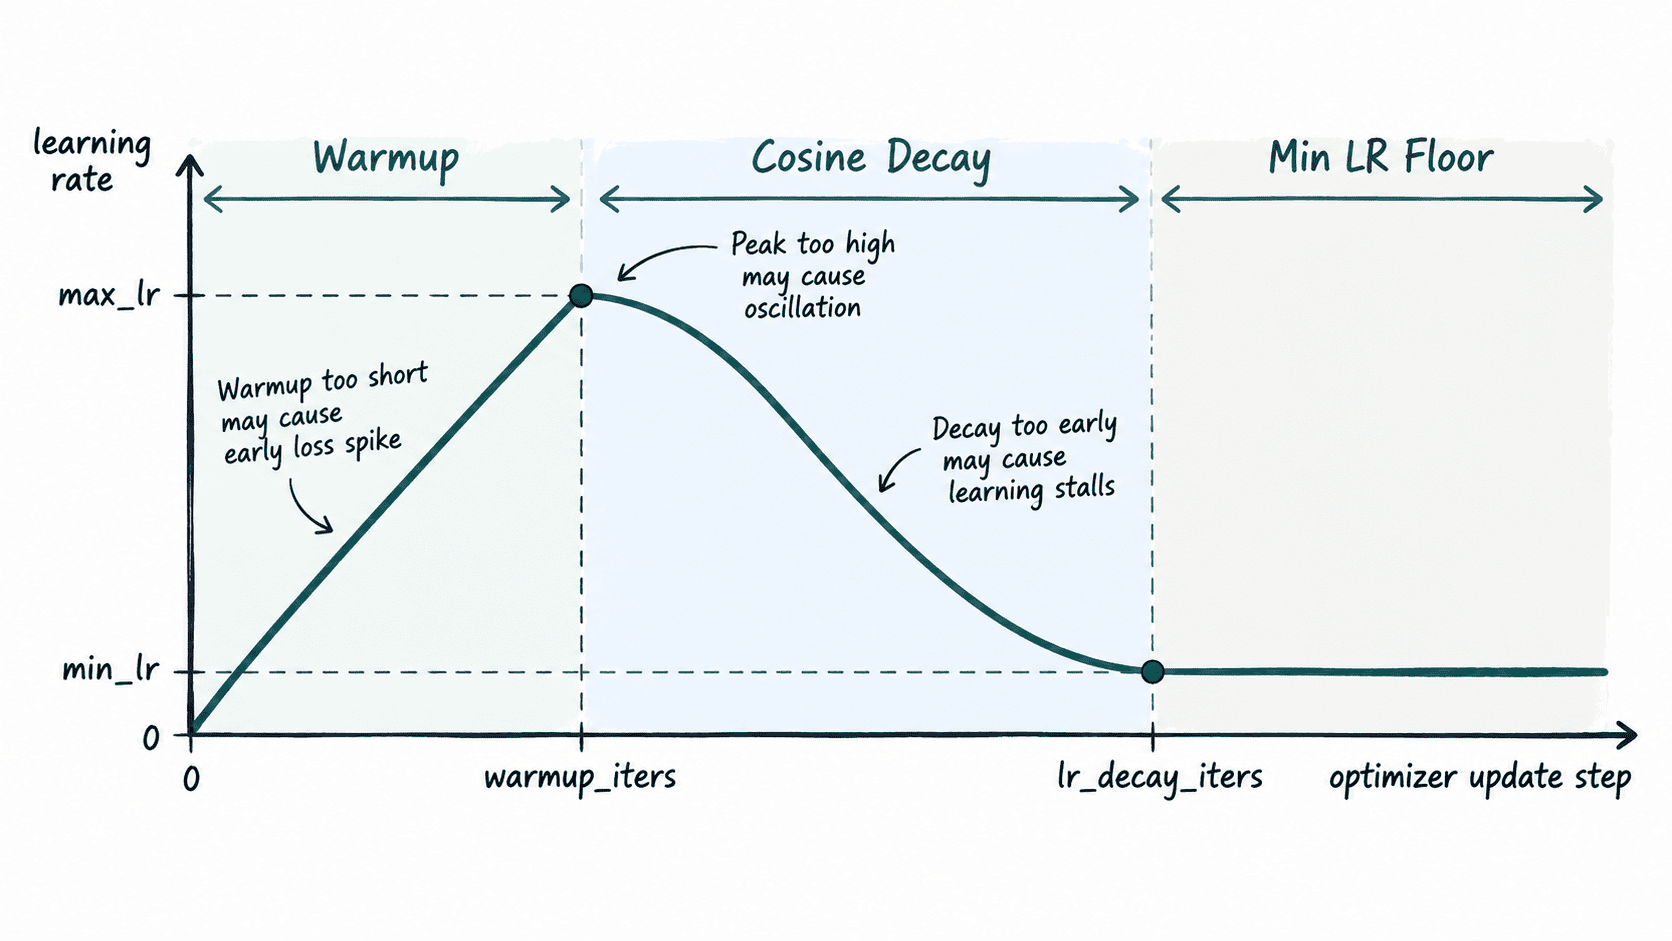
训练初期,模型参数还没有形成稳定的激活和梯度尺度。直接使用较大的峰值学习率,第一次更新就可能跨过合理区域,使 loss 剧烈振荡甚至出现非有限值。Warmup 的作用是让更新幅度在前若干步逐渐增加,而不是突然跳到峰值。
达到峰值以后,再长期保持高学习率会让参数不断在较优区域附近来回跳动。余弦衰减把学习率平滑降到 min_lr,使训练后半程逐步转向更细的参数调整,同时保留一个非零下限。
实现分段学习率函数
下面使用更新步 step 作为唯一输入。warmup_iters 之前线性升温;从 warmup_iters 到 lr_decay_iters 使用余弦函数衰减;超过衰减终点后保持 min_lr。
import math


def get_lr(
    step: int,
    warmup_iters: int = 10,
    lr_decay_iters: int = 100,
    max_lr: float = 6e-4,
    min_lr: float = 6e-5,
) -> float:
    if warmup_iters <= 0 or lr_decay_iters <= warmup_iters:
        raise ValueError("require 0 < warmup_iters < lr_decay_iters")

    # 前 warmup_iters 个更新步从 0 线性增加到峰值附近。
    if step < warmup_iters:
        return max_lr * step / warmup_iters

    if step >= lr_decay_iters:
        return min_lr

    # 把衰减区间归一化到 [0, 1],再映射到半个余弦周期。
    decay_ratio = (step - warmup_iters) / (lr_decay_iters - warmup_iters)
    coeff = 0.5 * (1.0 + math.cos(math.pi * decay_ratio))
    return min_lr + coeff * (max_lr - min_lr)


if __name__ == "__main__":
    for step in (0, 5, 10, 55, 100, 120):
        print(f"step={step:3d} lr={get_lr(step):.6f}")
预期输出:
step=  0 lr=0.000000
step=  5 lr=0.000300
step= 10 lr=0.000600
step= 55 lr=0.000330
step=100 lr=0.000060
step=120 lr=0.000060
step == warmup_iters 时刚好进入余弦区间,其归一化位置为 0,因此仍得到 max_lr。到达 lr_decay_iters 后则固定使用最低学习率,不再继续沿余弦曲线变化。
接入参数更新循环
调度器应跟随真正的 optimizer update 前进。若一次参数更新由多个 micro-batch 累积得到,却在每个 micro-batch 都增加调度步数,学习率会比预期快数倍完成 Warmup 和衰减。
片段示例:下面假定 optimizer 已创建,并且前面的 get_lr 已定义;update_step 只在一次完整参数更新后增加。
lr = get_lr(update_step)
for param_group in optimizer.param_groups:
    param_group["lr"] = lr

# 完成当前累积批次的 backward 后再执行 optimizer.step()。
optimizer.step()
optimizer.zero_grad(set_to_none=True)
update_step += 1
这段代码生效后,可以在训练日志中同时记录 update_step、lr 和 loss。检查 Warmup 结束点以及衰减结束点附近的日志值,应当分别接近 max_lr 与 min_lr。
从训练曲线反推配置问题
Warmup 太短或根本没有 Warmup 时,典型信号集中在最初若干次更新:loss 突然升高、梯度范数出现尖峰,混合精度训练还可能连续跳过参数更新。此时仅降低最终的 min_lr 没有意义,应先处理训练开头的更新幅度。
如果 Warmup 已经平稳结束,但随后 loss 持续大幅上下振荡,优先怀疑 max_lr 过高。相反,如果训练刚进入余弦区间不久,loss 就明显变平,而梯度和数值状态都正常,则可能是 lr_decay_iters 太小,使学习率过早下降。
min_lr 决定训练尾部还能保留多少更新能力。它过高时,后期可能一直围绕较优点振荡;过低且很早到达时,参数更新又可能小到几乎停滞。判断时应同时观察训练 loss、验证 loss 和实际记录的学习率,而不是只凭某一个最终指标调整参数。
一条可靠的学习率曲线应与实际参数更新次数采用同一计数口径:先用 Warmup 控制训练启动阶段的风险,再用余弦衰减逐步减小更新幅度,最后由 min_lr 保留可控的尾部学习能力。