
大模型原理与训练 / 系统课时
用残差连接稳定深层训练
用残差连接稳定深层训练
这一节把注意力与 MLP 接到残差路径上,并用一次反向传播验证输入仍能收到梯度。完成后,你会看清 Transformer Block 中两次 x + branch(x) 的作用,以及为什么堆叠很多层时不能只依赖普通串联。
学习目标
- 实现注意力子层和 MLP 子层的两条残差路径
- 理解恒等路径如何帮助信息与梯度跨层传播
- 判断残差相加时必须满足的形状与尺度条件
残差连接解决什么问题
如果网络只把每层输出直接交给下一层,深度增加后,信息和梯度都必须连续穿过每个非线性变换。任何一层只要把信号压得过小、放得过大或映射到不利于优化的区域,后面的层都会受到影响。
残差连接把一个子层改写为 y = x + F(x)。其中 F(x) 是注意力或 MLP 计算,x 则沿恒等路径直接送到输出。于是子层不必重新学习完整表示,而可以专注于学习“在当前表示上需要增加什么修正”。
从反向传播看,加法也提供了一条直接路径。梯度除了经过 F 的参数和非线性,还可以沿着恒等分支继续向前传播。这并不意味着梯度永远不会衰减或爆炸,但会显著降低深层网络必须连续穿越所有复杂变换的压力。
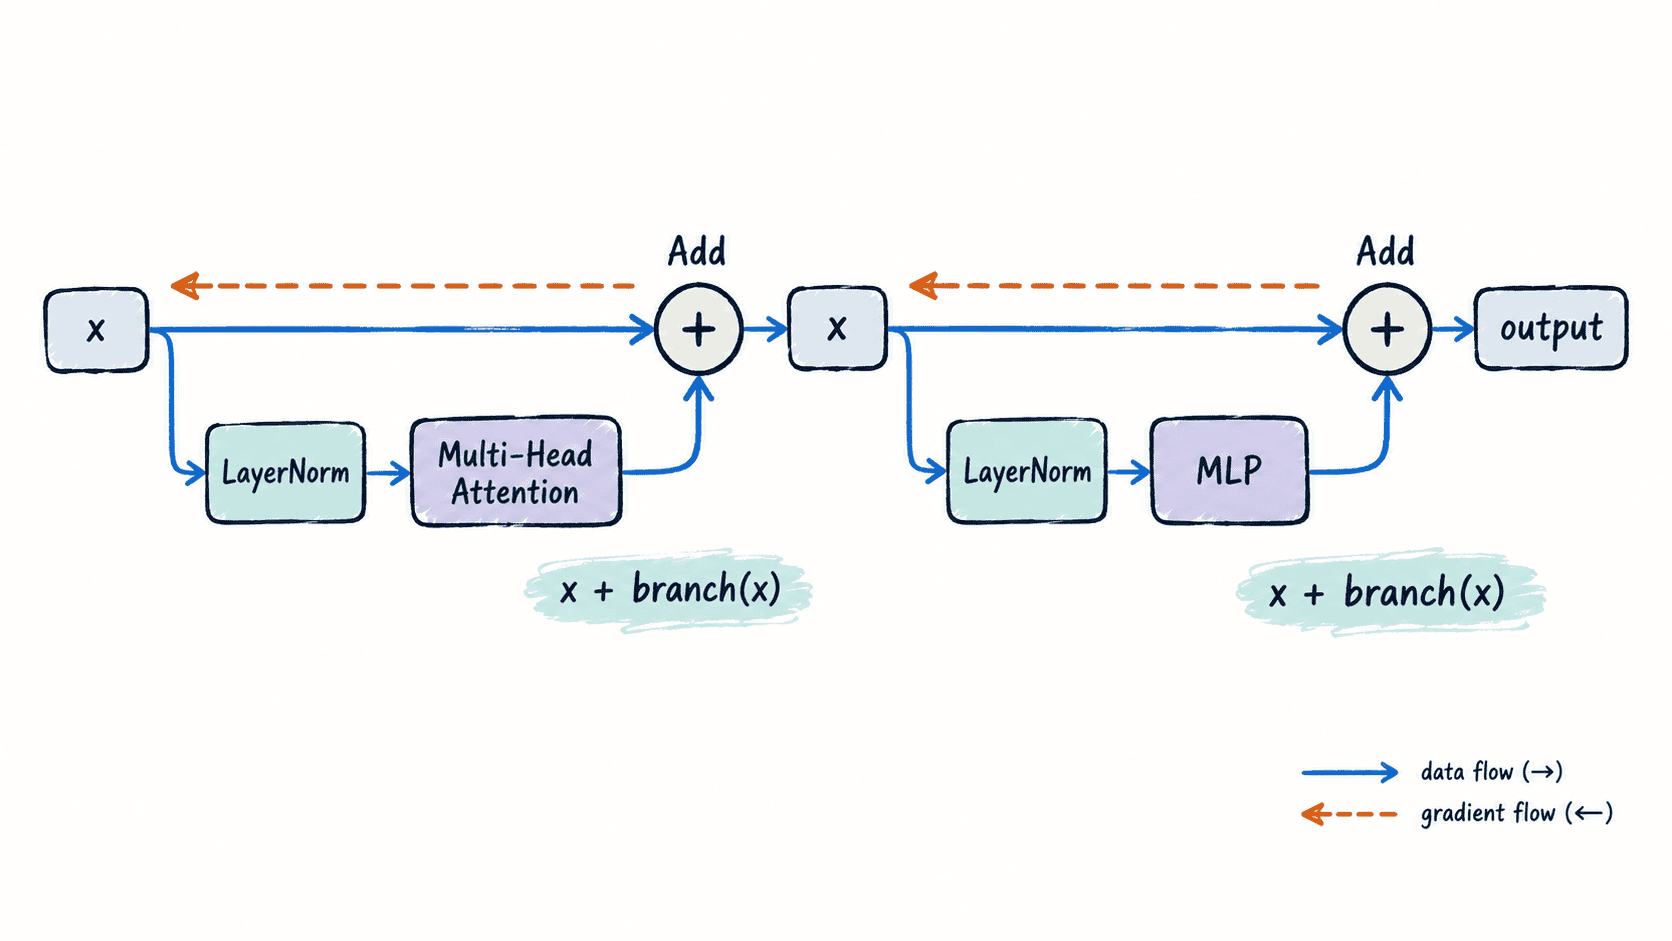
把注意力和 MLP 接入残差路径
nanoGPT 风格的 Block 通常包含两次残差相加。注意力负责让 token 交换信息,MLP 负责逐 token 进行非线性变换;两者都只生成对当前表示的增量,然后与原表示相加。
下面的最小示例使用 PyTorch 的 MultiheadAttention 和两层 MLP,并堆叠 6 个 Block。输入张量显式开启梯度,最后检查反向传播后最早的输入是否仍得到有限且非零的梯度。
import torch
from torch import nn

class ResidualBlock(nn.Module):
    def __init__(self, n_embd: int, n_head: int):
        super().__init__()
        self.ln1 = nn.LayerNorm(n_embd)
        self.attn = nn.MultiheadAttention(
            embed_dim=n_embd,
            num_heads=n_head,
            batch_first=True,
        )
        self.ln2 = nn.LayerNorm(n_embd)
        self.mlp = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.GELU(),
            nn.Linear(4 * n_embd, n_embd),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # 注意力只产生增量,原始 x 通过残差支路直接保留。
        h = self.ln1(x)
        attn_out, _ = self.attn(h, h, h, need_weights=False)
        x = x + attn_out

        # MLP 也必须投影回 n_embd,才能与残差张量逐元素相加。
        x = x + self.mlp(self.ln2(x))
        return x

torch.manual_seed(0)
x = torch.randn(2, 4, 8, requires_grad=True)
model = nn.Sequential(*(ResidualBlock(8, 2) for _ in range(6)))

y = model(x)
loss = y.square().mean()
loss.backward()

print("output shape:", tuple(y.shape))
print("input grad finite:", bool(torch.isfinite(x.grad).all()))
print("input grad nonzero:", bool((x.grad.abs() > 0).any()))
预期输出
output shape: (2, 4, 8)
input grad finite: True
input grad nonzero: True
这个检查不能证明任意深度都一定训练稳定,但它验证了 Block 保持输入输出形状一致,并且梯度能够从损失传播回最初的输入。
为什么残差分支必须保持形状一致
执行 x + attn_out 或 x + mlp_out 时,两边需要表达同一批 token 的同一隐藏维度。在 GPT 中,Block 的输入通常是 [B, T, C],因此注意力与 MLP 最终也都要返回 [B, T, C]。
注意力内部可以拆成多个 head,MLP 中间层也常扩展到约 4 * C,但这些变化必须在残差相加前重新合并或投影回 C。否则不仅无法逐元素相加,也破坏了“每个 Block 都保持统一接口”的设计,使网络无法简单堆叠。
残差连接不是跳过子层
恒等路径保留旧表示,子层仍然负责计算新的增量。训练初期即使某个子层还没有学到有效变换,网络也有机会维持接近原输入的表示;随着优化推进,注意力和 MLP 再逐渐学习有用的修正。
因此,一个 GPT Block 的核心形态不是“注意力之后再接 MLP”这么简单,而是两次“保留旧表示,再叠加新信息”。残差连接与后续的 LayerNorm、合理初始化共同工作,才让很多 Block 可以稳定地连续堆叠。