
大模型原理与训练 / 系统课时
用编译优化减少执行开销
用编译优化减少执行开销
模型计算量没有变化时,Python 调度、算子启动和大量细粒度操作仍可能消耗可观时间。torch.compile() 可以尝试把 eager 执行中的一段 PyTorch 程序捕获并编译成更紧凑的执行图。本节通过同一模型比较 eager 与 compiled 路径,同时识别首次编译、动态形状和图中断这些常见边界。
学习目标
- 理解 eager 执行与
torch.compile()编译执行的核心差异 - 正确区分首次编译成本与稳定运行阶段的耗时
- 识别动态形状、graph break 和不支持操作对编译收益的影响
编译路径改变了什么
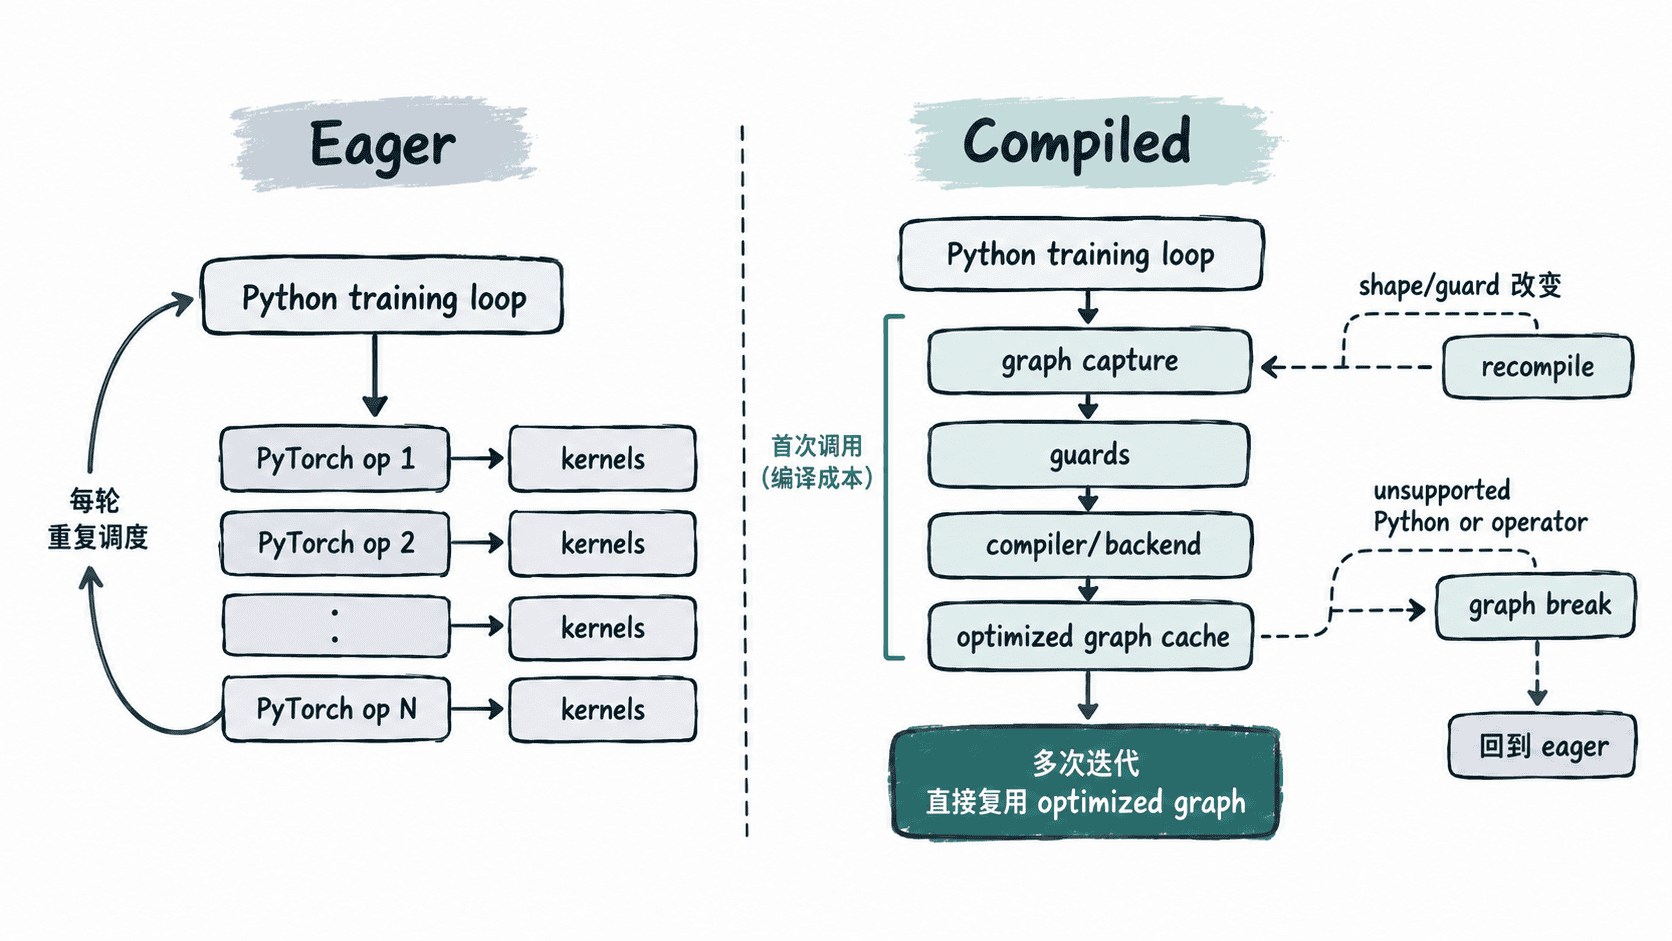
Eager 模式按照 Python 程序的实际执行顺序逐个调度操作,优点是直观、调试方便。torch.compile() 则在调用模型时尝试捕获可编译区域,根据输入和运行条件建立执行图,再交给后端生成优化后的实现。后续满足相同约束的调用可以复用已编译结果,从而减少重复的 Python 与算子调度开销。
这意味着编译优化天然分成两个阶段:第一次遇到某种执行路径时需要捕获、分析和编译,成本可能明显高于 eager;编译结果缓存后,后续迭代才有机会体现稳定阶段的收益。因此不能只测第一次调用就判断编译是否有效。
比较 eager 与 compiled 模型
下面的程序创建相同模型,并先验证 compiled 输出与 eager 输出一致,再分别做预热和稳定阶段计时。若存在 CUDA,会在计时边界执行同步,避免只测到异步提交命令的时间。
import time
import torch


class TinyMLP(torch.nn.Module):
    def __init__(self, width: int = 256):
        super().__init__()
        self.net = torch.nn.Sequential(
            torch.nn.Linear(width, width * 4),
            torch.nn.GELU(),
            torch.nn.Linear(width * 4, width),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.net(x)


def sync(device: torch.device) -> None:
    if device.type == "cuda":
        torch.cuda.synchronize()


def benchmark(model, x, iterations: int = 50) -> float:
    sync(x.device)
    start = time.perf_counter()
    with torch.no_grad():
        for _ in range(iterations):
            model(x)
    sync(x.device)
    return (time.perf_counter() - start) * 1000 / iterations


torch.manual_seed(7)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = TinyMLP().to(device).eval()
x = torch.randn(64, 256, device=device)

with torch.no_grad():
    eager_output = model(x)

compiled_model = torch.compile(model)

# 首次调用会触发捕获和编译,不把它混入稳定阶段计时。
with torch.no_grad():
    compiled_output = compiled_model(x)
    for _ in range(3):
        compiled_model(x)

same_result = torch.allclose(eager_output, compiled_output, atol=1e-5, rtol=1e-4)
eager_ms = benchmark(model, x)
compiled_ms = benchmark(compiled_model, x)

print(f"device={device.type}")
print(f"same_result={same_result}")
print(f"eager_avg_ms={eager_ms:.3f}")
print(f"compiled_avg_ms={compiled_ms:.3f}")
预期输出的数值会随设备、PyTorch 版本和硬件负载变化,结构应类似:
device=<DEVICE>
same_result=True
eager_avg_ms=<TIME>
compiled_avg_ms=<TIME>
<DEVICE> 通常是 cpu 或 cuda,两个 <TIME> 是本机实测毫秒数。编译版本不保证在所有模型和设备上都更快,所以这里不预设两者的大小关系。
首次编译不能算进稳态吞吐
如果训练脚本启动后只运行很少几步,编译成本可能根本来不及摊薄。评估 nanoGPT 这类长时间训练任务时,至少应把第一次触发编译的迭代视为预热阶段,再单独统计后续几十或几百个稳定 step 的平均时间或 tokens/s。
还要保证比较条件一致:输入形状、精度模式、设备、是否执行反向传播以及同步方式都必须相同。只比较 eager 的完整训练 step 与 compiled 的单纯前向传播,会得到没有意义的数字。
动态形状和图中断会削弱收益
编译结果依赖一组运行时约束。输入形状或某些 Python 条件变化后,如果已有编译图的 guard 不再满足,就可能需要生成新的图。训练过程中频繁改变序列长度、batch shape 或走不同控制分支,会增加重新编译和缓存管理成本。
Graph break 则意味着编译器无法把某段程序继续保留在同一张图中,只能在边界处退出编译区域,再从 eager 执行接回去。少量 graph break 未必会让编译失去价值,但如果核心 forward 被切成大量小区域,减少调度开销和融合算子的空间都会缩小。
编译优化的验收标准不是“成功调用了 torch.compile()”,而是在相同数值结果和训练条件下,预热之后的稳定 step 时间或吞吐确实改善,并且没有因形状变化、重复编译或 graph break 把收益重新消耗掉。