
大模型原理与训练 / 系统课时
用混合精度降低显存与耗时
用混合精度降低显存与耗时
混合精度训练的目标不是把所有张量简单改成半精度,而是让适合低精度的矩阵计算使用 FP16 或 BF16,同时保留对数值范围敏感的计算路径。本节给出一套可直接运行的 PyTorch AMP 写法,并说明不同精度的边界。
学习目标
- 能区分 FP32、FP16、BF16 在数值范围、精度和稳定性上的差异。
- 能使用
autocast和GradScaler写出正确的单步训练代码。 - 能根据 CUDA 设备能力选择 BF16 或 FP16,并验证显存、速度与 loss 是否正常。
先区分 FP32、FP16 与 BF16
| 格式 | 数值范围与精度特征 | 训练中的典型用法 |
|---|---|---|
| FP32 | 范围大、有效精度高 | 参数与优化器状态的稳定基线 |
| FP16 | 范围明显更窄,但尾数精度高于 BF16 | 高吞吐矩阵计算,通常配合梯度缩放 |
| BF16 | 指数范围接近 FP32,但尾数精度更低 | 支持 BF16 的硬件上常作为 AMP 首选 |
FP16 最容易遇到的问题不是前向结果“少几位小数”,而是很小的梯度下溢为 0,或很大的中间值溢出。BF16 保留了与 FP32 相近的指数范围,因此通常不需要 GradScaler,代价是有效尾数更短。
AMP 的正确数据流
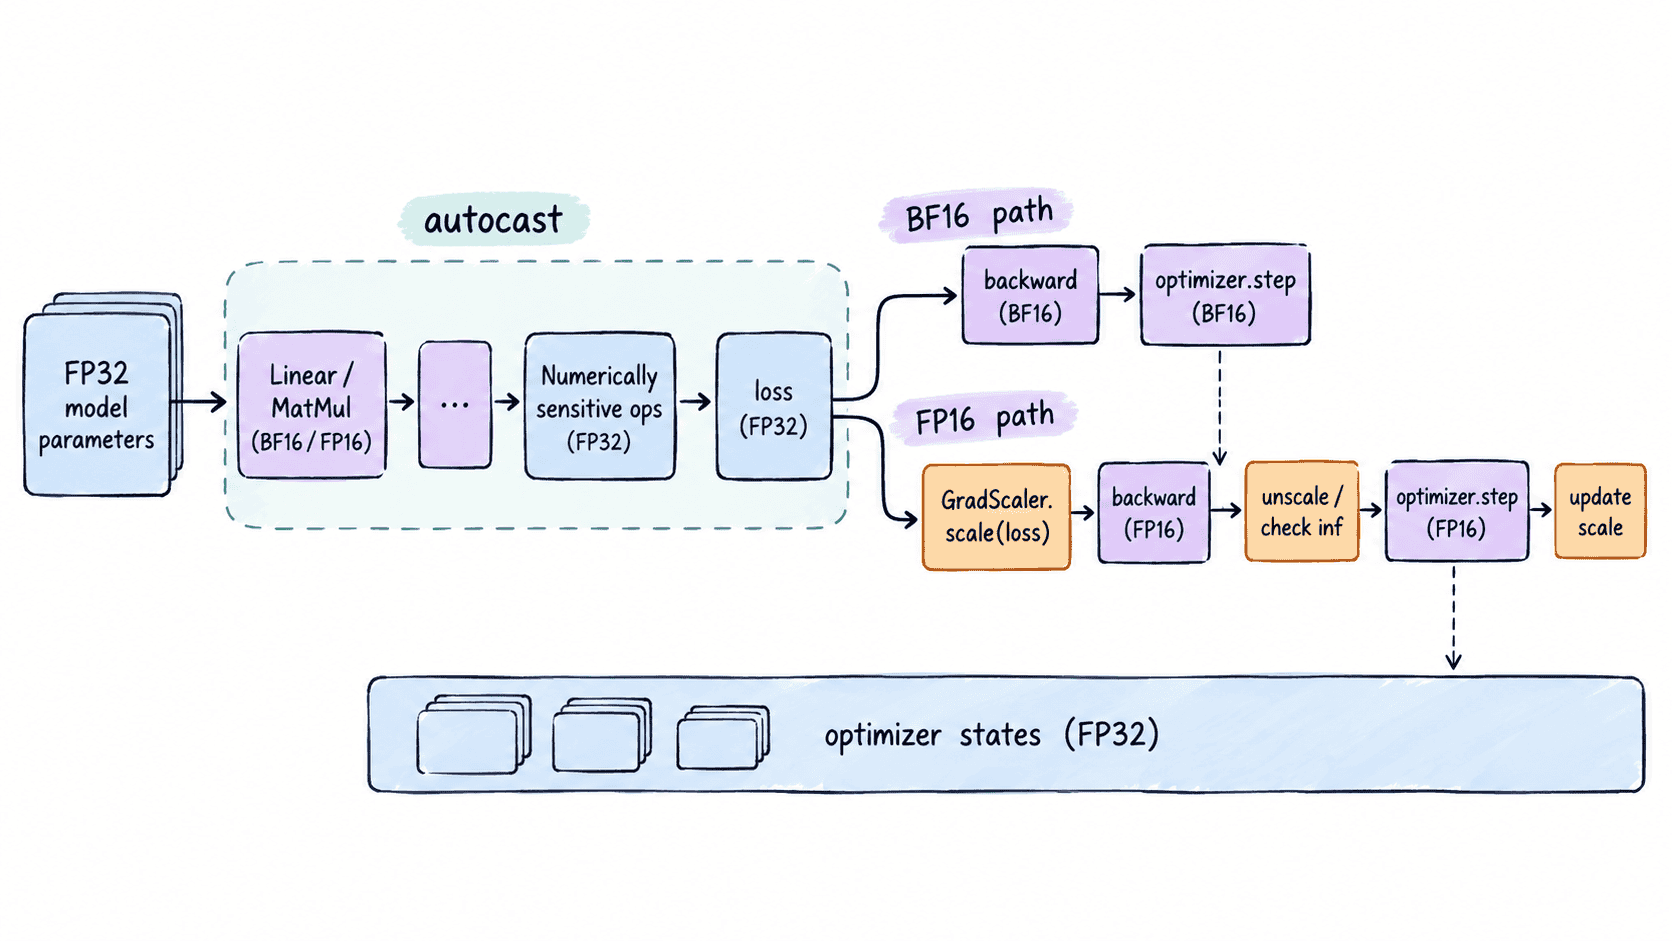
一次训练 step 可以看成“FP32 参数 → autocast 选择低精度算子 → loss → 反向传播 → 优化器更新”。当使用 FP16 时,再在 loss 与 backward 之间插入梯度缩放,避免小梯度过早下溢。
写一个可运行训练步
下面的示例会优先选择 CUDA BF16;若 GPU 不支持 BF16,则退到 FP16 并启用 GradScaler;没有 CUDA 时保持 FP32,这样代码仍能在 CPU 上完成一次训练。
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)

class TinyLM(nn.Module):
    def __init__(self, vocab_size: int = 128, n_embd: int = 64):
        super().__init__()
        self.token_embedding = nn.Embedding(vocab_size, n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx: torch.Tensor) -> torch.Tensor:
        return self.lm_head(self.token_embedding(idx))

device = "cuda" if torch.cuda.is_available() else "cpu"

if device == "cuda":
    use_amp = True
    if torch.cuda.is_bf16_supported():
        amp_dtype = torch.bfloat16
        use_scaler = False
    else:
        amp_dtype = torch.float16
        use_scaler = True
else:
    use_amp = False
    amp_dtype = torch.float32
    use_scaler = False

model = TinyLM().to(device)
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
x = torch.randint(0, 128, (8, 32), device=device)
y = torch.randint(0, 128, (8, 32), device=device)

optimizer.zero_grad(set_to_none=True)

with torch.autocast(device_type=device, dtype=amp_dtype, enabled=use_amp):
    logits = model(x)
    loss = F.cross_entropy(logits.reshape(-1, 128), y.reshape(-1))

if use_scaler:
    scaler = torch.amp.GradScaler("cuda")
    scaler.scale(loss).backward()
    scaler.step(optimizer)
    scaler.update()
else:
    loss.backward()
    optimizer.step()

print(
    f"device={device}, amp={use_amp}, dtype={amp_dtype}, "
    f"scaler={use_scaler}, loss={loss.item():.4f}"
)
预期输出
device=cuda, amp=True, dtype=torch.bfloat16, scaler=False, loss=<LOSS><LOSS> 会随设备和底层 kernel 略有差异。如果 CUDA GPU 不支持 BF16,预期会看到 dtype=torch.float16, scaler=True;没有 CUDA 时则会看到 device=cpu, amp=False, dtype=torch.float32。三种路径都应完成一次前向、反向和参数更新,而不是只做 dtype 检测。
FP16 为什么需要 GradScaler
反向传播中的梯度可能比前向激活小很多。FP16 的最小可表达范围有限,直接 backward 时,一批本应存在的小梯度可能被舍入为 0。GradScaler 会先把 loss 乘一个动态 scale,再执行 backward;在优化器更新前再把梯度还原,并检查是否出现 inf 或 nan。
如果发生溢出,scaler 可以跳过这次更新并降低 scale;连续稳定后又可以逐步调高。这就是为什么 FP16 AMP 应把 scale → backward → step → update 当成一个完整流程,而不是只包一层 autocast。
判断混合精度是否真的有效
比较 FP32 与 AMP 时要保持 batch、序列长度、优化器和数据一致,并先做若干 warmup step。CUDA 计时时应在测量边界调用同步,否则 CPU 提交 kernel 的时间会掩盖真实 GPU 执行时间;显存则比较同一阶段的峰值 allocated memory,而不是只看任务管理器中的进程占用。
还要同时观察 loss 曲线和非有限值。若 AMP 更快但频繁出现 nan,或者 FP16 的 scaler 持续下降,说明当前配置并未稳定。BF16 可用时通常先尝试 BF16;只能使用 FP16 时保留 GradScaler,并在修改学习率、batch 或模型规模后重新验证。
混合精度最常降低的是激活和高吞吐矩阵算子的存储与计算成本,FP32 参数与 AdamW 状态仍可能占据很大一部分显存。因此是否能把 batch 放大一倍,最终应由实测峰值显存和稳定吞吐决定,而不是按“16 位等于显存减半”来推断。