
大模型原理与训练 / 系统课时
用内存映射随机读取训练片段
用内存映射随机读取训练片段
预训练语料可能远大于机器内存,不能在启动时把整个 train.bin 读进 RAM。本节使用 NumPy memmap 把二进制 token 文件映射到虚拟地址空间,只按随机采样位置访问所需片段,并同时实现训练集与验证集的定长 batch 采样。
学习目标
- 使用 memory mapping 打开大规模 token 文件,而不是一次性加载全部数据
- 正确采样长度为
block_size的输入和右移一位的训练目标 - 为训练集与验证集复用采样逻辑,并处理文件长度、dtype 等边界条件
memory mapping 改变了什么
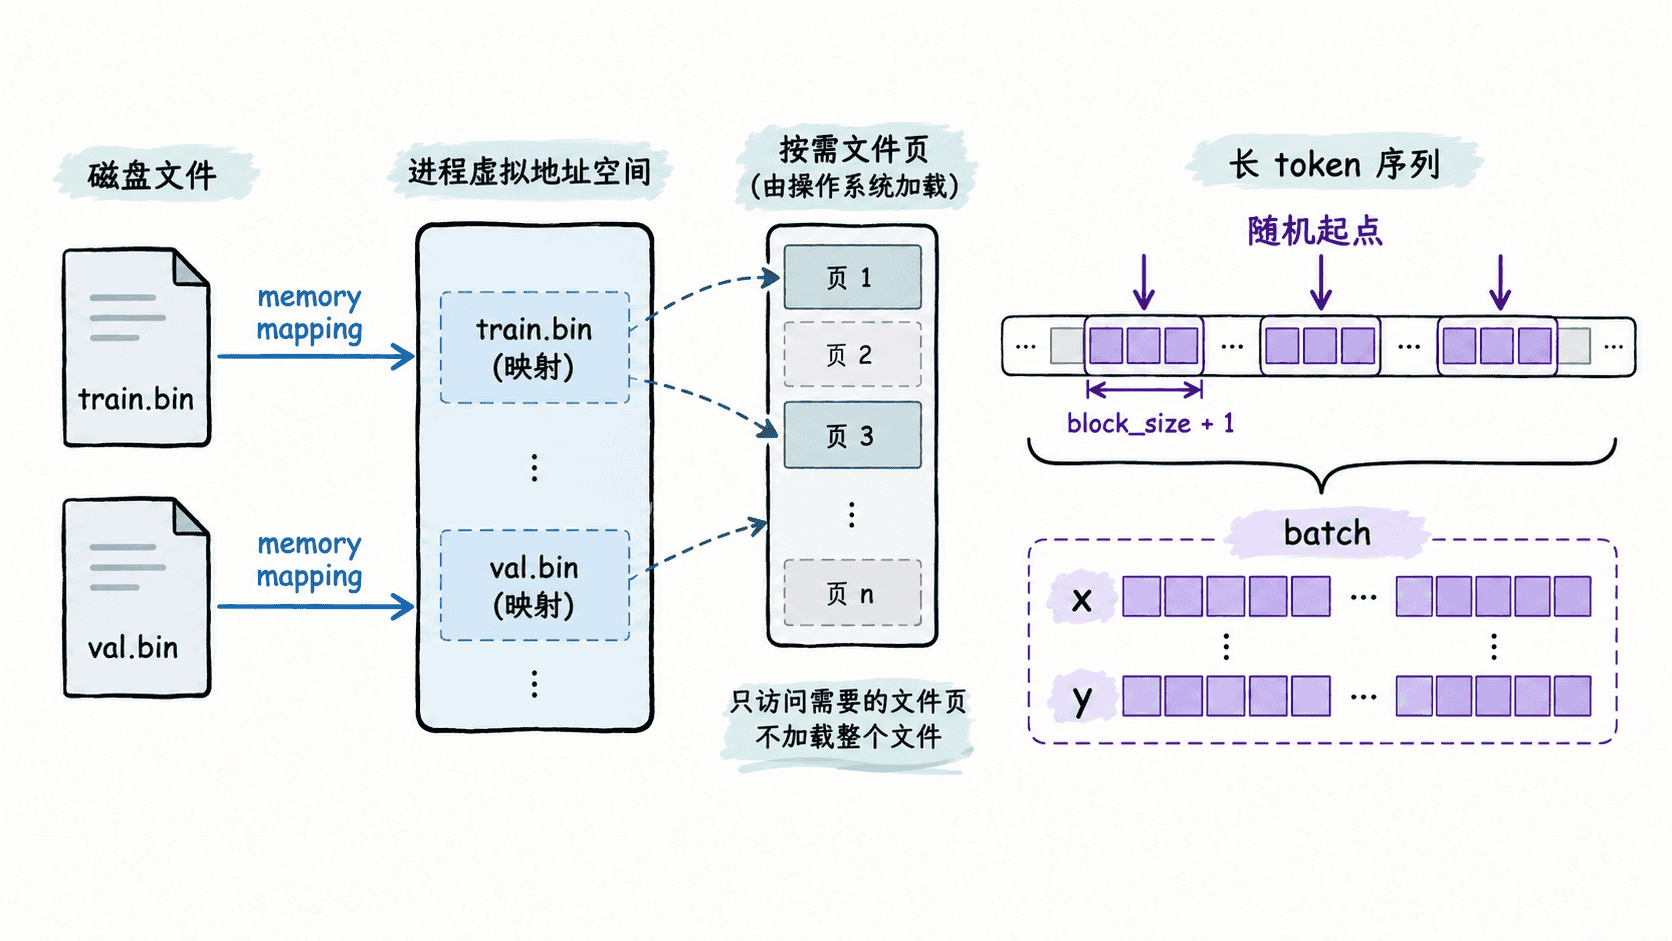
普通的 np.fromfile 会把整个文件读成内存数组;np.memmap 则建立文件与进程虚拟地址空间之间的映射。代码看起来仍然可以像数组一样切片,但操作系统会按访问需求把相关文件页带入内存,因此文件规模不必受可用 RAM 的直接限制。
它并不表示“完全不占内存”。被访问的数据页会进入物理内存和操作系统页缓存,而训练 batch 转成更适合模型计算的整数类型时也会产生小范围复制。关键区别在于无需为整个语料提前分配等量内存。
实现随机 batch 采样
下面的程序会自行创建两个演示二进制文件,因此可以独立运行。实际训练时删除 create_demo_data 调用,直接让相同读取逻辑指向预处理得到的 train.bin 和 val.bin 即可。示例需要 Python 3 和 NumPy,保存为 sample_memmap.py 后执行 python sample_memmap.py。
from pathlib import Path
import numpy as np

BLOCK_SIZE = 8
BATCH_SIZE = 4
RNG = np.random.default_rng(42)


def create_demo_data() -> None:
    # 仅为独立演示生成数据;正式训练直接使用预处理后的文件。
    np.arange(4096, dtype='<u2').tofile('train.bin')
    np.arange(1024, dtype='<u2').tofile('val.bin')


def open_split(split: str) -> np.memmap:
    path = Path(f'{split}.bin')
    return np.memmap(path, dtype='<u2', mode='r')


def get_batch(split: str) -> tuple[np.memmap, np.ndarray, np.ndarray]:
    data = open_split(split)
    if len(data) < BLOCK_SIZE + 1:
        raise ValueError(f'{split}.bin 至少需要 {BLOCK_SIZE + 1} 个 token')

    # 上界保证每个起点之后还存在 block_size+1 个 token。
    starts = RNG.integers(0, len(data) - BLOCK_SIZE, size=BATCH_SIZE)
    x = np.stack([
        np.asarray(data[i:i + BLOCK_SIZE], dtype=np.int64)
        for i in starts
    ])
    y = np.stack([
        np.asarray(data[i + 1:i + 1 + BLOCK_SIZE], dtype=np.int64)
        for i in starts
    ])
    return data, x, y


def main() -> None:
    create_demo_data()
    for split in ('train', 'val'):
        data, x, y = get_batch(split)
        shifted = np.array_equal(x[:, 1:], y[:, :-1])
        print(f'{split} mapped: {type(data).__name__}, tokens={len(data)}')
        print(f'{split} x/y: {x.shape}/{y.shape}, shift={shifted}')


if __name__ == '__main__':
    main()
预期输出
train mapped: memmap, tokens=4096
train x/y: (4, 8)/(4, 8), shift=True
val mapped: memmap, tokens=1024
val x/y: (4, 8)/(4, 8), shift=True这里不打印随机起点,因此输出与随机采到哪一段无关。shift=True 验证了监督目标确实比输入向右移动一个 token:模型在 x 的每个位置上学习预测 y 对应位置的下一个 token。
随机起点必须留出一个目标 token
一个长度为 block_size 的输入实际上需要访问 block_size + 1 个连续 token。若起点为 ,输入范围是从 到 ,目标则从 到 。因此最后一个合法起点必须保证目标序列不会越过文件末尾。
示例中的 RNG.integers(0, len(data) - BLOCK_SIZE, ...) 使用右开区间,恰好让最大随机起点停在合法位置。文件少于 block_size + 1 个 token 时则直接报错,比在深层训练代码中得到难以定位的空切片更安全。
训练集与验证集保持物理隔离
训练和验证可以共用完全相同的采样函数,但应映射不同文件。训练步骤从 train.bin 随机取 batch,评估步骤临时切换到 val.bin;这样不会因为随机位置计算错误而跨过逻辑切分边界,也无需在每次采样时判断某个 token 属于哪个集合。
读取 dtype 必须与预处理写入时完全一致。若文件按小端 uint16 写入,就应使用 dtype='<u2' 映射;把同一字节序列误读成 uint32 或其他字节序会改变 token ID,通常不会立刻抛异常,却会让训练数据整体失真。
接入真正的训练循环
进入模型前,通常只需把当前 batch 转成框架需要的整数张量并移动到训练设备。这个转换只复制当前采样到的少量 token,而不是整个二进制文件。随着训练持续随机访问,操作系统页缓存还可能复用近期数据页,使顺序预处理得到的简单文件格式同时具备低内存占用和足够高的随机读取效率。
因此,大语料不需要“先装进内存再训练”。保持磁盘上的连续 token 流,使用只读 memmap 建立映射,再按 block_size + 1 随机切片,就能为训练集和验证集稳定地产生下一 token 预测所需的 batch。